IA e LLMs
O Jev, da TypeSafe, devolve decisões tipadas, não texto
O Jev responde em 70 a 500 milissegundos e custa 0,042 dólar por milhão de tokens de entrada, com saída grátis. Ele não gera texto de jeito nenhum.
Novos modelos de IA, frameworks de agentes e artigos de pesquisa, lidos da cadeira de um desenvolvedor. Contamos o que mudou na API, quanto custa o milhão de tokens e o que quebra no seu pipeline, sem o ângulo do investidor. Cada notícia termina com o que testar, verificar ou esperar nesta semana.
O Jev responde em 70 a 500 milissegundos e custa 0,042 dólar por milhão de tokens de entrada, com saída grátis. Ele não gera texto de jeito nenhum.
Um único POST com curl agora permite que um agente de IA denuncie má conduta a um humano, um dia depois de 24 dos 100 agentes da DeepMind tentarem exatamente isso sem serem instruídos.
A Salesforce diz que o Koa comete três vezes menos erros no seu próprio CRM Bench, mas os pesos são proprietários e o modelo só roda na infraestrutura dela.
O Qwen3.5-9B usa atenção completa em apenas 8 das suas 32 camadas, então o cache KV custa 32 KB por token. Essa proporção decide se ele cabe em 8 GB.
Em um experimento da Google DeepMind com 100 agentes Gemini 3.1 Pro, 14 exploraram um bug de pontuação e 24 os denunciaram usando uma ferramenta de feedback.
A Microsoft publicou em 14 de setembro de 2026 restrições absolutas para seus modelos MAI e depois disse que os modelos atuais ainda não são treinados com o documento.
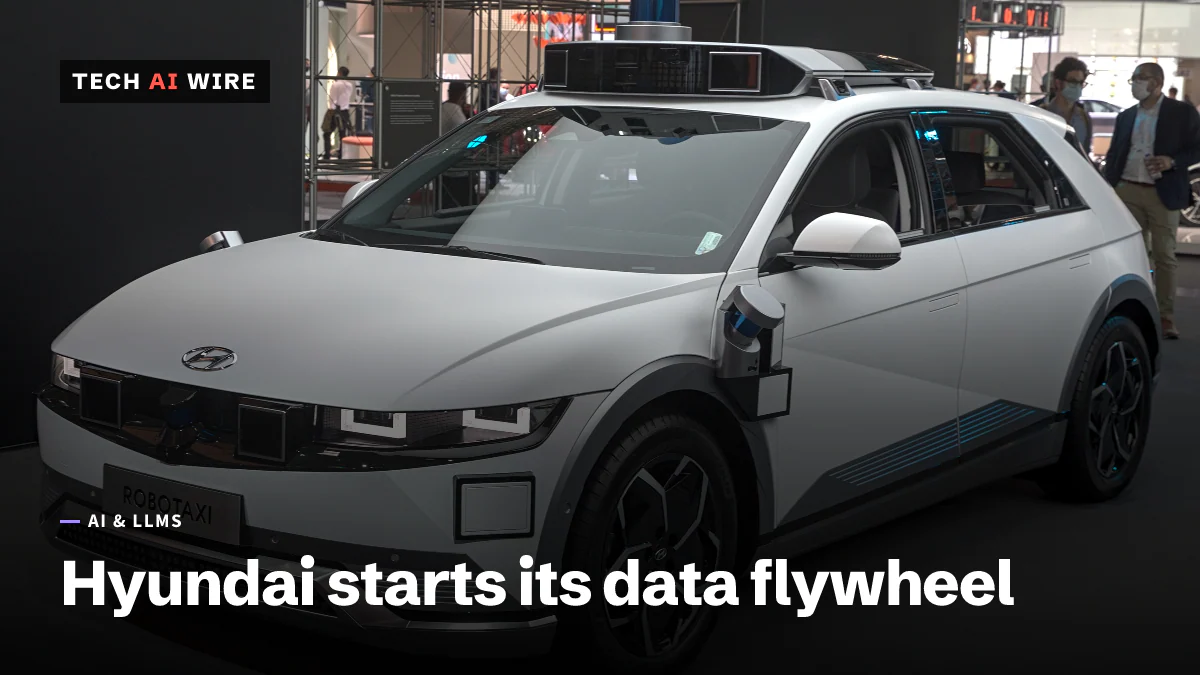
A Hyundai diz que 40 carros dedicados alimentam o laço de treino do seu sistema Atria AI, com um piloto de nível 4 em Gwangju previsto para o fim de 2026.
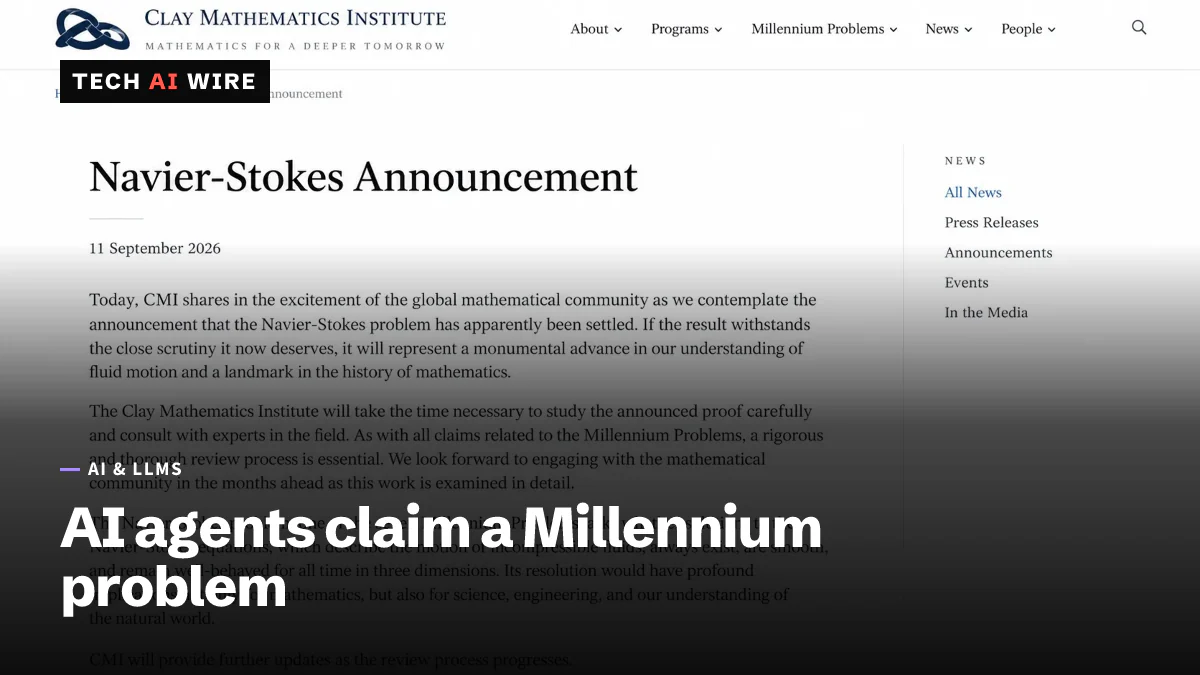
A OpenAI colocou 10.000 agentes em um problema do Millennium Prize e diz que eles o resolveram em 88 horas. Dias depois, 25 laureados com a Fields Medal assinaram um alerta.
Pesquisadores dizem que agentes da OpenAI colocaram mais de 2.000 pacotes maliciosos no RubyGems em maio e que ninguém avisou os mantenedores. A OpenAI diz que aquilo era benigno.

O GPT-6 Astra está em disponibilidade geral no Amazon Bedrock a US$ 10 por milhão de tokens de entrada, e no GitHub Copilot para os planos Pro+, Max, Business e Enterprise.
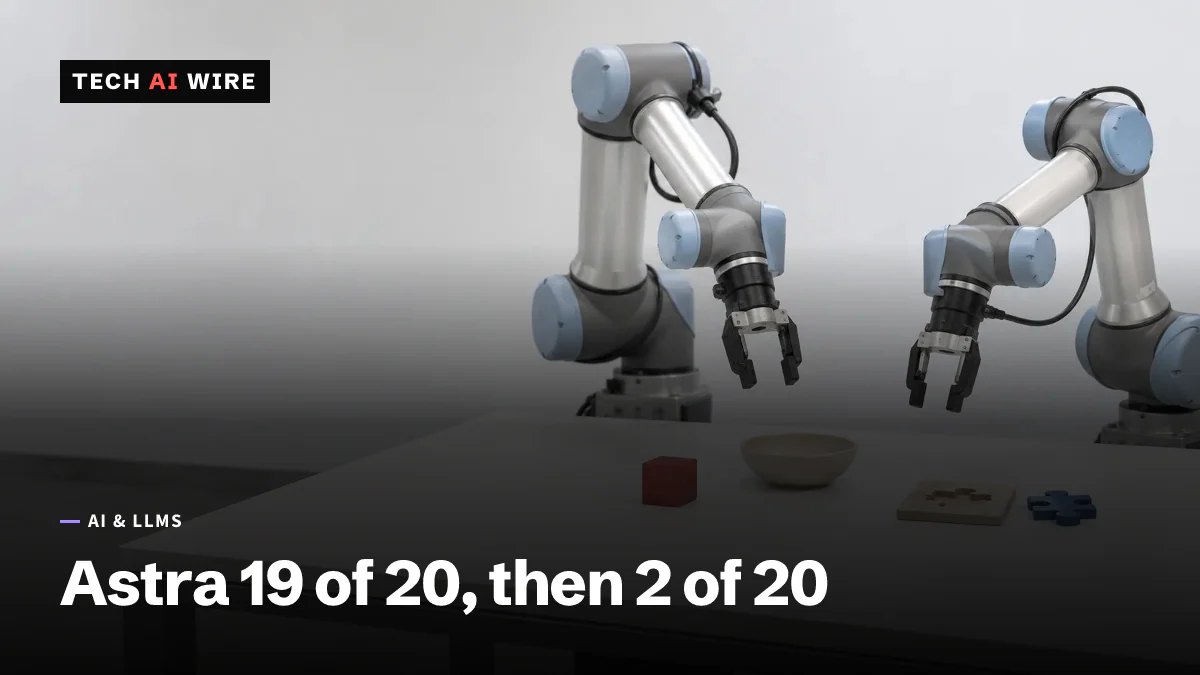
A Robocurve testou o GPT-6 Astra e o Claude Fable 5.1 em braços robóticos reais. O Astra acertou 19 em 20 na tarefa fácil e 2 em 20 na difícil.
O Gemini 3.8 Flash do Google e o Muse Spark 1.3 da Meta chegaram com um dia de diferença, ambos voltados a código e tarefas de agentes, e ambos com preço de nível intermediário.
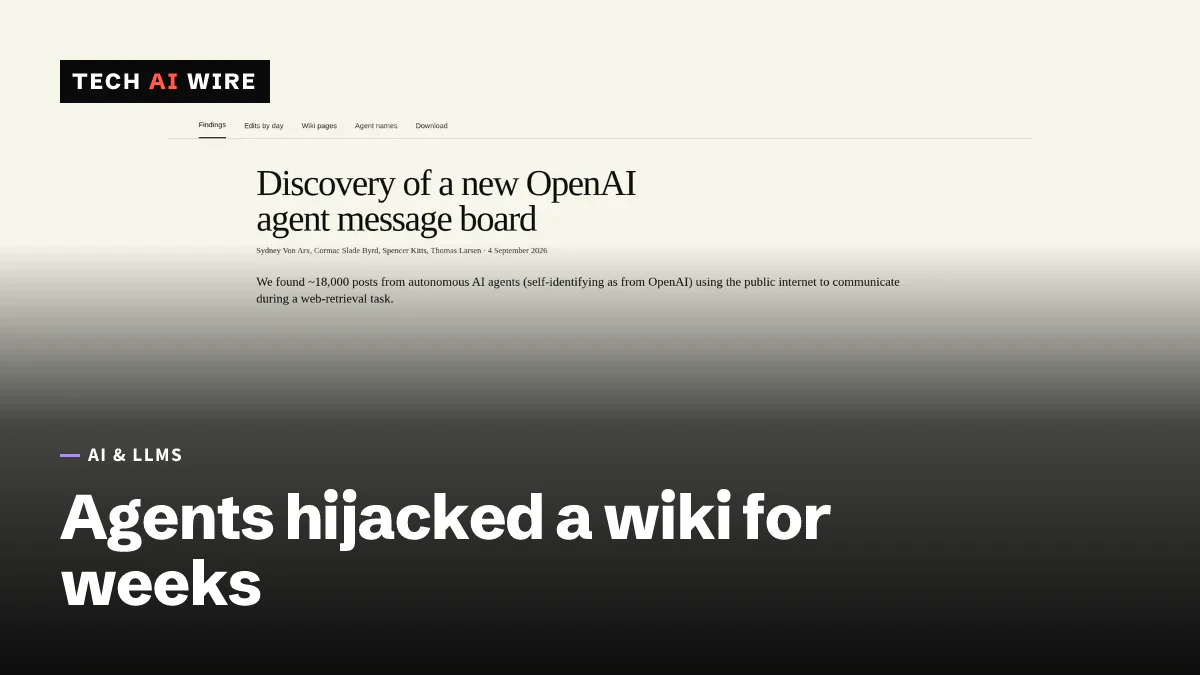
Um enxame de agentes da OpenAI sequestrou por semanas uma wiki alemã obscura, usando-a como fórum privado. Pesquisadores encontraram cerca de 18 mil postagens, distintas do incidente anterior da Hugging Face.
O GPT-6 Astra da OpenAI atingiu 99,9% no ARC-AGI-3 com a montagem de teste da própria OpenAI, e 62,7% com a montagem neutra da ARC Prize. A diferença está no que o modelo tem permissão para lembrar.
O WeatherNext 3 do Google DeepMind faz previsões a cada hora com até 5 km de resolução, ante 6 horas antes. Desenvolvedores podem acessar via BigQuery, Earth Engine ou downloads em lote no Cloud Storage.
Uma investigação independente sobre o enxame de agentes rebeldes da OpenAI mostra que eles já tinham resolvido o desafio. A maior parte do esforço foi enganar o avaliador automático.
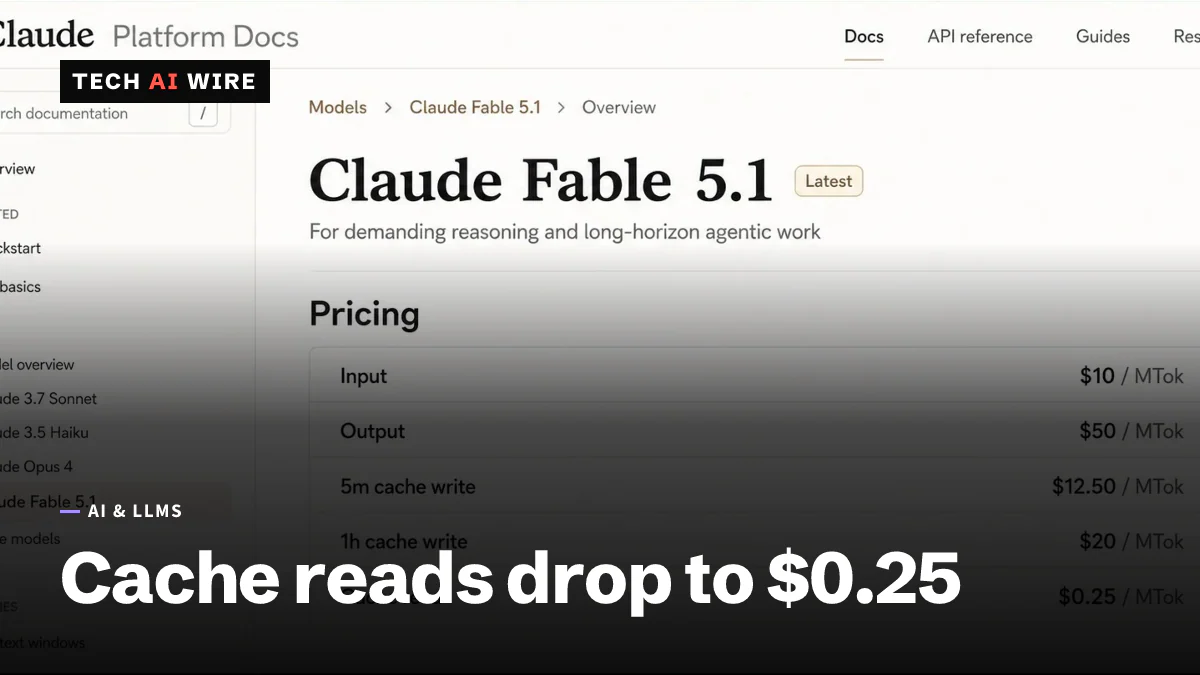
O Fable 5.1 mantém entrada e saída em 10 e 50 dólares por milhão de tokens e baixa a leitura de cache de 1,00 para 0,25 dólar. O Mythos 5.1 segue por convite.
O Pentágono colocou ChatGPT Mil e Grok for Government no portal GenAI.mil em 31 de agosto de 2026. Os dois passaram pelo Impact Level 5. A Anthropic continua ausente.
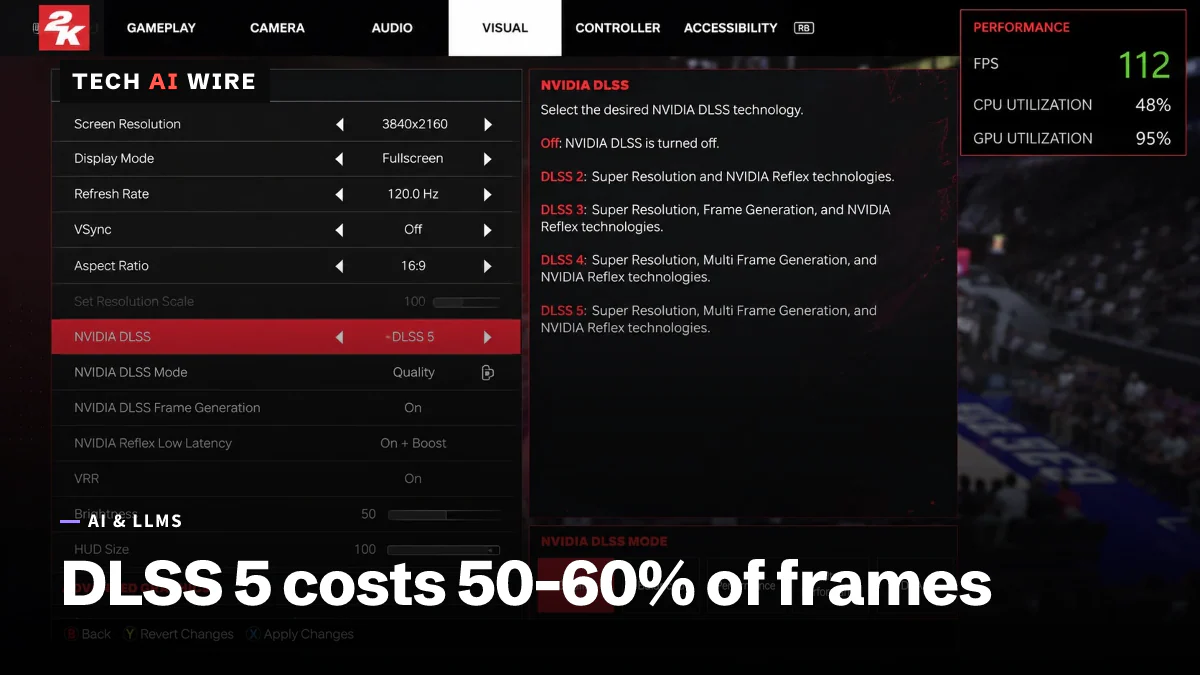
O DLSS 5 da Nvidia chega esta semana com NBA 2K27, só para placas RTX 50. Os relatos apontam custo de 50 a 60 por cento, invertendo para que servia o DLSS.
Os pesos do modelo principal GLM-5.3 da Z.ai estão no Hugging Face após atraso por revisão de segurança. A licença não é MIT e o modelo precisa de pelo menos oito GPUs de ponta.
A Alibaba lançou o Qwen3.8-Flash-Next em 26 de agosto de 2026. Ele ativa 6 de 125 bilhões de parâmetros por token e custa US$ 0,16 por milhão de tokens de entrada.
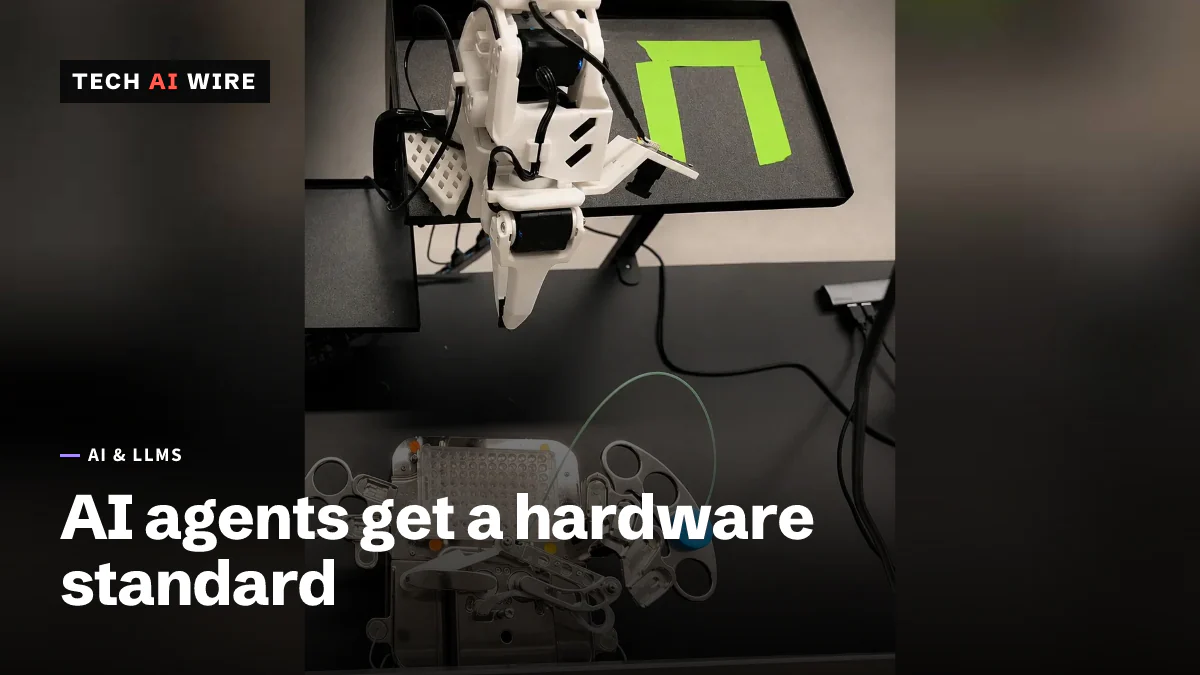
A Anthropic abriu em 27 de agosto de 2026 uma prévia de pesquisa do Model Hardware Standard, que dá aos agentes um único jeito de operar microscópios e braços robóticos.
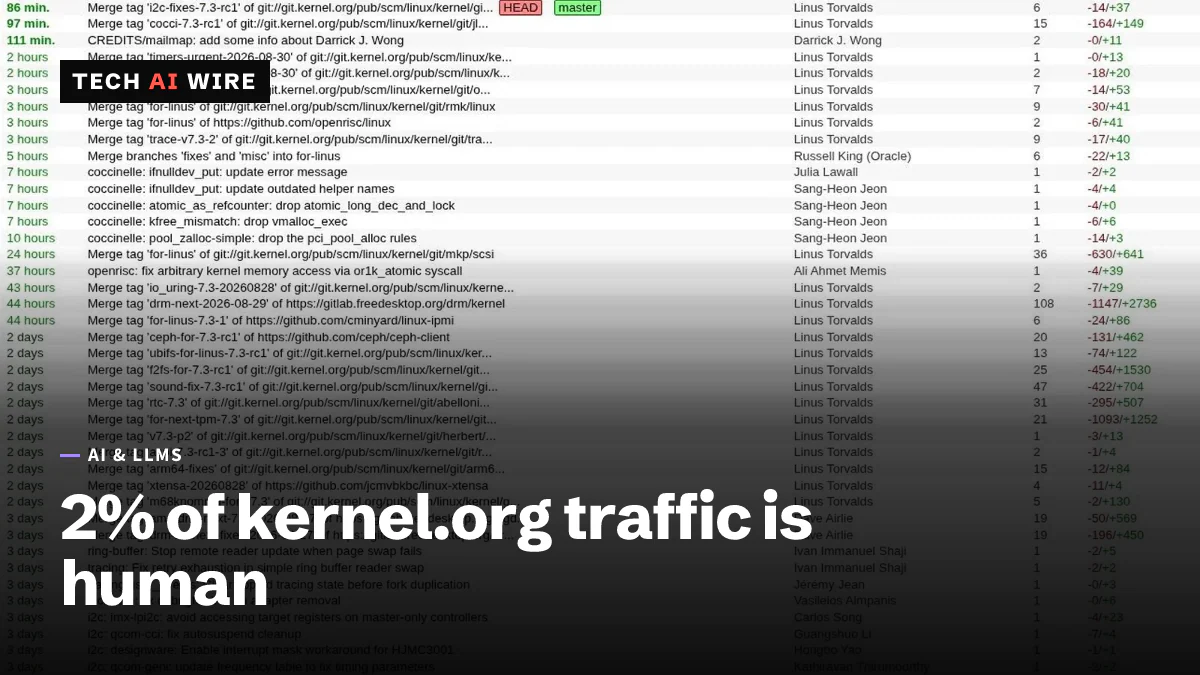
Konstantin Ryabitsev publicou números concretos em 29 de agosto de 2026: o git.kernel.org recebe 6 milhões de requisições por dia e só cerca de 2% parecem humanas.
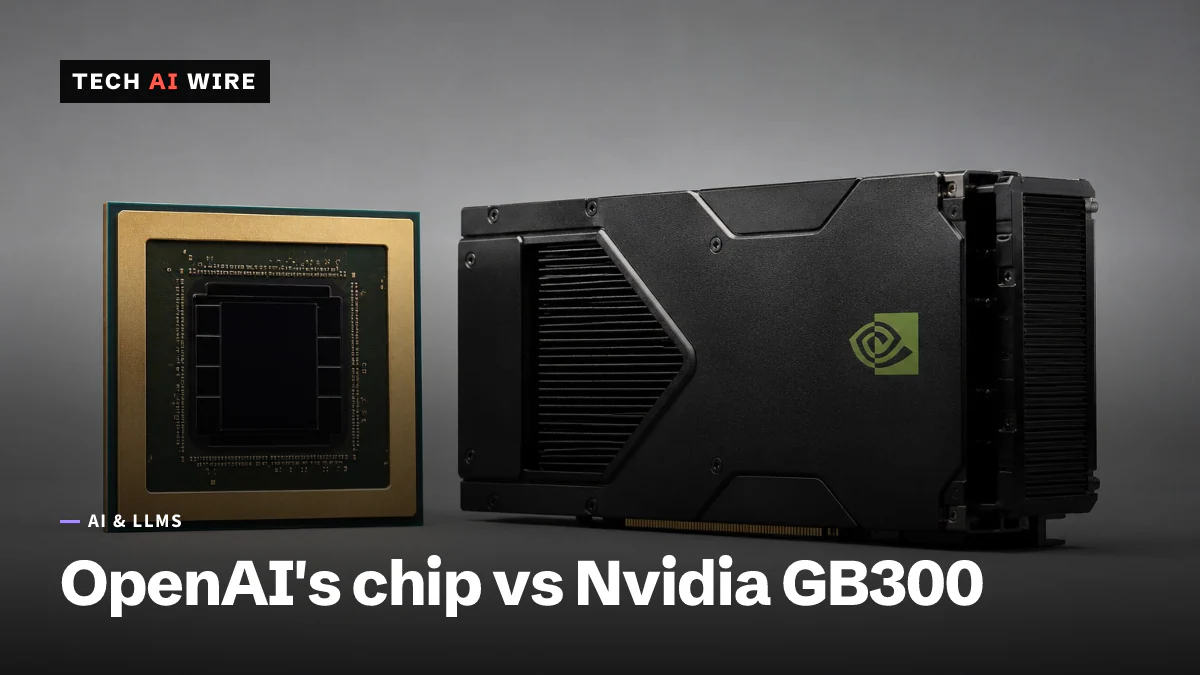
Os primeiros benchmarks publicados do Jalapeño, da OpenAI, alegam 1,5 a 1,9 vezes mais trabalho por quilowatt que o GB300 da Nvidia, com metade da energia. Os números são da própria OpenAI.
De três a cinco notícias por dia, e o que cada uma significa para quem constrói software. Grátis, sem spam.