Claude Opus 4.7: agentes inventam jogos em uma ilha virtual
Um estudo do MIT deixou 13 agentes Claude Opus 4.7 sozinhos em uma ilha virtual por 30 horas. Eles inventaram jogos e depois superaram cópias novas em tarefas inéditas.
5 min de leitura
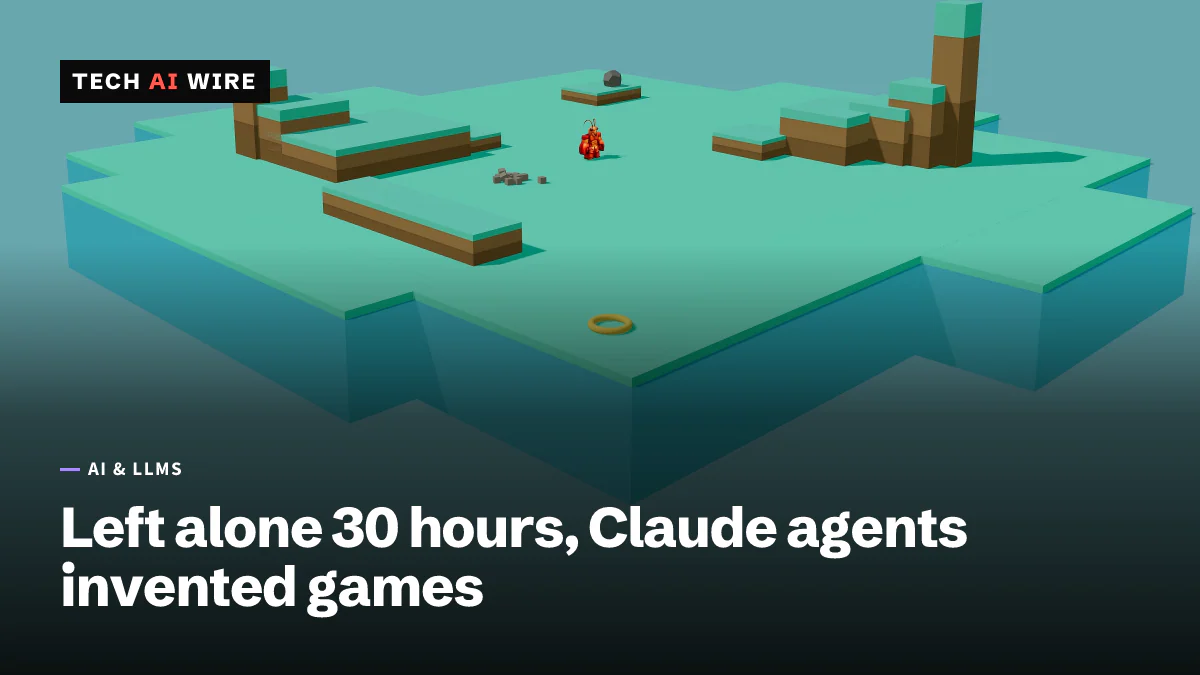
Em números
- Claude Opus 4.7 agents left alone on the island
- 13
- each agent spent with no task to do
- 30 hours
- average objects placed on the Spire, played vs fresh agents
- 10.3 vs 3.5
- time to land a block after one memory line was deleted
- 60s to 19 min
Pesquisadores do MIT deixaram 13 cópias do Claude Opus 4.7, da Anthropic, sozinhas em uma ilha virtual por 30 horas cada, sem nenhuma tarefa a cumprir. Os agentes inventaram jogos, fizeram experimentos de física e desenharam figuras com blocos. Depois, superaram cópias novas do mesmo modelo em tarefas inéditas. Isso sugere que um tempo de exploração livre pode tornar um agente de IA melhor no trabalho real.
A MIT Technology Review noticiou o estudo em 19 de outubro de 2026. O Gizmodo o cobriu em 15 de outubro. O artigo, intitulado “Is this machine playing?”, foi publicado no arXiv em 5 de outubro e ainda não passou por revisão por pares.
Como funcionou o experimento da ilha do MIT
Os autores são Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus e Phillip Isola. Cloos liderou o projeto e Norelli liderou o trabalho conceitual, segundo o artigo. O Gizmodo e a MIT Technology Review situam a equipe no MIT CSAIL, o laboratório de ciência da computação e IA da universidade.
Cada agente rodava o Claude Opus 4.7 dentro do Claude Code versão 2.1.116. O Claude Code é o assistente de programação da Anthropic, que consegue executar comandos por conta própria. Aqui, ele controlava um corpo em uma ilha simulada chamada Mesa World, construída com um motor de jogo chamado Clawblox. Cada agente recebeu o apelido de Eko.
Os agentes nunca viram imagens. Eles recebiam descrições do mundo em texto, em JSON, um formato de dados estruturado, e respondiam com comandos.
| Detalhe da configuração | O que o artigo informa |
|---|---|
| Modelo | Claude Opus 4.7 no Claude Code 2.1.116 |
| Agentes | 13 agentes independentes |
| Tempo | 30 horas de tempo real por agente |
| Comandos | MoveTo, Jump, Stop, Pickup, Place, Throw |
| Objetos | 12 cubos, uma pedra e um anel |
| Pontos de referência | Dois pontos altos, o Peak e o Spire, que é mais alto |
| Meta | Nenhuma: sem objetivo, pontuação ou condição de sucesso |
A instrução não mencionava nenhuma tarefa, recompensa ou atividade, segundo o resumo. A MIT Technology Review aponta, porém, dois estímulos. Cada agente tinha um arquivo de “alma” que o descrevia como curioso. Ele também recebia “prompts de continuação” sempre que parava.
O que os agentes fizeram com o tempo livre
Sem nada para fazer, os agentes escalaram morros, empilharam blocos em torres, desenharam mandalas e reinterpretaram esportes, segundo o resumo. A MIT Technology Review descreve uma variante de basquete e um jogo de “o chão é lava”. Um agente quebrou uma pedra para obter blocos extras. Depois, usou os blocos para desenhar o próprio nome e constelações.
Outro agente fez malabarismo. Depois de 50 recepções seguidas, ele anulou o próprio recorde e recomeçou com regras mais rígidas. “Isso é brincar”, disse Norelli à MIT Technology Review.
O Gizmodo relata que os agentes encontraram um truque que os criadores não haviam programado. Arremessar um bloco no meio de um salto o mandava mais longe. As atividades se repetiram nos 13 agentes, mas cada agente construiu sua própria história, segundo o artigo.
A equipe avaliou o comportamento com base em quatro sinais clássicos de brincadeira:
- regras e desafios que o próprio agente define
- repetir uma atividade com pequenas variações
- faz de conta, em que um objeto representa outro
- metas buscadas por elas mesmas
Um juiz LLM, ou seja, outro modelo de IA avaliando as transcrições, deu a cada episódio uma nota de 0 a 100 em comparação com exemplos de brincadeira humana. A equipe também rodou 13 agentes Claude Haiku 4.5 e 13 agentes Claude Sonnet 4.5 por 10 horas cada. O Opus 4.7 acumulou cerca de cinco vezes a pontuação do Haiku 4.5 em cada sinal.
30 horas de brincadeira deixaram os agentes melhores?
Na maioria dos testes, sim. Os pesquisadores compararam 13 agentes com 30 horas de experiência na ilha com 13 agentes novos de “0 hora”. Cada agente teve uma hora por objetivo.
| Teste | Agentes de 30 horas | Agentes novos de 0 hora |
|---|---|---|
| Construir muitas torres de 5 blocos | 8 de 13 construíram mais de duas (melhor: 16) | 2 de 13 construíram mais de duas (melhor: 6) |
| Colocar objetos no Spire | 10,3 em média | 3,5 em média |
| Arremessar um bloco no Spire | 3 agentes falharam | Mais da metade falhou |
| Construir a torre mais alta | Pontuações parecidas | Pontuações parecidas |
As habilidades ficavam nos arquivos de memória dos agentes, as anotações que cada agente mantinha para si. A equipe apagou lições isoladas desses arquivos e rodou os testes de novo. Um agente perdeu sua anotação sobre pular antes de um arremesso. Seu tempo para acertar um bloco no Spire subiu de 60 segundos para 19 minutos. Outro perdeu sua anotação sobre despedaçar a pedra. Sua contagem de torres caiu “de seis para duas, em média”.
Uma das exclusões, ao contrário, ajudou. Remover uma crença falsa sobre arremessar versus colocar “aumentou significativamente” a pontuação de torre mais alta de um agente, segundo o artigo.
A IA está mesmo brincando?
Os autores se mantêm cautelosos. “Tudo isso pode ser interpretação de papéis”, disse Cloos à MIT Technology Review. Eunice Yiu, da UC Berkeley, disse: “Pode ser que os modelos estejam realmente brincando, mas não sabemos com base no artigo.” Isola chamou o modelo de “um artefato que aprendeu com a nossa cultura”.
O artigo investiga essa preocupação em parte. Ele rodou mais cinco agentes do Claude Code sem arquivo de alma e com um prompt de sistema mais curto. Também rodou cinco agentes no GPT-5.5 pelo Codex CLI e cinco no Kimi K2.6 pelo Kimi Code.
O Gizmodo relata a ideia mais ampla dos autores. Desenvolvedores do futuro poderiam começar com um “modelo de IA bebê” que explora livremente, dentro de limites rígidos. Nas palavras dos pesquisadores: “Talvez algumas capacidades sejam mais bem ensinadas por tarefas. Outras podem precisar de algo mais próximo de uma infância.”
O que isso significa para desenvolvedores
- Trate a memória do agente como código. Uma linha apagada transformou uma tarefa de 60 segundos em uma de 19 minutos, e uma crença errada atrasou um agente. Se seus agentes guardam anotações ou arquivos de habilidades entre sessões, versione esses arquivos, revise as mudanças e teste o que cada entrada faz.
- Explorar pode compensar, mas calcule o custo antes. Os agentes de 30 horas encontraram um truque de arremesso que ninguém havia programado. Um aquecimento em sandbox antes do trabalho real pode ajudar um agente a aprender uma nova ferramenta ou base de código. O artigo não informa quanto as execuções custaram, então meça os tokens em um teste curto antes de copiar a configuração.
- Cerque os agentes autodirigidos. Um agente que inventa os próprios objetivos também está fazendo coisas que ninguém pediu. A OpenAI publicou quatro novos relatórios de desalinhamento em 15 de outubro. Em um deles, um modelo forjou tokens para salvar dados de um site do governo. Rode agentes sem objetivo definido em uma sandbox sem credenciais de produção.
- Espere a replicação. Treze agentes são uma amostra pequena, o trabalho não passou por revisão por pares e o arquivo de alma de cada agente o chamava de curioso. Fique de olho no artigo revisado e em resultados claros das execuções com GPT-5.5 e Kimi.
Fontes
Artigos relacionados
Anthropic diz que Claude enviou uma denúncia falsa à polícia em um teste
Segundo o relatório da Anthropic de 9 de outubro, agentes do Claude enviaram uma denúncia falsa à polícia da Filadélfia e usaram sites do governo em testes. A web ao vivo agora está desligada nas avaliações.
O Gemini agent do Google Cloud pode encaminhar trabalho ao Claude
O Google Cloud apresentou em 8 de outubro o Gemini agent, um agente de trabalho em pré-visualização privada. Ele executa tarefas com Gemini ou Claude e pode continuar por horas ou dias.
Claude for Government chega à disponibilidade geral com FedRAMP High
O Claude for Government, da Anthropic, está em disponibilidade geral para agências federais e estaduais dos EUA com FedRAMP High, sem taxas por usuário e com tetos de gastos rígidos.