ElevenLabs Eleven Realtime: agentes de voz respondem em 570 ms
O Eleven Realtime v1 Max, da ElevenLabs, responde em 570 ms e marca 98,8% no Big Bench Audio, segundo a empresa. Sua API copia o formato Realtime da OpenAI.
4 min de leitura
Em números
- v1 Max time to first audio, per ElevenLabs
- 570 ms
- v1 Max score on Big Bench Audio
- 98.8%
- languages supported
- 90+
- Eleven Realtime v1 Max
- 98.8%
- Grok Voice 3.0
- 98.5%
- Gemini 3.8 Live Extended Thinking
- 97.7%
- Eleven Realtime v1 Mini
- 75.9%
A ElevenLabs lançou o Eleven Realtime em 20 de outubro de 2026: dois modelos de voz que ouvem e respondem em uma única etapa, para criar agentes de voz. Segundo a empresa, o maior, v1 Max, começa a responder em 570 milissegundos e lidera um teste padrão de raciocínio por voz. Para desenvolvedores, a maior novidade talvez seja a API. Ela copia o formato Realtime da OpenAI, então um código existente pode migrar com duas mudanças.
Um agente de voz é um software que mantém uma conversa falada, como uma central de suporte que atende ligações. A maioria é montada como uma cadeia: fala para texto, depois um modelo de linguagem, depois texto para fala. Cada elo acrescenta atraso. A ElevenLabs vende o Eleven Realtime como speech-to-speech, ou seja, o áudio entra em um único serviço e sai dele como áudio.
Dois modelos: v1 Max e v1 Mini
O anúncio da ElevenLabs divide a família por função. O menor, v1 Mini, é para "conversa natural a baixo custo", como chats simples em que a velocidade é o que mais importa. O maior, v1 Max, é para "tarefas complexas e fluxos de trabalho de várias etapas", incluindo ligações que usam ferramentas.
A ElevenLabs diz que a empresa de análise Artificial Analysis avaliou os dois modelos de forma independente. Ela não diz quem mediu o uso de ferramentas.
| Medida | v1 Max | v1 Mini |
|---|---|---|
| Tempo até o primeiro áudio, segundo a ElevenLabs | 570 ms | 620 ms |
| Big Bench Audio (raciocínio falado) | 98,8% | 75,9% |
| Full-Duplex-Bench (fluxo da conversa) | 94,1% | 95,8% |
| Speech Agent Arena (preferência humana) | 998 | 988 |
| Tarefas com ferramentas concluídas | 87,1% | 60,3% |
O Big Bench Audio faz 1.000 perguntas faladas. O Full-Duplex-Bench mede com que naturalidade um modelo lida com a troca de turnos, como pausas e interrupções. Nesse teste, o Mini fica um pouco à frente do Max, o que combina com sua proposta de modelo conversacional.
Os números de latência são conflitantes. O blog e a página do produto da ElevenLabs informam 570 ms para o Max e 620 ms para o Mini. O Journal du Net, um veículo de tecnologia francês, relata 470 ms e 500 ms sem citar uma fonte. O Journal du Net também lista rivais. O Grok Voice 3.0 leva 810 ms e marca 98,5% em raciocínio por voz, e o Gemini 3.8 Live Extended Thinking marca 97,7%. O GPT-Realtime-2 (High), da OpenAI, leva 1,14 segundo.
Construído sobre o formato Realtime da OpenAI
A Realtime API segue a especificação Realtime da OpenAI, segundo a ElevenLabs. Migrar um app existente significa trocar a URL do endpoint e o nome do modelo, e o próprio SDK da OpenAI funciona sem alterações. A página do produto mostra o ID de modelo eleven_realtime_v1_mini.
Há limites. A API funciona apenas via WebSocket, sem versão WebRTC no lançamento, então apps de navegador construídos sobre WebRTC precisam trocar de transporte. Linhas telefônicas, WhatsApp, centrais de atendimento, bases de conhecimento, guardrails e monitoramento exigem o ElevenAgents, a plataforma separada da ElevenLabs, e não a API pura.
O Tech Times faz uma ressalva sobre o design. A ElevenLabs confirma que o Eleven Realtime é internamente uma cadeia de componentes, apesar do rótulo speech-to-speech. Os desenvolvedores não podem inspecionar, configurar nem trocar essas partes, e não há transcrição em texto da etapa intermediária.
Preços e conformidade ainda não estão definidos
A ElevenLabs não publicou preços para os modelos. A Realtime API é cobrada por minuto de áudio conectado mais tokens, com os mesmos preços por token em todos os planos. O ElevenAgents usa seu preço padrão por minuto mais o custo do modelo de linguagem. O Journal du Net diz que o preço por token não foi anunciado no lançamento.
O quadro de conformidade também muda conforme a fonte. A página do produto lista conformidade com a HIPAA e um Zero Retention Mode para a plataforma. O Tech Times relata que o v1 Mini não tem nenhum dos dois. Segundo o veículo, o v1 Max só oferece ambos com residência de dados nos EUA ou na UE, não na Índia nem em Singapura.
Os dois modelos falam mais de 90 idiomas. O uso de agentes de voz cresce rápido: o ElevenAgents processou 15 milhões de conversas por semana, o triplo do volume de fevereiro de 2026, segundo o Tech Times. Esse crescimento é parte do motivo pelo qual a empresa dobrou seu valuation para US$ 22 bilhões neste mês.
O que isso significa para desenvolvedores
A API compatível com a OpenAI torna um teste barato. Se você já usa a Realtime API da OpenAI via WebSocket, aponte um branch para a ElevenLabs e compare nas suas próprias ligações.
- Escolha o modelo pela função. Max para agentes que chamam ferramentas ou seguem etapas; Mini para conversas simples e descontraídas.
- Meça a latência você mesmo. Dois conjuntos de números estão circulando, 570 ms e 470 ms para o Max. Cronometre o primeiro áudio na sua própria rede e região.
- Veja o que você perde sem transcrição. Se você registra ligações, audita respostas ou roda verificações no texto entre as etapas, este design não oferece nada disso.
- Confirme a conformidade por modelo e região. Equipes de saúde e de setores regulados devem obter por escrito os termos de HIPAA e de residência de dados antes de construir sobre o Mini.
- Espere os preços antes de se comprometer. Não há tarifas por minuto nem por token publicadas. Compare o custo com rivais como os agentes de voz Voxtral 3 da Mistral só quando a ElevenLabs divulgá-las.
Fontes
Artigos relacionados
Mistral Voxtral 3 traz agentes de voz a partir de US$ 0,0035 por minuto
O Voxtral 3 da Mistral traz voz para texto a partir de US$ 0,0035 por minuto, um modelo de voz a US$ 13 por milhão de caracteres e uma API de agentes de voz a partir de US$ 0,04 por minuto.
Modelo Glimpse, da Elorian, volta a olhar as imagens enquanto raciocina
O Glimpse, primeiro modelo da Elorian, custa US$ 0,60 por milhão de tokens de entrada e volta a olhar as imagens enquanto raciocina. Ele superou o GPT-6 Astra em 4 de 11 testes.
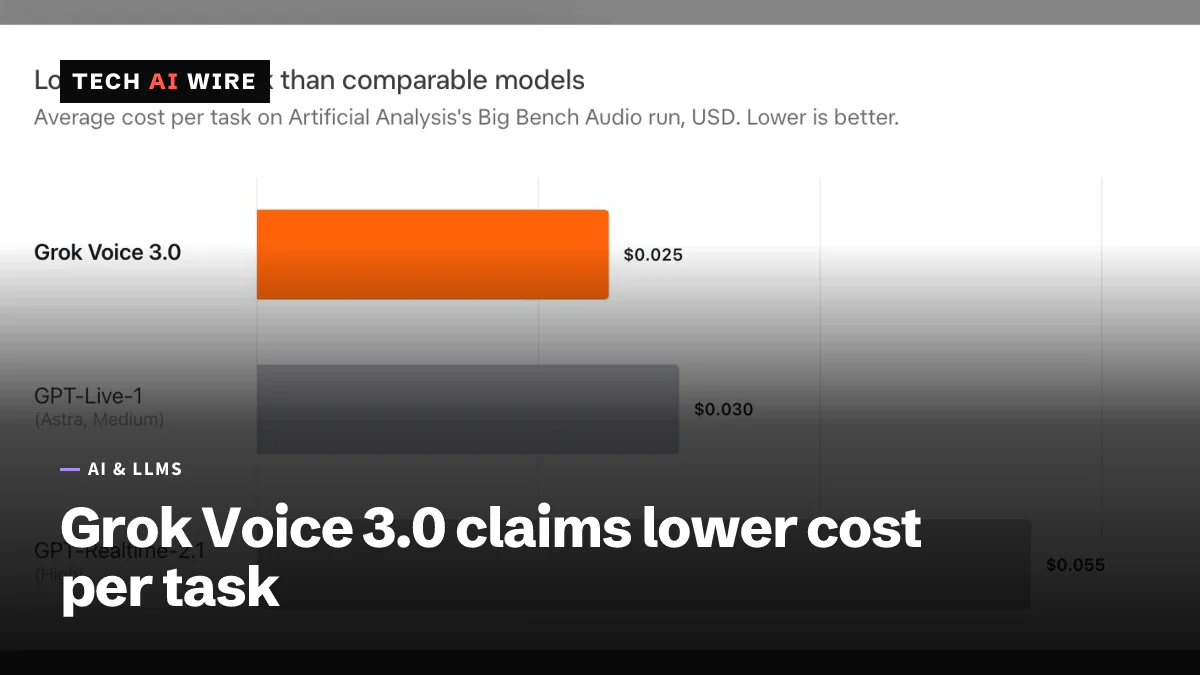
xAI lança o Grok Voice 3.0 a US$ 0,08 por minuto
O modelo de voz Grok Voice 3.0 da xAI custa US$ 0,08 por minuto na Voice Agent API, o mesmo que a versão 2.0, e marca 86,9 no Speech-to-Speech Index da Artificial Analysis.