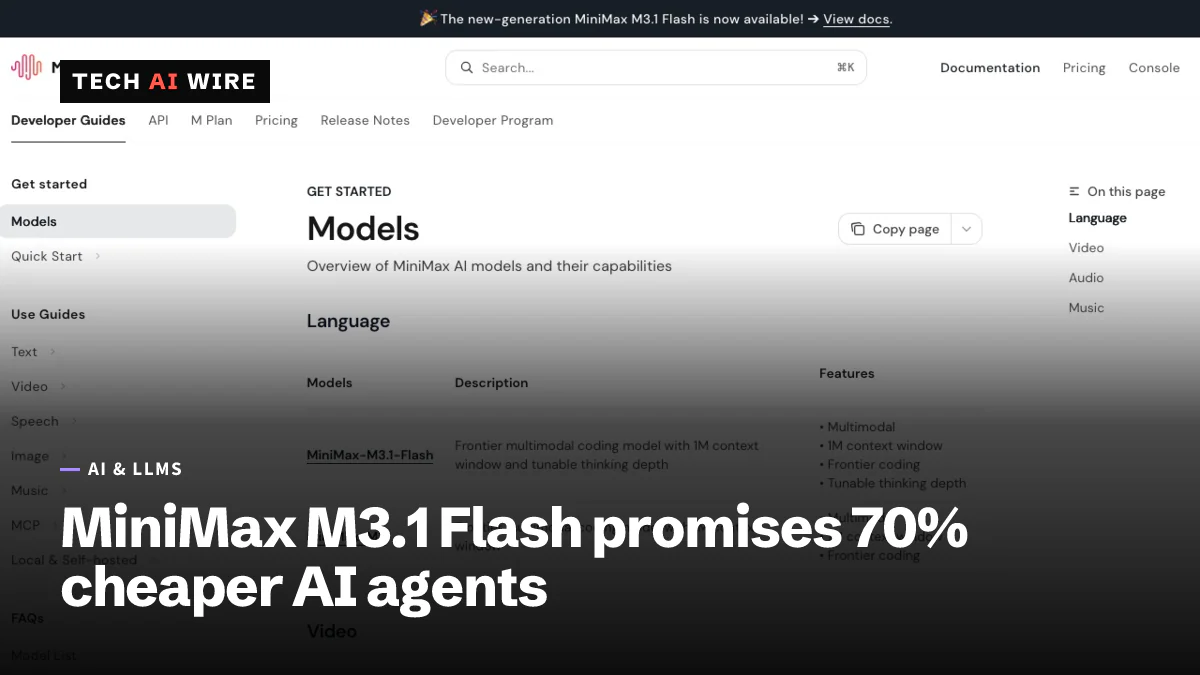
MiniMax M3.1 Flash chega e promete agentes 70% mais baratos
O novo modelo da MiniMax custa US$ 0,15 por milhão de tokens de entrada e US$ 0,60 de saída, e a empresa diz que ele roda agentes de IA por 70% menos que o M3.
3 min de leitura
Em números
- per million input tokens
- $0.15
- per million output tokens
- $0.60
- lower agent costs than M3, per MiniMax
- 70%
- DeepSeek V4.1-Flash
- 77%
- MiniMax M3.1 Flash
- 73.7%
A MiniMax começou a liberar o M3.1 Flash em 19 de outubro de 2026, uma versão mais rápida e mais barata do seu modelo de IA M3. A empresa diz que ele corta em 70% o custo de rodar agentes de IA. A US$ 0,15 por milhão de tokens de entrada, ele concorre diretamente em preço com os modelos econômicos da DeepSeek.
O que a MiniMax lançou
A MiniMax é uma empresa chinesa de IA cujas ações são negociadas em Hong Kong. O modelo M3 da empresa foi lançado em junho. O M3.1 Flash é uma atualização feita para velocidade e baixo custo. O anúncio da MiniMax diz que ele está "oficialmente sendo liberado a partir de hoje".
Desenvolvedores podem acessá-lo de três formas: a API da MiniMax, a assinatura M Plan e o aplicativo de desktop MiniMax Code. As reportagens divergem sobre o status. O SiliconANGLE chama o modelo de prévia, citando o guia para desenvolvedores da MiniMax. O próprio post da empresa não usa essa palavra.
A MiniMax também esclareceu um mistério. Um modelo chamado "Space Bunny" apareceu anonimamente em setembro no OpenRouter, um site que oferece muitos modelos de IA por meio de uma única API. Era uma versão inicial do M3.1 Flash, informa o SiliconANGLE.
Preço e velocidade
Os preços são por milhão de tokens. Um token é um pequeno pedaço de texto, mais ou menos parte de uma palavra.
| Item | M3.1 Flash |
|---|---|
| Entrada | US$ 0,15 por milhão de tokens |
| Saída | US$ 0,60 por milhão de tokens |
| Entrada em cache | US$ 0,015 por milhão de tokens |
| Tamanho do prompt | Até 1 milhão de tokens (SiliconANGLE) |
| Total de parâmetros | 428 bilhões (SiliconANGLE) |
Entrada em cache é texto que o serviço já viu, como um prompt de sistema longo enviado a cada requisição. Aqui, ela custa um décimo da entrada nova.
A MiniMax faz duas afirmações sobre velocidade. A inferência online, o trabalho de responder às requisições, é "quase três vezes mais rápida", mas o post não diz mais rápida do que o quê. Ele também diz que a saída passa de 200 tokens por segundo no uso diário, com mediana acima de 170. O corte de 70% no custo é medido em relação ao modelo anterior da empresa.
Benchmarks
Todas as notas abaixo vêm da MiniMax. Nenhuma das duas fontes traz testes externos.
| Benchmark | O que testa | Nota |
|---|---|---|
| OSWorld V2 | Usar os aplicativos e a área de trabalho de um computador | 61,7 |
| BankerToolBench | Tarefas de finanças com ferramentas | 76,2 |
| CyberGym | Tarefas de segurança | 82% |
| DeepSWE v1.1 | Corrigir problemas reais de software | 73,7% |
| Agents' Last Exam | Tarefas difíceis de agentes | 29,6 |
No DeepSWE v1.1, o M3.1 Flash fica atrás do V4.1-Flash da DeepSeek, que marcou 77%, observa o SiliconANGLE. Essa comparação importa para a MiniMax como negócio. As ações da empresa teriam caído depois que a DeepSeek lançou o V4.1-Flash em setembro.
"O Flash representa nossa exploração contínua do equilíbrio entre eficiência e capacidade", escreveu a MiniMax.
Pesos abertos depois
Os pesos do M3.1 Flash, os arquivos necessários para rodar um modelo no seu próprio hardware, ainda não saíram. A MiniMax diz que eles "serão lançados mais tarde", sem data nem licença. Um modelo Pro maior também está a caminho, segundo o SiliconANGLE.
O que isso significa para desenvolvedores
O M3.1 Flash é mais um modelo forte e barato para trabalho com agentes, mas os números principais são da própria empresa. Trate-o como um candidato a testar, não como uma troca comprovada.
- Rode suas próprias tarefas de agente. A economia de 70% e as notas dos benchmarks vêm da MiniMax. Meça o custo por tarefa concluída na sua carga de trabalho, não o custo por token.
- Use o cache. Entrada em cache custa um décimo da entrada normal. Mantenha instruções longas idênticas entre as chamadas para que contem como cache.
- Confira a forma de acesso. Ele está na API, mas uma reportagem o chama de prévia. Confirme limites e termos na sua conta antes de construir em cima dele.
- Compare com a DeepSeek. O V4.1-Flash da DeepSeek marcou mais no DeepSWE v1.1. Se correção de código é seu uso principal, teste os dois.
- Espere pelos pesos se você hospeda por conta própria. Ainda não há data nem licença para os pesos abertos. Não planeje uso on-premises até a MiniMax publicar as duas coisas.
Fontes
- MiniMax M3.1 Flash - MiniMax
- MiniMax launches M3.1 Flash model, says it cuts AI agent costs by 70% - SiliconANGLE
Artigos relacionados
Modelos de decisão de IA, explicados
Um modelo de decisão escolhe entre respostas fixas e devolve uma probabilidade para cada uma, em vez de escrever texto. Os preços hospedados começam em US$ 0,02 por milhão de tokens.
Meta lança o Muse Wonder, seu primeiro modelo de fronteira
A Meta lançou o Muse Wonder em 12 de outubro a US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída. O modelo maior, Wonder Full, fica restrito ao Muse Code.
Xiaomi lança MiMo-V2.6-Pro com 1 trilhão de parâmetros em pesos abertos sob MIT
O MiMo-V2.6-Pro da Xiaomi tem 1,02 trilhão de parâmetros, 42 bilhões ativos, contexto de 1 milhão de tokens e pesos sob licença MIT, mas precisa de cerca de 680 GB de memória de GPU.