Ling-3.1-flash: Ant Group abre modelo de 560B sob licença MIT
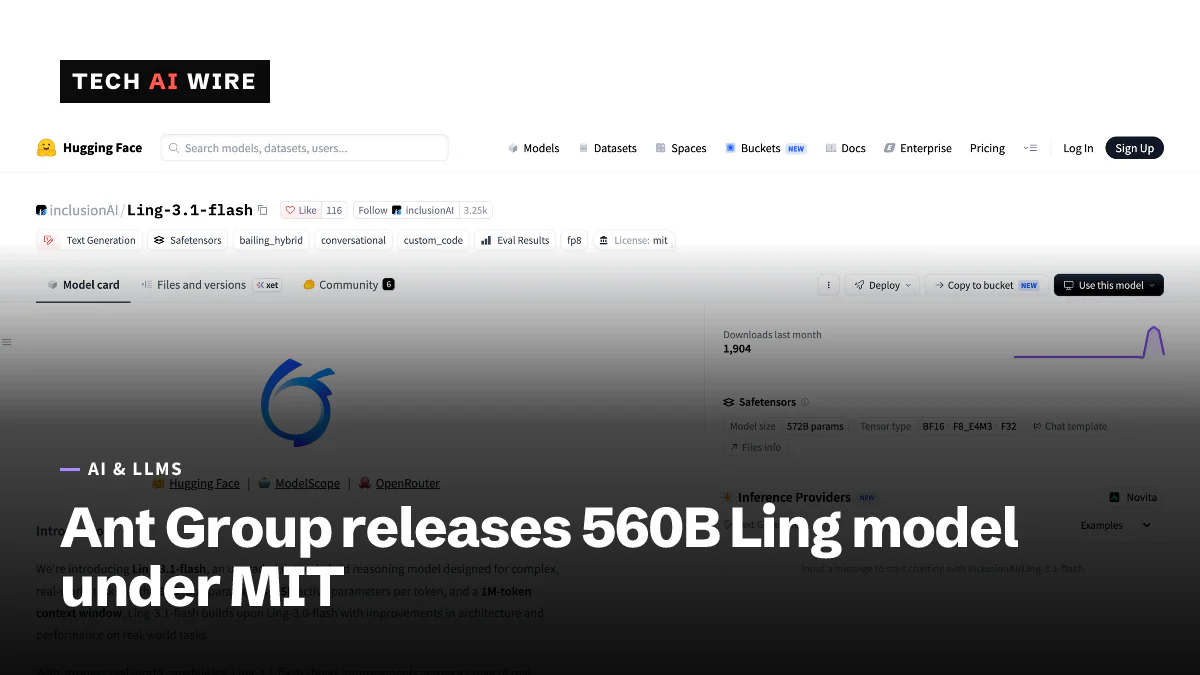
A inclusionAI, do Ant Group, publicou os pesos do Ling-3.1-flash sob a licença MIT: 560B parâmetros, 25B ativos por token e contexto de 1M de tokens.
3 min de leitura
Em números
- total parameters
- 560B
- parameters active for each token
- 25B
- tokens of context
- 1M
- H200 GPUs in the recommended serving setup
- 8
A equipe de pesquisa em IA do Ant Group, a inclusionAI, publicou os pesos do Ling-3.1-flash no Hugging Face sob a licença MIT. O modelo tem 560 bilhões de parâmetros, usa 25 bilhões para cada token e lê até 1 milhão de tokens de uma vez. A licença MIT significa que empresas podem criar produtos sobre ele com pouquíssimas condições.
O que a inclusionAI lançou
O card do modelo no Hugging Face descreve um modelo de mistura de especialistas "híbrido-linear". Um modelo de mistura de especialistas divide seu trabalho entre muitas redes especialistas pequenas e ativa só algumas delas para cada token, o pedaço de palavra que um modelo lê ou escreve. O Ling-3.1-flash tem 512 especialistas roteados e ativa 8 deles por token, mais 1 especialista compartilhado.
"Híbrido-linear" se refere às suas camadas de atenção, a parte de um modelo que relaciona cada palavra com as outras. A maioria das suas 72 camadas de atenção usa um desenho linear mais barato, e 9 usam um desenho mais completo chamado Gated MLA.
O primeiro commit do repositório é de 13 de outubro, e o card do modelo foi atualizado pela última vez em 15 de outubro. A Tech360 informa que a Ant ofereceu o modelo primeiro como um teste gratuito de API por duas semanas, limitado a 256.000 tokens de contexto. Ela prometeu a janela completa e os pesos para depois do teste e os publicou quando o teste terminou.
Como ele pontua
O card do modelo lista estes resultados. São números da própria inclusionAI, e o card não diz com quais modelos se compara.
| Benchmark | Ling-3.1-flash |
|---|---|
| SWE-bench Multilingual | 88,5 |
| Terminal-Bench 2.1 | 81,18 |
| SWE-bench Pro | 68,74 |
| SkillsBench v1.1 | 68,7 |
| Deep SWE | 59,7 |
| Terminal-Bench 4 | 46,03 |
| Humanity's Last Exam | 37,44 |
Uma visão externa vem da Artificial Analysis, uma empresa independente de benchmarks. A AlphaSignal informou em 6 de outubro que ela deu ao modelo hospedado nota 41 em seu Intelligence Index, ante 20 do Ling 3.0 Flash. As tarefas de agentes foram as que mais ganharam: o AutomationBench-AA passou de 3% para 62%.
O que é preciso para rodar
Os pesos são grandes. A AlphaSignal calculou a memória em 1,12 TB em precisão BF16 completa, 560 GB em 8 bits e 280 GB em 4 bits.
O card do modelo recomenda o SGLang, um motor de serviço, em 8 GPUs Nvidia H200 ou 4 GPUs GB300. Ele também traz uma receita para o vLLM, outro motor. Os dois usam previsão de múltiplos tokens, um truque em que o modelo rascunha vários tokens à frente para acelerar a saída. O card também aponta versões quantizadas para llama.cpp, Ollama e LM Studio, que encolhem o modelo para rodar em máquinas menores.
| Onde obter | Detalhe |
|---|---|
| Hugging Face | Pesos, licença MIT |
| ModelScope | Pesos |
| OpenRouter | API hospedada |
| Novita | API hospedada, também listada no Hugging Face |
Em 6 de outubro, a AlphaSignal listou o preço da Novita em US$ 0,30 por milhão de tokens de entrada e US$ 0,90 por milhão de tokens de saída. A Tech360 acrescenta que a Ant criou o LingCode, um harness de programação construído sobre o agente de código aberto Pi, e pode abrir o código dele mais tarde.
Como ele se compara em custo
O preço por token não é o custo total para agentes, que rodam por muitas etapas. A AlphaSignal citou números da Artificial Analysis para o custo de uma tarefa de benchmark. O Ling 3.1 Flash ficou em US$ 0,99, contra US$ 0,32 do DeepSeek V4.1 Flash no modo Max e US$ 1,24 do Gemini 3.8 Flash na configuração High. A DeepSeek lançou hoje um checkpoint atualizado do V4.1 Flash, então essa diferença pode ter mudado.
O Ling-3.1-flash chega em uma semana movimentada para grandes modelos abertos. A Meta lançou o Muse Spark Open, com 816 bilhões de parâmetros, em 15 de outubro.
O que isso significa para desenvolvedores
A licença MIT é o destaque para a maioria das equipes. Ela permite uso comercial e modificações com poucas condições, então a revisão jurídica deve ser curta. O modelo da Meta, por outro lado, usa uma licença própria.
Hospedar por conta própria ainda é trabalho de data center. Oito H200 são o ponto de partida recomendado, então a maioria das equipes vai começar pelo OpenRouter ou pela Novita. Compare os preços deles com o valor do período de teste, já que nenhuma das fontes informa um preço depois do teste.
Teste o modelo no seu próprio trabalho com contexto longo. Uma janela de 1 milhão de tokens só ajuda se a qualidade se mantiver perto do fim de uma entrada longa, e as notas no card da inclusionAI não incluem um teste de contexto longo.
Confira os harnesses de benchmark antes de comparar. Os fornecedores rodam o Terminal-Bench e o SWE-bench em configurações diferentes, então alguns pontos de diferença entre dois cards de modelo podem não significar muito.
Fontes
Artigos relacionados

Xiaomi lança MiMo-V2.6-Pro com 1 trilhão de parâmetros em pesos abertos sob MIT
O MiMo-V2.6-Pro da Xiaomi tem 1,02 trilhão de parâmetros, 42 bilhões ativos, contexto de 1 milhão de tokens e pesos sob licença MIT, mas precisa de cerca de 680 GB de memória de GPU.
StepFun Step 5 Preview: modelo de 600B para agentes, com pesos abertos
O Step 5 Preview da StepFun, um modelo de 600B parâmetros com 27B ativos e contexto de 1M de tokens, chegou ao Hugging Face após um mês só na API, a US$ 1/US$ 2,70 por milhão.
Meta Muse Spark Open lança 816B de pesos abertos
A Meta lançou o Muse Spark Open, um modelo de pesos abertos com 816B parâmetros, 42B ativos e contexto de 1M de tokens, no Hugging Face e em três plataformas de nuvem.