AMD GAIA 0.25 reúne seus agentes de IA locais em um só
O app de código aberto da AMD para agentes locais agora roda um único agente, reduz o ambiente Python no Windows de 0,9 GB para 0,1 GB e para de travar em notebooks de 16 GB.
3 min de leitura
Em números
- Windows Python setup, down from about 0.9GB
- 0.1GB
- to the first reply on Qwen3.6, down from about 43s
- 21s
- default limit before a stalled turn stops
- 75 min
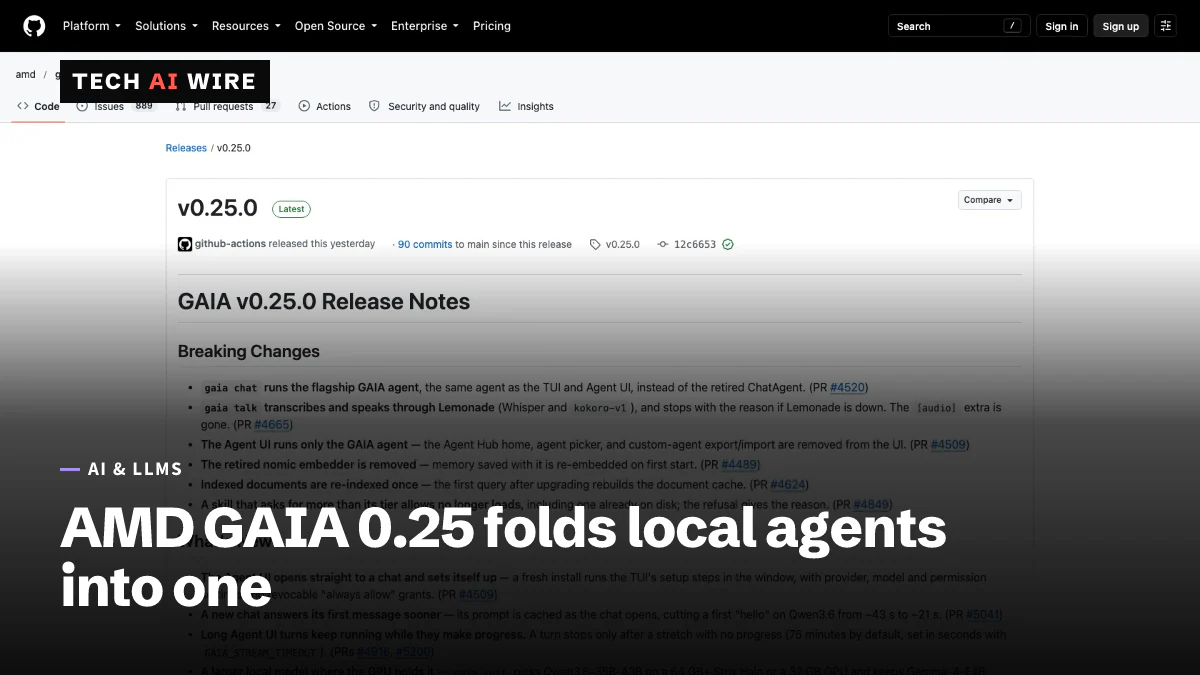
A AMD lançou o GAIA 0.25 em 18 de outubro de 2026, uma atualização do seu app de código aberto para rodar agentes de IA no seu próprio PC. A versão reúne os vários agentes do app em um só e reduz bastante o tamanho da instalação no Windows. Ela também corrige travamentos em notebooks de 16 GB, que dificultavam testar o app em máquinas comuns.
O que é o GAIA
O GAIA é o app gratuito da AMD para criar e rodar agentes de IA localmente, sem enviar dados para um serviço de nuvem. Um agente é um modelo de IA que pode executar ações, como ler arquivos ou rodar comandos, e não apenas conversar. O projeto começou como "Generative AI Is Awesome" e agora se apresenta como "a fábrica de agentes de código aberto da AMD", informa o Phoronix.
O app é voltado ao hardware Ryzen AI da AMD. A versão 0.25 traz instaladores para Windows, Linux e Macs com Apple Silicon, além de um pacote Python, segundo a página de lançamentos no GitHub.
Um agente em vez de vários
A maior mudança quebra velhos hábitos. O comando gaia chat agora roda o agente principal do GAIA, e o antigo ChatAgent foi aposentado. O app para desktop também roda apenas esse agente.
Vários recursos saíram com a mudança. As notas de versão dizem que a página inicial Agent Hub, o seletor de agentes e a importação e exportação de agentes personalizados foram removidos. Skills que pedem mais permissões do que seu nível permite não são mais carregadas.
A voz também mudou. O comando gaia talk agora usa o Lemonade, o servidor de IA local da AMD, nas duas direções. O Whisper transforma fala em texto, e o kokoro-v1 lê as respostas em voz alta. O pacote complementar de áudio separado foi removido.
Menor, mais rápido e com menos travamentos
A AMD removeu PyTorch, Transformers e Accelerate, três grandes bibliotecas de IA de que o app não precisava mais. Isso reduz o ambiente Python do app para desktop no Windows de cerca de 0,9 GB para cerca de 0,1 GB.
A correção para máquinas pequenas é a que mais importa para novos usuários. Em PCs de 16 GB, o app ficava sem memória na primeira execução. O Phoronix diz que notebooks Linux com 16 GB travavam porque o kernel encerrava o processo. O GAIA agora verifica a memória livre antes de carregar um modelo e reduz a janela de contexto do modelo, sua memória de trabalho, para caber.
| Mudança na 0.25 | Antes | Depois |
|---|---|---|
| Ambiente Python no Windows | Cerca de 0,9 GB | Cerca de 0,1 GB |
| Primeira resposta com Qwen3.6 | Cerca de 43 segundos | Cerca de 21 segundos |
| Agentes no app para desktop | Vários, com seletor | Um agente GAIA |
Voz no gaia talk | Complemento de áudio separado | Servidor Lemonade |
| Limite para turnos travados | Não informado | 75 minutos, ajustável |
Escolha de modelos e outras correções
O comando de configuração, gaia init, agora escolhe um modelo de acordo com o seu hardware. Ele escolhe o Qwen3.6-35B-A3B nas máquinas Strix Halo da AMD com 64 GB ou mais, ou em uma placa de vídeo de 32 GB. Todo o resto recebe o Gemma-4-E4B, menor. O Qwen3.8 Flash Next é opcional em sistemas Strix Halo de 128 GB.
Para uso na nuvem, o modelo padrão no LLM Gateway da AMD e na Fireworks é o DeepSeek V4.1 Flash. A indexação de documentos e memória agora roda no chip gráfico, o que libera cerca de 11 núcleos de CPU no Strix Halo.
Outras correções miram o uso diário:
- Um único instalador para Windows agora cobre tanto o app para desktop quanto o terminal.
- A configuração confia no repositório de certificados do sistema operacional. Assim, funciona atrás de proxies corporativos que inspecionam tráfego criptografado.
- Se você recusar uma ação, o agente não tenta mais fazê-la de novo por outra ferramenta.
- A interface de terminal ganha modos de permissão, alternados com Shift+Tab.
- Os documentos são reindexados uma vez após a atualização, porque o modelo de embeddings da Nomic foi removido.
O que isso significa para desenvolvedores
O GAIA 0.25 troca flexibilidade por um app mais simples que funciona em mais máquinas. Isso o torna um banco de testes melhor para agentes locais, mas uma casa pior para agentes personalizados.
- Atualize scripts que chamam o ChatAgent. Ele foi aposentado. Tudo o que depende de exportar ou importar agentes personalizados precisa de um novo plano antes da atualização.
- Teste em uma máquina de 16 GB. A memória era a principal barreira em notebooks intermediários. Espere uma janela de contexto menor nessas máquinas, então documentos longos podem não caber.
- Conte com uma reindexação única. A primeira pergunta após a atualização a dispara. Grandes conjuntos de documentos vão levar um tempo.
- Ajuste o tempo limite para tarefas longas. Turnos param após 75 minutos sem progresso. Altere o valor em segundos com a configuração
GAIA_STREAM_TIMEOUT. - Verifique o que roda onde. As execuções locais usam Qwen3.6 ou Gemma, enquanto o padrão na nuvem é o DeepSeek V4.1 Flash. Confirme qual deles processa seus dados.
Fontes
Artigos relacionados
Strands Decider 2B toma decisões de agentes em 115 ms
O Strands Decider 2B, da AWS, é um modelo de código aberto que escolhe em uma lista em vez de escrever texto. Ele responde em 115 ms em uma RTX 3090 e marca 72,3% no JevBench.
Microsoft-Decision-1 pontua opções em vez de escrever texto
O Microsoft-Decision-1 retorna uma probabilidade para cada opção fixa em vez de escrever texto. Custa US$ 0,042 por milhão de tokens de entrada no Microsoft Foundry.
Cloudflare Clef: modelos de pesos abertos que devolvem decisões
O Clef (27B) e o Clef-flash (9B), da Cloudflare, respondem a perguntas tipadas em vez de escrever texto, com latência mediana de 209 ms e 39 ms, sob Apache 2.0.