Microsoft MAI-Base-2 conclui o pré-treinamento com 2,8T de parâmetros
A Microsoft AI concluiu o pré-treinamento do MAI-Base-2, um modelo de 2,8T de parâmetros com 80B ativos, em 16.000 GPUs GB200 em 38 dias. Ele ainda não foi lançado.
Por Claire Whitmore
3 min de leitura
Traduzido automaticamente do original em inglês, que Claire Whitmore verificou e editou. Prevalece a versão em inglês. Como trabalhamos
Em números
- total parameters, with 80B active per token
- 2.8T
- Nvidia GB200 GPUs used for training
- 16,000
- of pre-training in August and September 2026
- 38 days
- claimed compute efficiency versus DeepSeek-V4-Pro-Base
- 4.2-12.3x
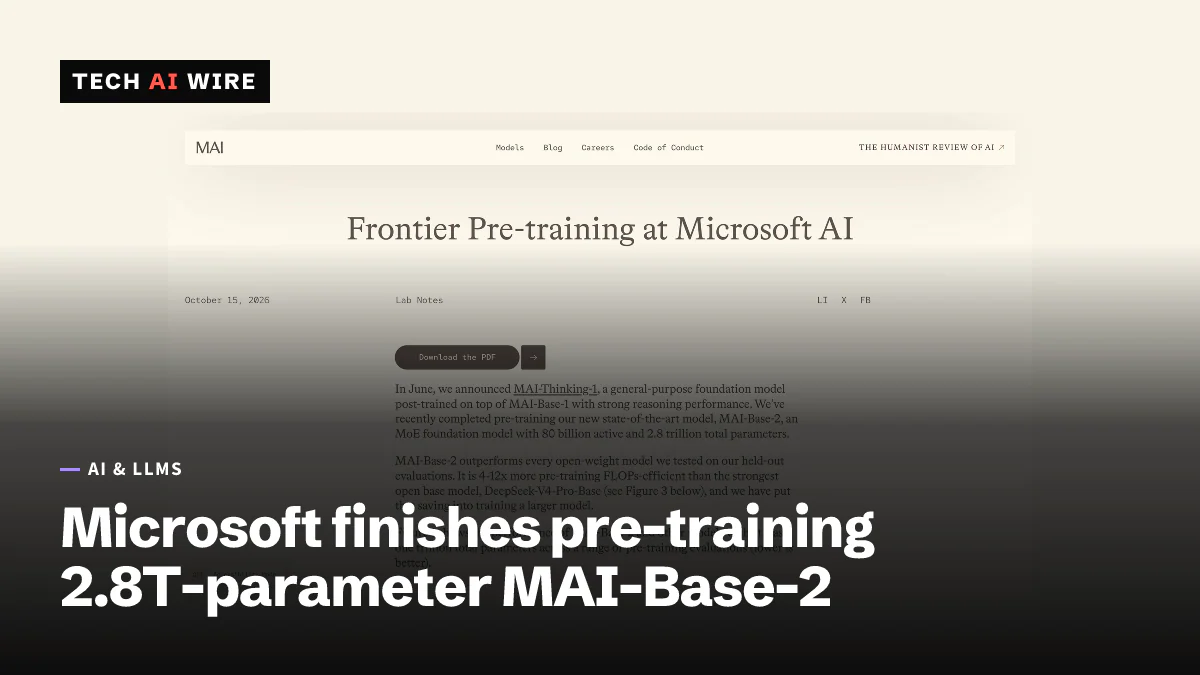
A Microsoft AI concluiu o pré-treinamento do MAI-Base-2, seu próximo modelo de fundação próprio, informou a empresa em 15 de outubro de 2026. O modelo tem 2,8 trilhões de parâmetros, com 80 bilhões ativos para cada token. A Microsoft diz que ele supera todos os modelos de pesos abertos que testou e consumiu muito menos poder computacional do que um rival de ponta. Isso mostra a Microsoft construindo seus próprios modelos em escala de fronteira, ao lado dos modelos da OpenAI que ela já oferece.
O pré-treinamento é a primeira e mais cara etapa da construção de um modelo de linguagem. O modelo lê trilhões de palavras e aprende a prever a próxima. O MAI-Base-2 está agora no pós-treinamento, a etapa que transforma um modelo bruto em um assistente útil. Ele ainda não está disponível para uso.
O que a Microsoft construiu
O MAI-Base-2 é um modelo mixture-of-experts (MoE). Só uma pequena parte da rede, os "especialistas" escolhidos para cada token, roda a cada momento. É por isso que um modelo de 2,8 trilhões de parâmetros precisa de apenas 80 bilhões de parâmetros de trabalho por token.
| Item | MAI-Base-2 |
|---|---|
| Parâmetros totais | 2,8 trilhões |
| Parâmetros ativos por token | 80 bilhões |
| Hardware de treinamento | Cerca de 16.000 GPUs Nvidia GB200 |
| Tempo de treinamento | 38 dias, em agosto e setembro de 2026 |
| Mistura de treinamento | 50 trilhões de tokens |
| Parcela de imagem e texto | 18%, a partir de 4,5 trilhões de tokens únicos |
| Situação | Em pós-treinamento, sem data de lançamento |
O modelo aprendeu com imagens, além de texto. Dados de imagem e texto representaram 18% da mistura de 50 trilhões de tokens, segundo o post da Microsoft AI. O número de tokens únicos de treinamento cresceu cerca de 36% em relação ao antecessor, o MAI-Base-1.
Como foi o treinamento
A Microsoft divulgou duas medidas de eficiência. A Model FLOPs utilization, ou MFU, teve média de 21%. É a parcela do poder matemático máximo das GPUs que foi para treinamento útil. O goodput foi de 89%. É a parcela do tempo gasta treinando, e não se recuperando de falhas e reinícios.
A Microsoft também assumiu uma posição pública sobre um tema sensível. "Nosso pré-treinamento é construído sobre dados orgânicos, que não envolvem destilação de outros modelos", diz o post. Destilação significa treinar um modelo com as respostas de outro modelo. Nesta semana, a Anthropic descreveu novas defesas contra a destilação do Claude.
A alegação de eficiência
O número principal é uma comparação com o DeepSeek-V4-Pro-Base, um modelo aberto de ponta. A Microsoft diz que o MAI-Base-2 alcança os mesmos resultados com 4 a 12 vezes menos FLOPs de treinamento. O corpo do post dá a faixa como 4,2 a 12,3 vezes.
"O MAI-Base-2 supera todos os modelos de pesos abertos que testamos em nossas avaliações held-out", escreveu a Microsoft. Avaliações held-out são testes mantidos fora dos dados de treinamento. São testes da própria Microsoft, e nenhum grupo externo os verificou.
Onde ele se encaixa
A Microsoft lançou publicamente seu programa MAI em 2 de junho de 2026, em sua conferência Build, com sete modelos, informa o Crypto Briefing. A equipe é a Microsoft AI, liderada por Mustafa Suleyman.
O salto de escala é grande. O MAI-Base-1 foi treinado em 8.192 GPUs GB200 e 30 trilhões de tokens de dados escritos por humanos, mais 3,55 trilhões de tokens em uma etapa posterior. O MAI-Thinking-1, construído sobre essa base, marcou cerca de 52,8% no SWE-Bench Pro, um teste de programação, diz o Crypto Briefing.
A Microsoft também está construindo seus próprios chips de IA. Ela planeja implantações de vários gigawatts de chips Maia a partir de 2027, segundo o Crypto Briefing. Cobrimos o chip Maia 300 nesta semana. O trabalho no MAI-Base-3 já começou, diz a Microsoft.
O que isso significa para desenvolvedores
Não há nada para chamar ou baixar hoje. O MAI-Base-2 é um modelo base em pós-treinamento, e a Microsoft não deu data de lançamento nem preço.
Fique atento a duas coisas quando ele for lançado. Primeiro, veja se a vantagem de eficiência aparece como preços mais baixos nas plataformas da Microsoft. Um modelo que custa menos para treinar pode custar menos para servir, mas a Microsoft não prometeu nada. Segundo, espere por benchmarks externos. "Todos os modelos de pesos abertos que testamos" depende de quais modelos e de quais testes.
Para equipes que constroem no Azure, o ponto maior é a escolha. Um modelo de fronteira treinado pela Microsoft ficaria ao lado dos modelos da OpenAI na mesma plataforma. Se você amarrou seu código a uma família de modelos, mantenha uma camada fina entre seu app e o modelo. Assim você pode comparar os modelos MAI com sua escolha atual quando eles chegarem.
Fontes
- Frontier Pre-training at Microsoft AI - Microsoft AI
- Microsoft finishes pre-training MAI-Base-2, its next in-house foundation model - Crypto Briefing
Artigos relacionados
Pesos abertos do Reflection Beam chegam sob Apache 2.0
A Reflection publicou os pesos do Beam, com 501 bilhões de parâmetros, no Hugging Face em 16 de outubro de 2026, sob Apache 2.0. As versões FP8 e de 4 bits cabem em um servidor com 8 GPUs.
StepFun Step 5 Preview: modelo de 600B para agentes, com pesos abertos
O Step 5 Preview da StepFun, um modelo de 600B parâmetros com 27B ativos e contexto de 1M de tokens, chegou ao Hugging Face após um mês só na API, a US$ 1/US$ 2,70 por milhão.
Ling-3.1-flash: Ant Group abre modelo de 560B sob licença MIT
A inclusionAI, do Ant Group, publicou os pesos do Ling-3.1-flash sob a licença MIT: 560B parâmetros, 25B ativos por token e contexto de 1M de tokens.