Nvidia Nemotron 3.5 Super VL chega com pesos abertos de 120B
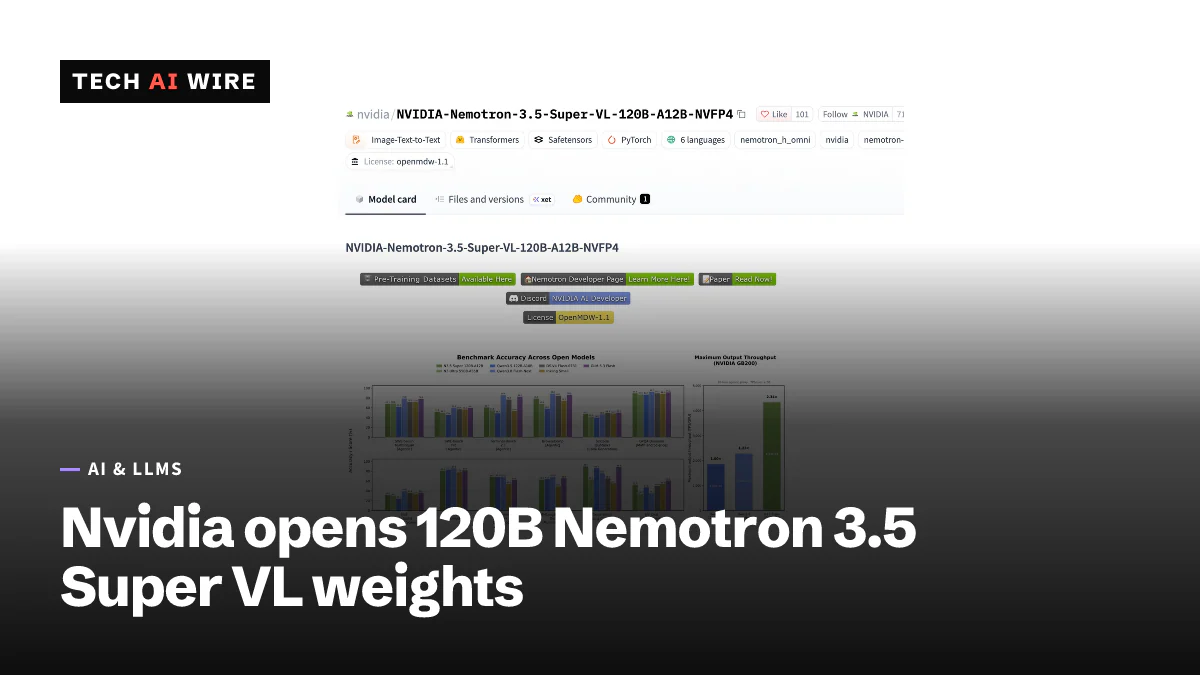
O Nemotron 3.5 Super VL da Nvidia é um modelo de pesos abertos com 120B de parâmetros, 12B ativos, que lê texto, imagens e vídeo, sob a licença OpenMDW.
3 min de leitura
Em números
- total parameters / parameters active per token
- 120B / 12B
- tokens of context, at most
- 1M
- SWE-bench Verified score of the BF16 model, per Nvidia's model card
- 71.1
- per GPU per year for Nvidia's production software license
- $4,500
- Super VL, base
- 28%
- Claude Opus 5
- 38%
- Super VL, post-trained
- 72%
A Nvidia lançou o Nemotron 3.5 Super VL em 15 de outubro de 2026, um modelo de IA de pesos abertos que lê texto, imagens e vídeo e responde em texto. Ele tem 120 bilhões de parâmetros, mas só 12 bilhões trabalham em cada token, o que o mantém rápido e barato de rodar. A Nvidia lista um único desktop DGX Spark entre as configurações suportadas, então equipes podem rodar um modelo multimodal capaz em hardware próprio.
"Pesos abertos" (open weight) significa que qualquer pessoa pode baixar o modelo treinado e rodá-lo. "VL" quer dizer vision-language (visão e linguagem): o modelo recebe imagens e vídeos como entrada, não só texto.
O que a Nvidia lançou
O Super VL é um dos três modelos Nemotron 3.5 que a Nvidia anunciou em 15 de outubro, segundo o VentureBeat:
| Modelo | Tamanho | Feito para |
|---|---|---|
| Super VL | 120B no total, 12B ativos | Documentos, gráficos, telas e vídeo para agentes |
| Bolt 74B-A9B | 74B no total, 9B ativos, 24GB | Agentes em máquinas locais |
| Bolt E4B | 4GB | Chat e agentes no próprio dispositivo, previsto para 23 de outubro |
Os pesos do Super VL estão no Hugging Face sob a licença OpenMDW, versão 1.1. O card do modelo diz que ele "está pronto para uso comercial ou não comercial".
Como o modelo é construído
O Super VL é um modelo mixture-of-experts (MoE). Cada camada tem 512 pequenas redes especialistas, e um roteador escolhe algumas delas para cada token. O modelo mistura três tipos de camadas: Mamba-2, atenção padrão e MoE. O Mamba-2 é uma arquitetura que lida com entradas longas a baixo custo. Um codificador de visão chamado C-RADIO transforma imagens em entradas que o modelo consegue ler.
A Nvidia entrega os pesos em duas precisões. A versão BF16 é a referência completa. A versão NVFP4 guarda a maior parte dos pesos em 4 bits para economizar memória e foi treinada para igualar o modelo BF16. O card informa apenas pequenas diferenças entre as duas.
Outros detalhes do card:
- Até 1 milhão de tokens de contexto, dependendo da configuração.
- Entrada de vídeo em arquivos MP4 de até 2 minutos.
- Multi-token prediction, que rascunha vários tokens de uma vez para acelerar as respostas.
- Configurações suportadas que vão de um DGX Spark ou um GB200 a duas placas H100. Execuções locais também funcionam em RTX Spark e RTX Pro 6000 via llama.cpp ou Unsloth.
As alegações de benchmark
O card do modelo da Nvidia lista pontuações gerais fortes para o modelo BF16. Entre elas estão 71,10 no SWE-bench Verified, um teste de programação, e 89,52 no GPQA-Diamond, um teste de ciências. Ele marca 51,14 no OSWorld-Verified, que mede o quão bem um modelo opera um computador.
A alegação principal pede cuidado. A Nvidia diz que versões do Super VL pós-treinadas para cinco tarefas específicas superam o Claude Opus 5 e o GPT-6.1 Sol nessas tarefas. Em sinistros de seguro, a precisão subiu de cerca de 28% para 72%, contra cerca de 38% do Claude Opus 5. O VentureBeat observa que a Nvidia não publicou as definições das tarefas, os tamanhos das amostras nem o método de teste.
Em inteligência geral, o Super VL marca cerca de 26 no índice da Artificial Analysis, informa o VentureBeat. O GLM-5.3-Flash marca 42 e o Qwen3.8-Flash-Next, 40. Sua vantagem é a velocidade: cerca de 625 tokens por segundo em quatro GPUs B200, contra cerca de 125 do Inkling Small, um modelo com pontuação parecida.
Licença e custo
Os pesos são gratuitos sob a OpenMDW. A Nvidia também vende uma licença de software para produção a US$ 4.500 por GPU por ano, segundo o VentureBeat. A Modal, um provedor de nuvem, já oferece o modelo em endpoints dedicados cobrados por segundo.
O lançamento chega enquanto a Nvidia espera concluir a compra do Hugging Face, que cobrimos quando a Nvidia confirmou o negócio. O VentureBeat diz que a conclusão do negócio é esperada para o primeiro semestre de 2027.
O que isso significa para desenvolvedores
O Super VL é um forte candidato se você precisa de um único modelo que leia capturas de tela, documentos digitalizados e vídeos curtos, e quer hospedá-lo você mesmo. Comece pela versão NVFP4 em hardware Blackwell, onde o card da Nvidia diz que a matemática de 4 bits roda nativamente.
Não o escolha para raciocínio puro. Sua pontuação no índice fica atrás de vários modelos abertos que são menores de servir. Seu argumento é a velocidade por GPU, mais a opção de fazer fine-tuning para uma tarefa específica.
Esse segundo ponto é a verdadeira lição do gráfico da Nvidia. Um modelo pós-treinado com 12B ativos superou modelos de fronteira em suas próprias tarefas específicas. Se você tem uma tarefa repetível e seus próprios dados rotulados, teste um modelo aberto ajustado antes de pagar preços de fronteira em cada chamada. Verifique os termos da OpenMDW com sua equipe jurídica antes de lançar, como faria com qualquer licença nova.
Fontes
Artigos relacionados
Meta Muse Spark Open lança 816B de pesos abertos
A Meta lançou o Muse Spark Open, um modelo de pesos abertos com 816B parâmetros, 42B ativos e contexto de 1M de tokens, no Hugging Face e em três plataformas de nuvem.

Mistral Large 4 chega com 1,05 trilhão de parâmetros
O Mistral Large 4 é um modelo MoE de pesos abertos com 1,05 trilhão de parâmetros e contexto de 1 milhão de tokens. A prévia da API custa US$ 1,36 por milhão de tokens de entrada. Os pesos saem em outubro.
Reflection AI lança Beam, um modelo de pesos abertos com 501 bilhões de parâmetros
O Beam, da Reflection AI, tem 501 bilhões de parâmetros, mas usa 23 bilhões por token, marca 80,9 no SWE-Bench Verified e terá os pesos publicados sob Apache 2.0 ainda em outubro.