Modelos de decisão de IA, explicados
Um modelo de decisão escolhe entre respostas fixas e devolve uma probabilidade para cada uma, em vez de escrever texto. Os preços hospedados começam em US$ 0,02 por milhão de tokens.
5 min de leitura
Em números
- lowest hosted price per million input tokens (Perplexity)
- $0.02
- for output tokens at TypeSafe, OpenAI, Perplexity and Microsoft
- $0
- one d1-3B decision on an RTX 4090, per Liquid AI
- 8 ms
- gap between the cheapest and dearest hosted price
- 12x
- pplx-decider
- 2¢
- Clef-flash
- 3.8¢
- Jev
- 4.2¢
- Microsoft-Decision-1
- 4.2¢
- OpenAI gpt-6-luna
- 10¢
- Clef-omni
- 15¢
- Clef
- 24¢
Um modelo de decisão é um modelo de IA que escolhe entre um conjunto fixo de respostas e devolve uma probabilidade para cada uma, em vez de escrever texto. Pelo menos oito empresas lançaram um desde meados de setembro de 2026, do Jev da TypeSafe a modelos da Cloudflare, AWS, Perplexity, Liquid AI, OpenAI e Microsoft. Eles importam porque agentes de IA tomam muitas pequenas decisões de sim ou não, ou de escolher uma opção. Um modelo de decisão as toma mais rápido e mais barato do que um chatbot.
Como funciona um modelo de decisão
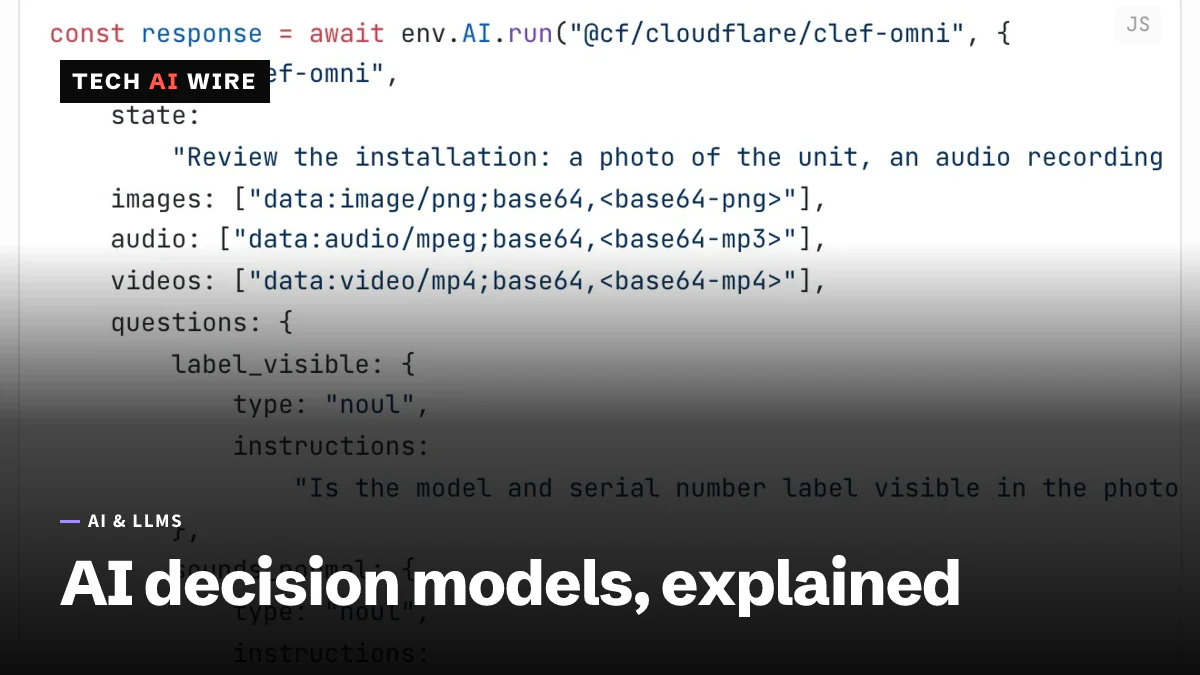
Um modelo de chatbot escreve sua resposta um pedaço de palavra, ou token, de cada vez. Um modelo de decisão não escreve nada. Um app envia a ele uma entrada, chamada state, junto com uma lista de perguntas com respostas fixas. O modelo devolve uma probabilidade para cada resposta permitida.
A TypeSafe, que iniciou a categoria com o Jev, descreve isso como uma chamada de função. "Entra um state não estruturado, saem decisões probabilísticas tipadas", disse Diogo Almeida, founder da TypeSafe. "Tipadas" significa que a resposta sempre tem o formato esperado. Uma pergunta de sim ou não só pode voltar como sim ou não.
A maioria dos fornecedores oferece os mesmos três tipos de pergunta, embora os nomes variem:
| Tipo de pergunta | O que devolve | Nomes usados |
|---|---|---|
| Sim ou não | A probabilidade de a resposta ser sim | noul (Cloudflare, Perplexity, Laya), predicate (OpenAI) |
| Escolher uma | Uma probabilidade para cada opção | choice |
| Avaliar | Um nível numa escala, ponderado pela probabilidade | score |
A velocidade vem de pular a geração de texto. A equipe do Strands na AWS diz que removeu a parte do modelo que produz palavras. Por isso, o Decider "sempre produz uma resposta entre as opções selecionadas". A Cloudflare diz que o Clef lê a entrada uma vez e depois pontua em paralelo todas as respostas válidas. A Liquid AI resume de forma simples: seus modelos d1 "não produzem tokens, mas respondem em uma única passagem direta".
As probabilidades devem ser calibradas. Isso significa que uma resposta marcada como 80% segura deveria estar certa cerca de 80% das vezes. Um app pode usar esse número para agir, consultar uma pessoa ou passar a pergunta a um modelo maior.
Os modelos até agora
| Modelo | Fabricante | Pesos | Baseado em | Preço de entrada hospedado por milhão de tokens |
|---|---|---|---|---|
| Jev | TypeSafe | Serviço hospedado | Não informado | US$ 0,042 |
| Laya | Convai Innovations | Abertos, Apache 2.0 | ModernBERT-large, 421M | Nenhum (auto-hospedado) |
| Clef | Cloudflare | Abertos, Apache 2.0 | Qwen3.8-27B | US$ 0,24 |
| Clef-flash | Cloudflare | Abertos, Apache 2.0 | Qwen3.5-9B | US$ 0,038 |
| Clef-omni | Cloudflare | Abertos | Mixture of experts de 30B, 3B ativos | US$ 0,15 |
| Strands Decider 2B | Equipe do Strands na AWS | Código aberto | Qwen3.5-2B | Não informado |
| pplx-decider | Perplexity | Abertos, Apache 2.0 | Qwen3.8-27B | US$ 0,02 |
| d1-3B, d1-omni-600M | Liquid AI | Abertos | Modelos LFM2.5 da Liquid | Não informado |
| Decisions API | OpenAI | Serviço hospedado | gpt-6-luna | US$ 0,10 |
| Microsoft-Decision-1 | Microsoft | Serviço hospedado | Qwen3.5-9B | US$ 0,042 |
TypeSafe, OpenAI, Perplexity e Microsoft dizem que os tokens de saída são gratuitos, então só a entrada é cobrada. A documentação da Perplexity lista US$ 0,02 por milhão de tokens de entrada para o pplx-decider. A reportagem da AlphaSignal sobre o lançamento de 1º de outubro indicava US$ 0,04. Por isso, confira o preço atual antes de fazer o orçamento.
O que mudou e quando
O setor passou de um modelo para dez em um mês:
| Data | Lançamento |
|---|---|
| 15 de setembro de 2026 | A TypeSafe lança o Jev |
| Setembro de 2026 | A Convai Innovations lança o Laya com pesos abertos |
| 1º de outubro de 2026 | Cloudflare Clef, Strands Decider 2B e o pplx-decider da Perplexity |
| 7 de outubro de 2026 | A Liquid AI lança o d1-3B e o d1-omni-600M |
| 9 de outubro de 2026 | A Cloudflare adiciona o Clef-omni e reduz o Clef-flash de US$ 0,090 para US$ 0,038 |
| Outubro de 2026 | A Decisions API da OpenAI em beta pública; Microsoft-Decision-1 no Foundry |
Os tipos de entrada se ampliaram no caminho. O Laya lê apenas texto, e o Clef aceita imagens desde o lançamento. O Clef-omni agora também aceita áudio e vídeo, segundo o changelog da Cloudflare. O d1-omni-600M da Liquid AI recebe texto com imagens ou com áudio. A OpenAI diz esperar que sua API saia do beta "nas próximas semanas".
Quão rápidos eles são
A velocidade é o principal argumento de venda, e cada número vem da empresa que criou o modelo. A Liquid AI diz que o d1-3B responde a uma pergunta em 8 ms numa placa de vídeo Nvidia RTX 4090. A equipe do Laya relata 32,8 ms numa Nvidia T4. A equipe do Strands mediu uma mediana de cerca de 115 ms numa RTX 3090. A TypeSafe informa para o Jev uma faixa de 70 a 500 ms.
O custo por decisão é mínimo. O InfoWorld faz as contas com os números da Microsoft: US$ 1 cobre mais de 275.000 decisões curtas semelhantes. O InfoWorld observa que esses números são afirmações da própria Microsoft.
Os benchmarks são mais difíceis de comparar. Cada empresa publica suas próprias tabelas. A AlphaSignal relata que o pplx-decider marcou 85,71% em 11 benchmarks, contra 84,51% do Jev. Mas não diz quem fez os testes.
Onde eles ficam aquém
Um modelo de decisão não consegue se explicar nem escrever nada. A equipe do Strands diz que o Decider é bem pior que os modelos de raciocínio em problemas complexos. Ele também não serve para programação, chatbots ou resumos. A equipe do Laya recomenda menos de 20 opções por pergunta, porque a precisão cai à medida que a lista cresce. Os testes da equipe também mostraram que o Laya acertou 0% em texto em khmer, enquanto indicava uma confiança média de 95,2%.
O InfoWorld cita analistas que levantam a mesma preocupação. "Uma probabilidade de aparência precisa pode dar a uma decisão incerta mais autoridade do que ela merece", disse Amit Kumar Jena, development manager for AI na Kanerika.
O que isso significa para desenvolvedores
Use um modelo de decisão para as escolhas de rotina dentro de um agente: encaminhar um ticket de suporte, escolher uma ferramenta, checar uma regra de segurança ou avaliar uma saída. Reserve um modelo de linguagem completo para os casos que exigem raciocínio ou texto. A equipe do Strands sugere justamente esse tipo de agente híbrido.
Teste a calibração com seus próprios dados antes de confiar nos números. Rode algumas centenas de casos antigos com respostas conhecidas. Confira se 80% de confiança significa mesmo 80% de acertos. Comece por decisões reversíveis, como recomendam analistas que o InfoWorld cita.
Compare os preços com o seu tráfego real. O custo de uma solicitação depende de quantos tokens de entrada ela envia. Os preços hospedados variam em até doze vezes, de US$ 0,02 a US$ 0,24 por milhão. Além disso, o Clef segue a API do Jev, então testá-lo pode ser quase só trocar um endereço web.
Se os dados precisam ficar dentro de casa, os modelos abertos são o caminho. Laya, Clef, Decider, pplx-decider e o d1 da Liquid AI podem rodar no seu próprio hardware.
Fontes
- Introducing System One Models & Jev - TypeSafe AI
- Clef: open-weight decision models - Cloudflare Blog
- Clef-omni adds audio and video input, Clef-flash is now cheaper, and Clef is faster - Cloudflare Changelog
- Introducing Strands Decider - Strands Agents
- Decisions API guide - OpenAI
- Decisions API quickstart - Perplexity
- Multimodal open d1 decision models for the edge - Liquid AI on Hugging Face
- Perplexity Releases pplx-decider, a 27B Open Model That Replaces Label Parsing - AlphaSignal
- Microsoft separates decision-making from generative AI with a new model - InfoWorld
- Laya - System 1 decision engine with calibrated probabilities - Convai Innovations
Artigos relacionados
Meta lança o Muse Wonder, seu primeiro modelo de fronteira
A Meta lançou o Muse Wonder em 12 de outubro a US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída. O modelo maior, Wonder Full, fica restrito ao Muse Code.

Mistral Large 4 chega com 1,05 trilhão de parâmetros
O Mistral Large 4 é um modelo MoE de pesos abertos com 1,05 trilhão de parâmetros e contexto de 1 milhão de tokens. A prévia da API custa US$ 1,36 por milhão de tokens de entrada. Os pesos saem em outubro.

Xiaomi lança MiMo-V2.6-Pro com 1 trilhão de parâmetros em pesos abertos sob MIT
O MiMo-V2.6-Pro da Xiaomi tem 1,02 trilhão de parâmetros, 42 bilhões ativos, contexto de 1 milhão de tokens e pesos sob licença MIT, mas precisa de cerca de 680 GB de memória de GPU.