KI-Entscheidungsmodelle, erklärt
Ein Entscheidungsmodell wählt aus festen Antworten und gibt für jede eine Wahrscheinlichkeit zurück, statt Text zu schreiben. Gehostete Preise beginnen bei 0,02 $ pro Million Tokens.
5 Min. Lesezeit
Die Zahlen
- lowest hosted price per million input tokens (Perplexity)
- $0.02
- for output tokens at TypeSafe, OpenAI, Perplexity and Microsoft
- $0
- one d1-3B decision on an RTX 4090, per Liquid AI
- 8 ms
- gap between the cheapest and dearest hosted price
- 12x
- pplx-decider
- 2¢
- Clef-flash
- 3.8¢
- Jev
- 4.2¢
- Microsoft-Decision-1
- 4.2¢
- OpenAI gpt-6-luna
- 10¢
- Clef-omni
- 15¢
- Clef
- 24¢
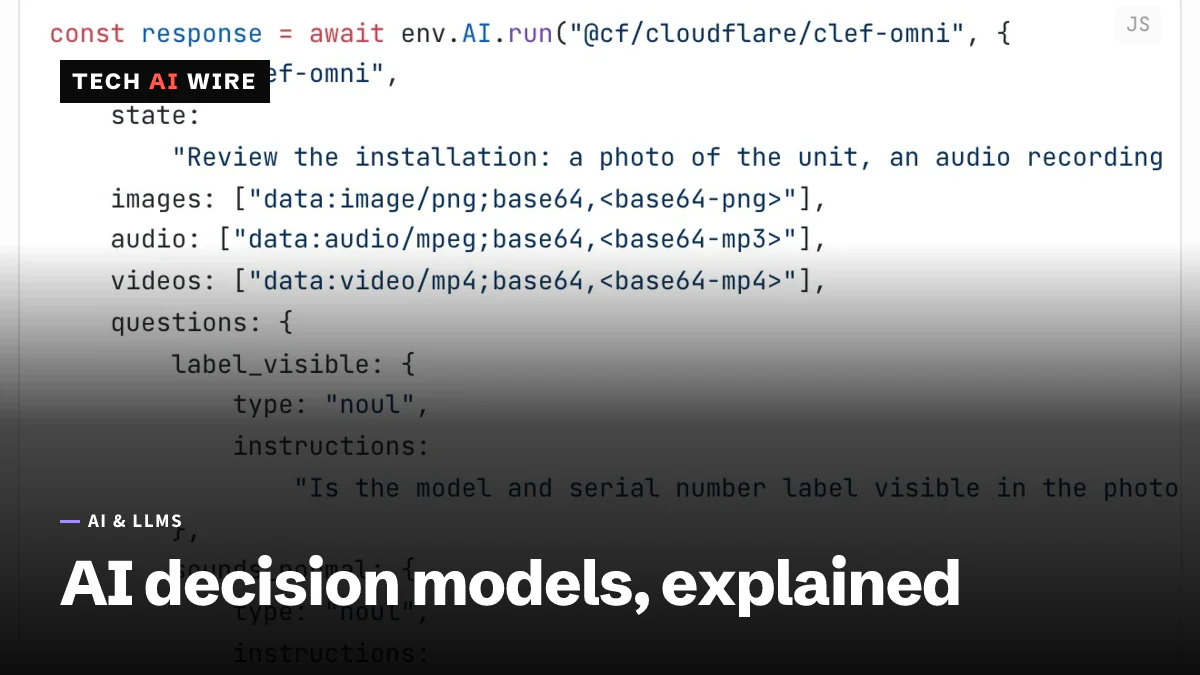
Ein Entscheidungsmodell ist ein KI-Modell, das aus einer festen Menge von Antworten wählt und für jede eine Wahrscheinlichkeit zurückgibt, statt Text zu schreiben. Mindestens acht Unternehmen haben seit Mitte September 2026 eines veröffentlicht, von Jev von TypeSafe bis zu Modellen von Cloudflare, AWS, Perplexity, Liquid AI, OpenAI und Microsoft. Das ist wichtig, weil KI-Agenten viele kleine Ja-oder-Nein- und Wähle-eins-Entscheidungen treffen. Ein Entscheidungsmodell trifft sie schneller und günstiger, als ein Chatbot es kann.
Wie ein Entscheidungsmodell funktioniert
Ein Chatbot-Modell schreibt seine Antwort Wortstück für Wortstück, also Token für Token. Ein Entscheidungsmodell schreibt überhaupt nicht. Eine App schickt ihm eine Eingabe, den sogenannten State, plus eine Liste von Fragen mit festen Antworten. Das Modell gibt für jede erlaubte Antwort eine Wahrscheinlichkeit zurück.
TypeSafe, das die Kategorie mit Jev begründet hat, beschreibt es als Funktionsaufruf. „Unstrukturierter State hinein, typisierte probabilistische Entscheidungen heraus“, sagte Diogo Almeida, founder von TypeSafe. „Typisiert“ heißt, dass die Antwort immer die erwartete Form hat. Eine Ja-oder-Nein-Frage kann nur als Ja oder Nein zurückkommen.
Die meisten Anbieter bieten dieselben drei Fragearten an, auch wenn die Namen sich unterscheiden:
| Frageart | Was sie zurückgibt | Verwendete Namen |
|---|---|---|
| Ja oder Nein | Die Wahrscheinlichkeit, dass die Antwort Ja ist | noul (Cloudflare, Perplexity, Laya), predicate (OpenAI) |
| Eins wählen | Eine Wahrscheinlichkeit für jede Option | choice |
| Bewerten | Eine Stufe auf einer Skala, gewichtet nach Wahrscheinlichkeit | score |
Die Geschwindigkeit kommt daher, dass die Textgenerierung wegfällt. Das Strands-Team bei AWS sagt, es habe den Teil des Modells entfernt, der Wörter erzeugt. Deshalb liefert Decider laut dem Team „immer eine Antwort aus den ausgewählten Optionen“. Cloudflare sagt, Clef lese die Eingabe einmal und bewerte dann alle gültigen Antworten parallel. Liquid AI sagt es einfach: Seine d1-Modelle „erzeugen keine Tokens, sondern antworten in einem einzigen Vorwärtsdurchlauf“.
Die Wahrscheinlichkeiten sollen kalibriert sein. Das heißt: Eine Antwort, die zu 80 % sicher ist, sollte in etwa 80 % der Fälle stimmen. Eine App kann mit dieser Zahl handeln, einen Menschen fragen oder die Frage an ein größeres Modell weitergeben.
Die bisherigen Modelle
| Modell | Hersteller | Gewichte | Basis | Gehosteter Eingabepreis pro Million Tokens |
|---|---|---|---|---|
| Jev | TypeSafe | Gehosteter Dienst | Nicht angegeben | 0,042 $ |
| Laya | Convai Innovations | Offen, Apache 2.0 | ModernBERT-large, 421M | Keiner (selbst gehostet) |
| Clef | Cloudflare | Offen, Apache 2.0 | Qwen3.8-27B | 0,24 $ |
| Clef-flash | Cloudflare | Offen, Apache 2.0 | Qwen3.5-9B | 0,038 $ |
| Clef-omni | Cloudflare | Offen | 30B Mixture of Experts, 3B aktiv | 0,15 $ |
| Strands Decider 2B | Strands-Team von AWS | Open Source | Qwen3.5-2B | Nicht angegeben |
| pplx-decider | Perplexity | Offen, Apache 2.0 | Qwen3.8-27B | 0,02 $ |
| d1-3B, d1-omni-600M | Liquid AI | Offen | LFM2.5-Modelle von Liquid | Nicht angegeben |
| Decisions API | OpenAI | Gehosteter Dienst | gpt-6-luna | 0,10 $ |
| Microsoft-Decision-1 | Microsoft | Gehosteter Dienst | Qwen3.5-9B | 0,042 $ |
TypeSafe, OpenAI, Perplexity und Microsoft sagen alle, dass Ausgabe-Tokens kostenlos sind. Abgerechnet wird also nur die Eingabe. Die Dokumentation von Perplexity nennt 0,02 $ pro Million Eingabe-Tokens für pplx-decider. Der Bericht von AlphaSignal zum Start am 1. Oktober nannte 0,04 $. Prüfen Sie also den aktuellen Preis, bevor Sie Budget einplanen.
Was sich wann geändert hat
Das Feld wuchs innerhalb eines Monats von einem Modell auf zehn:
| Datum | Veröffentlichung |
|---|---|
| 15. September 2026 | TypeSafe bringt Jev heraus |
| September 2026 | Convai Innovations veröffentlicht Laya mit offenen Gewichten |
| 1. Oktober 2026 | Cloudflare Clef, Strands Decider 2B und pplx-decider von Perplexity |
| 7. Oktober 2026 | Liquid AI veröffentlicht d1-3B und d1-omni-600M |
| 9. Oktober 2026 | Cloudflare ergänzt Clef-omni und senkt Clef-flash von 0,090 $ auf 0,038 $ |
| Oktober 2026 | Decisions API von OpenAI in der öffentlichen Beta; Microsoft-Decision-1 in Foundry |
Die Eingaben wurden dabei breiter. Laya liest nur Text, und Clef nahm von Anfang an Bilder an. Clef-omni akzeptiert jetzt auch Audio und Video, laut Cloudflares Changelog. d1-omni-600M von Liquid AI nimmt Text zusammen mit Bildern oder mit Audio. OpenAI erwartet, dass seine API die Beta „in den kommenden Wochen“ verlässt.
Wie schnell sie sind
Geschwindigkeit ist das wichtigste Verkaufsargument, und jede Zahl stammt vom Unternehmen, das das Modell gebaut hat. Liquid AI sagt, d1-3B beantworte eine Frage in 8 ms auf einer Nvidia-Grafikkarte RTX 4090. Das Laya-Team meldet 32,8 ms auf einer Nvidia T4. Das Strands-Team maß einen Median von etwa 115 ms auf einer RTX 3090. TypeSafe gibt für Jev eine Spanne von 70 bis 500 ms an.
Die Kosten pro Entscheidung sind winzig. InfoWorld rechnet die Zahlen von Microsoft durch: 1 $ deckt mehr als 275.000 ähnliche kurze Entscheidungen. InfoWorld merkt an, dass diese Zahlen Angaben von Microsoft selbst sind.
Benchmarks lassen sich schwerer vergleichen. Jedes Unternehmen veröffentlicht seine eigenen Tabellen. AlphaSignal berichtet, pplx-decider habe über 11 Benchmarks 85,71 % erreicht, gegenüber 84,51 % für Jev. Der Bericht sagt aber nicht, wer die Tests durchgeführt hat.
Wo sie an Grenzen stoßen
Ein Entscheidungsmodell kann sich nicht erklären und nichts schreiben. Das Strands-Team sagt, Decider sei bei komplexen Problemen deutlich schlechter als Reasoning-Modelle. Für Programmieren, Chatbots oder Zusammenfassungen eigne es sich nicht. Das Laya-Team empfiehlt weniger als 20 Optionen pro Frage, weil die Genauigkeit mit längerer Liste sinkt. Seine Tests ergaben auch, dass Laya bei Khmer-Text 0 % erreichte und dabei eine durchschnittliche Konfidenz von 95,2 % meldete.
InfoWorld zitiert Fachleute aus der Analyse, die dieselbe Sorge äußern. „Eine präzise wirkende Wahrscheinlichkeit kann einer unsicheren Entscheidung mehr Autorität geben, als sie verdient“, sagte Amit Kumar Jena, development manager for AI bei Kanerika.
Was das für Entwickler bedeutet
Setzen Sie ein Entscheidungsmodell für die Routineentscheidungen in einem Agenten ein: ein Support-Ticket weiterleiten, ein Werkzeug auswählen, eine Schutzregel prüfen oder eine Ausgabe bewerten. Behalten Sie ein vollständiges Sprachmodell für die Fälle, die Schlussfolgern oder Text brauchen. Das Strands-Team schlägt genau diese Art von hybridem Agenten vor.
Testen Sie die Kalibrierung mit Ihren eigenen Daten, bevor Sie den Zahlen vertrauen. Nehmen Sie einige hundert frühere Fälle mit bekannten Antworten und prüfen Sie, ob 80 % Konfidenz wirklich 80 % Treffer bedeuten. Beginnen Sie mit Entscheidungen, die sich rückgängig machen lassen, wie die von InfoWorld zitierten Fachleute raten.
Vergleichen Sie die Preise mit Ihrem echten Datenverkehr. Die Kosten einer Anfrage hängen davon ab, wie viele Eingabe-Tokens sie sendet. Die gehosteten Preise unterscheiden sich um das Zwölffache, von 0,02 $ bis 0,24 $ pro Million. Clef folgt außerdem der API von Jev, sodass ein Test fast nur eine Änderung der Webadresse sein kann.
Wenn Daten im Haus bleiben müssen, sind die offenen Modelle der Weg. Laya, Clef, Decider, pplx-decider und d1 von Liquid AI laufen alle auf eigener Hardware.
Quellen
- Introducing System One Models & Jev - TypeSafe AI
- Clef: open-weight decision models - Cloudflare Blog
- Clef-omni adds audio and video input, Clef-flash is now cheaper, and Clef is faster - Cloudflare Changelog
- Introducing Strands Decider - Strands Agents
- Decisions API guide - OpenAI
- Decisions API quickstart - Perplexity
- Multimodal open d1 decision models for the edge - Liquid AI on Hugging Face
- Perplexity Releases pplx-decider, a 27B Open Model That Replaces Label Parsing - AlphaSignal
- Microsoft separates decision-making from generative AI with a new model - InfoWorld
- Laya - System 1 decision engine with calibrated probabilities - Convai Innovations
Ähnliche Artikel
Meta Muse Wonder startet als erstes Frontier-Modell des Konzerns
Meta hat Muse Wonder am 12. Oktober für 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token veröffentlicht. Das größere Wonder Full bleibt Muse Code vorbehalten.

Mistral Large 4 startet mit 1,05 Billionen Parametern
Mistral Large 4 ist ein Open-Weight-MoE-Modell mit 1,05 Billionen Parametern und 1 Million Token Kontext. Die API-Vorschau kostet 1,36 $ pro Million Eingabetoken. Die Gewichte folgen im Oktober.

Xiaomi veröffentlicht MiMo-V2.6-Pro mit 1 Billion Parametern als offene Gewichte unter MIT
Xiaomis MiMo-V2.6-Pro hat 1,02 Billionen Parameter, davon 42 Milliarden aktiv, einen Kontext von 1 Million Tokens und MIT-lizenzierte Gewichte, braucht aber rund 680 GB GPU-Speicher.