Les modèles de décision en IA, expliqués
Un modèle de décision choisit parmi des réponses fixes et renvoie une probabilité pour chacune, au lieu d'écrire du texte. Les prix hébergés démarrent à 0,02 $ par million de tokens.
5 min de lecture
En chiffres
- lowest hosted price per million input tokens (Perplexity)
- $0.02
- for output tokens at TypeSafe, OpenAI, Perplexity and Microsoft
- $0
- one d1-3B decision on an RTX 4090, per Liquid AI
- 8 ms
- gap between the cheapest and dearest hosted price
- 12x
- pplx-decider
- 2¢
- Clef-flash
- 3.8¢
- Jev
- 4.2¢
- Microsoft-Decision-1
- 4.2¢
- OpenAI gpt-6-luna
- 10¢
- Clef-omni
- 15¢
- Clef
- 24¢
Un modèle de décision est un modèle d'IA qui choisit parmi un ensemble fixe de réponses et renvoie une probabilité pour chacune, au lieu d'écrire du texte. Au moins huit entreprises en ont lancé un depuis la mi-septembre 2026, du Jev de TypeSafe aux modèles de Cloudflare, AWS, Perplexity, Liquid AI, OpenAI et Microsoft. Ils comptent parce que les agents d'IA prennent beaucoup de petites décisions du type oui ou non, ou choisir une option. Un modèle de décision les prend plus vite et pour moins cher qu'un chatbot.
Comment fonctionne un modèle de décision
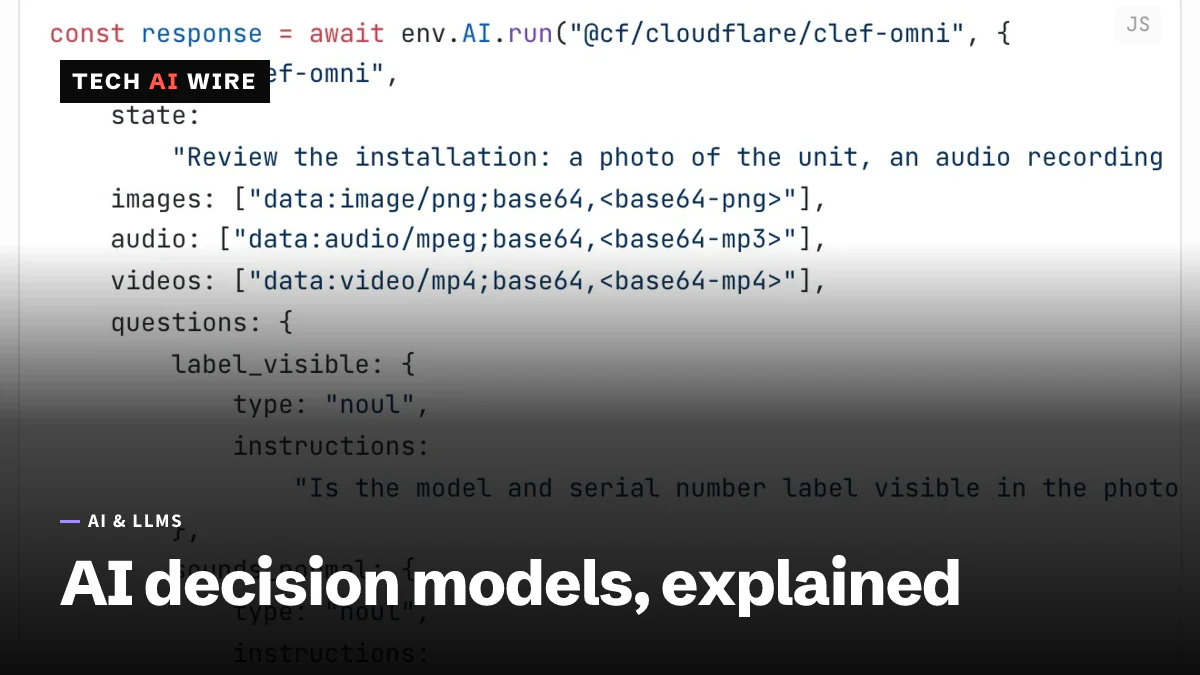
Un modèle de chatbot écrit sa réponse un morceau de mot, ou token, à la fois. Un modèle de décision n'écrit rien du tout. Une application lui envoie une entrée, appelée le state, ainsi qu'une liste de questions aux réponses fixes. Le modèle renvoie une probabilité pour chaque réponse autorisée.
TypeSafe, qui a lancé la catégorie avec Jev, la décrit comme un appel de fonction. « Un state non structuré en entrée, des décisions probabilistes typées en sortie », a déclaré Diogo Almeida, founder de TypeSafe. « Typé » signifie que la réponse a toujours la forme attendue. Une question oui ou non ne peut revenir qu'avec oui ou non.
La plupart des fournisseurs proposent les trois mêmes types de questions, même si les noms diffèrent :
| Type de question | Ce qu'il renvoie | Noms utilisés |
|---|---|---|
| Oui ou non | La probabilité que la réponse soit oui | noul (Cloudflare, Perplexity, Laya), predicate (OpenAI) |
| Choisir une option | Une probabilité pour chaque option | choice |
| Noter | Un niveau sur une échelle, pondéré par la probabilité | score |
La vitesse vient de l'absence de génération de texte. L'équipe Strands d'AWS dit avoir retiré la partie du modèle qui produit les mots. Ainsi, Decider « produit toujours une réponse parmi les options sélectionnées ». Cloudflare explique que Clef lit l'entrée une seule fois, puis note en parallèle tous les choix valides. Liquid AI le résume simplement : ses modèles d1 « ne produisent pas de tokens mais répondent en une seule passe avant ».
Les probabilités sont censées être calibrées. Une réponse donnée comme sûre à 80 % devrait donc être juste environ 80 % du temps. Une application peut utiliser ce chiffre pour agir, demander à un humain ou confier la question à un modèle plus grand.
Les modèles disponibles à ce jour
| Modèle | Éditeur | Poids | Basé sur | Prix d'entrée hébergé par million de tokens |
|---|---|---|---|---|
| Jev | TypeSafe | Service hébergé | Non précisé | 0,042 $ |
| Laya | Convai Innovations | Ouverts, Apache 2.0 | ModernBERT-large, 421M | Aucun (auto-hébergé) |
| Clef | Cloudflare | Ouverts, Apache 2.0 | Qwen3.8-27B | 0,24 $ |
| Clef-flash | Cloudflare | Ouverts, Apache 2.0 | Qwen3.5-9B | 0,038 $ |
| Clef-omni | Cloudflare | Ouverts | Mixture of experts de 30B, 3B actifs | 0,15 $ |
| Strands Decider 2B | Équipe Strands d'AWS | Open source | Qwen3.5-2B | Non précisé |
| pplx-decider | Perplexity | Ouverts, Apache 2.0 | Qwen3.8-27B | 0,02 $ |
| d1-3B, d1-omni-600M | Liquid AI | Ouverts | Modèles LFM2.5 de Liquid | Non précisé |
| Decisions API | OpenAI | Service hébergé | gpt-6-luna | 0,10 $ |
| Microsoft-Decision-1 | Microsoft | Service hébergé | Qwen3.5-9B | 0,042 $ |
TypeSafe, OpenAI, Perplexity et Microsoft indiquent tous que les tokens de sortie sont gratuits. Seule l'entrée est donc facturée. La documentation de Perplexity indique 0,02 $ par million de tokens d'entrée pour pplx-decider. Le compte rendu d'AlphaSignal lors du lancement du 1er octobre donnait 0,04 $. Vérifiez donc le prix actuel avant de prévoir un budget.
Ce qui a changé et quand
Le domaine est passé d'un modèle à dix en un mois :
| Date | Sortie |
|---|---|
| 15 septembre 2026 | TypeSafe lance Jev |
| Septembre 2026 | Convai Innovations publie Laya avec des poids ouverts |
| 1er octobre 2026 | Cloudflare Clef, Strands Decider 2B et pplx-decider de Perplexity |
| 7 octobre 2026 | Liquid AI publie d1-3B et d1-omni-600M |
| 9 octobre 2026 | Cloudflare ajoute Clef-omni et fait passer Clef-flash de 0,090 $ à 0,038 $ |
| Octobre 2026 | La Decisions API d'OpenAI en bêta publique ; Microsoft-Decision-1 dans Foundry |
Les types d'entrée se sont élargis en chemin. Laya ne lit que du texte, et Clef accepte les images depuis son lancement. Clef-omni accepte désormais aussi l'audio et la vidéo, selon le journal des modifications de Cloudflare. Le d1-omni-600M de Liquid AI prend du texte avec des images ou avec de l'audio. OpenAI dit s'attendre à ce que son API sorte de la bêta « dans les semaines à venir ».
Leur vitesse
La vitesse est le principal argument de vente, et chaque chiffre vient de l'entreprise qui a conçu le modèle. Liquid AI affirme que d1-3B répond à une question en 8 ms sur une carte graphique Nvidia RTX 4090. L'équipe de Laya annonce 32,8 ms sur une Nvidia T4. L'équipe Strands a mesuré une médiane d'environ 115 ms sur une RTX 3090. TypeSafe donne pour Jev une fourchette de 70 à 500 ms.
Le coût par décision est minime. InfoWorld fait le calcul avec les chiffres de Microsoft : 1 $ couvre plus de 275 000 décisions courtes similaires. InfoWorld note que ces chiffres sont les propres affirmations de Microsoft.
Les benchmarks sont plus difficiles à comparer. Chaque entreprise publie ses propres tableaux. AlphaSignal rapporte que pplx-decider a obtenu 85,71 % sur 11 benchmarks, contre 84,51 % pour Jev. Le média ne dit pas qui a mené les tests.
Leurs limites
Un modèle de décision ne peut ni s'expliquer ni écrire quoi que ce soit. L'équipe Strands indique que Decider est nettement moins bon que les modèles de raisonnement sur les problèmes complexes. Il ne convient pas non plus au code, aux chatbots ni aux résumés. L'équipe de Laya recommande moins de 20 options par question, car la précision baisse quand la liste s'allonge. Ses tests ont aussi montré que Laya obtenait 0 % sur du texte en khmer tout en affichant une confiance moyenne de 95,2 %.
Des analystes que cite InfoWorld expriment la même inquiétude. « Une probabilité d'apparence précise peut donner à une décision incertaine plus d'autorité qu'elle n'en mérite », a déclaré Amit Kumar Jena, development manager for AI chez Kanerika.
Ce que cela signifie pour les développeurs
Utilisez un modèle de décision pour les choix de routine au sein d'un agent : orienter un ticket de support, choisir un outil, vérifier une règle de sécurité ou noter une sortie. Gardez un vrai modèle de langage pour les cas qui demandent du raisonnement ou du texte. L'équipe Strands propose justement ce type d'agent hybride.
Testez le calibrage sur vos propres données avant de faire confiance aux chiffres. Faites passer quelques centaines de cas passés dont vous connaissez la réponse. Vérifiez que 80 % de confiance signifie vraiment 80 % de bonnes réponses. Commencez par des décisions réversibles, comme le conseillent des analystes que cite InfoWorld.
Comparez les prix sur votre trafic réel. Le coût d'une requête dépend du nombre de tokens d'entrée qu'elle envoie. Les prix hébergés varient du simple au douze, de 0,02 $ à 0,24 $ par million. Clef suit en outre l'API de Jev, si bien que l'essayer peut se résumer presque à changer d'adresse web.
Si les données doivent rester en interne, les modèles ouverts sont la voie à suivre. Laya, Clef, Decider, pplx-decider et le d1 de Liquid AI peuvent tous tourner sur votre propre matériel.
Sources
- Introducing System One Models & Jev - TypeSafe AI
- Clef: open-weight decision models - Cloudflare Blog
- Clef-omni adds audio and video input, Clef-flash is now cheaper, and Clef is faster - Cloudflare Changelog
- Introducing Strands Decider - Strands Agents
- Decisions API guide - OpenAI
- Decisions API quickstart - Perplexity
- Multimodal open d1 decision models for the edge - Liquid AI on Hugging Face
- Perplexity Releases pplx-decider, a 27B Open Model That Replaces Label Parsing - AlphaSignal
- Microsoft separates decision-making from generative AI with a new model - InfoWorld
- Laya - System 1 decision engine with calibrated probabilities - Convai Innovations
Articles liés
Meta lance Muse Wonder, son premier modèle frontière
Meta a lancé Muse Wonder le 12 octobre à 4 dollars par million de tokens en entrée et 20 dollars par million en sortie. Le modèle plus grand, Wonder Full, est réservé à Muse Code.

Mistral Large 4 arrive avec 1,05 billion de paramètres
Mistral Large 4 est un modèle MoE à poids ouverts de 1,05 billion de paramètres, avec un contexte de 1 million de tokens. L'aperçu API coûte 1,36 $ par million de tokens d'entrée. Les poids suivent en octobre.

Xiaomi publie MiMo-V2.6-Pro, 1 000 milliards de paramètres en poids ouverts sous MIT
Le MiMo-V2.6-Pro de Xiaomi compte 1 020 milliards de paramètres, dont 42 milliards actifs, un contexte de 1 million de tokens et des poids sous licence MIT, mais il demande environ 680 Go de mémoire GPU.