O Jev, da TypeSafe, devolve decisões tipadas, não texto
O Jev responde em 70 a 500 milissegundos e custa 0,042 dólar por milhão de tokens de entrada, com saída grátis. Ele não gera texto de jeito nenhum.
3 min de leitura

Em números
- end-to-end latency TypeSafe reports
- 70-500 ms
- per million input tokens, with output free
- $0.042
- type-error rate the company reports
- 0%
A TypeSafe AI apresentou em 15 de setembro de 2026 um modelo que não consegue escrever uma frase. O Jev recebe como entrada o estado desarrumado de um programa em execução e devolve um valor estruturado e tipado. O anúncio da empresa diz que ele produz esse valor inteiro em uma única passagem, e não token a token. A TypeSafe chama isso de modelo System One, uma classe que, segundo ela, foi feita para automação e não para conversa.
A troca é explícita. O Jev abandona por completo a geração de texto e, em troca, a empresa promete latência de 70 a 500 milissegundos e preço de entrada de 0,042 dólar por milhão de tokens, com a saída grátis.
O que um modelo System One faz de diferente
Um modelo de linguagem comum escreve da esquerda para a direita, escolhendo um token por vez, e uma resposta estruturada é algo que se arranca desse fluxo. A TypeSafe inverte isso. O Jev recebe a estrutura antes e a preenche de uma só vez.
As saídas carregam probabilidades calibradas. Ou seja, cada decisão vem com um número de confiança pensado para corresponder à frequência real de acerto. A TypeSafe diz ter treinado o modelo com um método que chama de Reinforcement Learning for Calibrated Decisions, e não com a abordagem RLHF dos modelos de conversa. O objetivo declarado são números de confiança que acompanhem a precisão real.
A Artificial Intelligence News relata um mecanismo concreto por trás do tamanho dessas escolhas. Em seleções com muitas opções, até 255, o Jev pontua os candidatos em duas etapas independentes antes de escolher.
O fundador é Diogo Almeida, que trabalhou na pesquisa do ChatGPT na OpenAI. Tanto a empresa quanto a Gigazine dizem que a TypeSafe passou dois anos em modo furtivo antes deste lançamento.
Os números, e quem os produziu
Todos os números abaixo vêm da TypeSafe ou de reportagens que reproduzem as afirmações dela. Ainda não existe nenhuma medição independente.
| Afirmação | Número |
|---|---|
| Latência | 70 a 500 milissegundos de ponta a ponta |
| Velocidade frente a modelos de fronteira | 40 a 200 vezes, segundo a TypeSafe; a Gigazine indica 20 a 200 vezes |
| Em fluxos de várias etapas | 193,6 vezes mais rápido e 444,6 vezes mais barato |
| Preço de entrada | 0,042 dólar por milhão de tokens, contra 0,20 a 10 dólares dos modelos de conversa |
| Erros de tipo | 0% |
| Demonstração | Um bot de DOOM a cerca de 10 consultas por segundo, a 7 dólares por hora |
O número do DOOM é o mais útil, porque é uma taxa e não uma proporção. Dez decisões por segundo a sete dólares a hora é um número que você pode comparar com a sua própria carga.
A afirmação principal exige cuidado. A TypeSafe diz que a alucinação é matematicamente impossível, e o mecanismo que descreve é a segurança de tipos: a saída precisa obedecer à estrutura que você definiu. Isso garante a forma de uma resposta, não a sua verdade. Uma decisão pode estar perfeitamente tipada, passar na validação e ainda assim estar errada. É exatamente para isso que serve o número de confiança.
O que isso significa para os desenvolvedores
A forma honesta de avaliar isso é como substituto de uma chamada específica, e não do seu modelo. Imagine um passo de um pipeline que pede a um LLM para escolher uma de um conjunto fixo de opções e devolver JSON. É essa a forma para a qual o Jev foi feito. Classificação, roteamento, ordenação e escolha de ferramenta se encaixam. Qualquer coisa que precise produzir prosa não se encaixa, porque o modelo não consegue.
Faça a conta da comparação com o seu próprio tráfego antes de acreditar nos multiplicadores. Tokens de saída grátis mudam a aritmética principalmente onde a resposta é pequena e a entrada é grande, que é exatamente a forma de uma chamada de decisão. Uma carga de resumo não teria benefício algum.
Trate os testes do fornecedor como este site tratou os números do CRM Bench da Salesforce: como uma afirmação a reproduzir, e não como uma medição para planejar. O número de 193,6 vezes é específico o suficiente para ser testável, então teste em uma decisão real da sua pilha.
Dois limites práticos antes de agendar qualquer coisa. O acesso é inicial, por lista de espera, com documentação em docs.typesafe.ai, então não é algo para colocar em produção esta semana. E a promessa de calibração é a parte para verificar você mesmo: registre os números de confiança ao lado dos resultados por uma semana e veja se um 0,7 significa mesmo setenta por cento.
Fontes
- Introducing System One Models & Jev - TypeSafe AI
- ChatGPT pioneer launches Jev model for programmatic logic - Artificial Intelligence News
- ChatGPT co-developers have created 'Jev', an AI model that processes tasks using a different method than LLM - Gigazine
Artigos relacionados
DeepSeek avisa desenvolvedores sobre aumento significativo nos preços da API
A DeepSeek avisou os desenvolvedores em 6 de agosto que os preços da API vão subir 'significativamente' em breve, sem números nem datas - enquanto o V4-Flash é o modelo conhecido mais barato de rodar.

GPT-6 Astra entra em disponibilidade geral no Bedrock e no Copilot
O GPT-6 Astra está em disponibilidade geral no Amazon Bedrock a US$ 10 por milhão de tokens de entrada, e no GitHub Copilot para os planos Pro+, Max, Business e Enterprise.
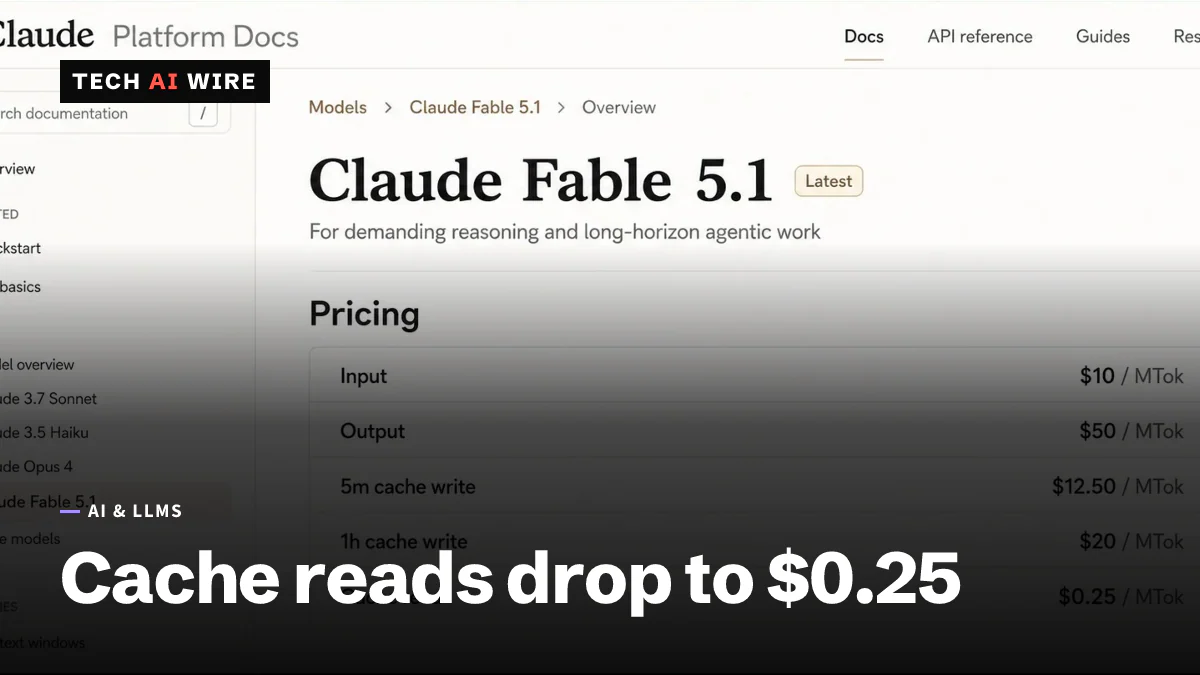
Claude Fable 5.1 corta 75% no custo de leitura de cache
O Fable 5.1 mantém entrada e saída em 10 e 50 dólares por milhão de tokens e baixa a leitura de cache de 1,00 para 0,25 dólar. O Mythos 5.1 segue por convite.