AIの意思決定モデルとは何か、解説
意思決定モデル(デシジョンモデル)は、テキストを書く代わりに、決められた答えの中から選び、それぞれの確率を返します。ホスト型の料金は入力100万トークン当たり0.02ドルからです。
5 分で読めます
数字で見る
- lowest hosted price per million input tokens (Perplexity)
- $0.02
- for output tokens at TypeSafe, OpenAI, Perplexity and Microsoft
- $0
- one d1-3B decision on an RTX 4090, per Liquid AI
- 8 ms
- gap between the cheapest and dearest hosted price
- 12x
- pplx-decider
- 2¢
- Clef-flash
- 3.8¢
- Jev
- 4.2¢
- Microsoft-Decision-1
- 4.2¢
- OpenAI gpt-6-luna
- 10¢
- Clef-omni
- 15¢
- Clef
- 24¢
意思決定モデルとは、テキストを書く代わりに、決められた答えの中から選び、それぞれに確率を返すAIモデルです。2026年9月中旬以降、少なくとも8社がこの種のモデルを出しました。TypeSafeのJevから、Cloudflare、AWS、Perplexity、Liquid AI、OpenAI、Microsoftのモデルまであります。AIエージェントは「はい・いいえ」や「1つを選ぶ」といった小さな判断を何度も行います。意思決定モデルは、それをチャットボットより速く安く処理できるため重要です。
意思決定モデルの仕組み
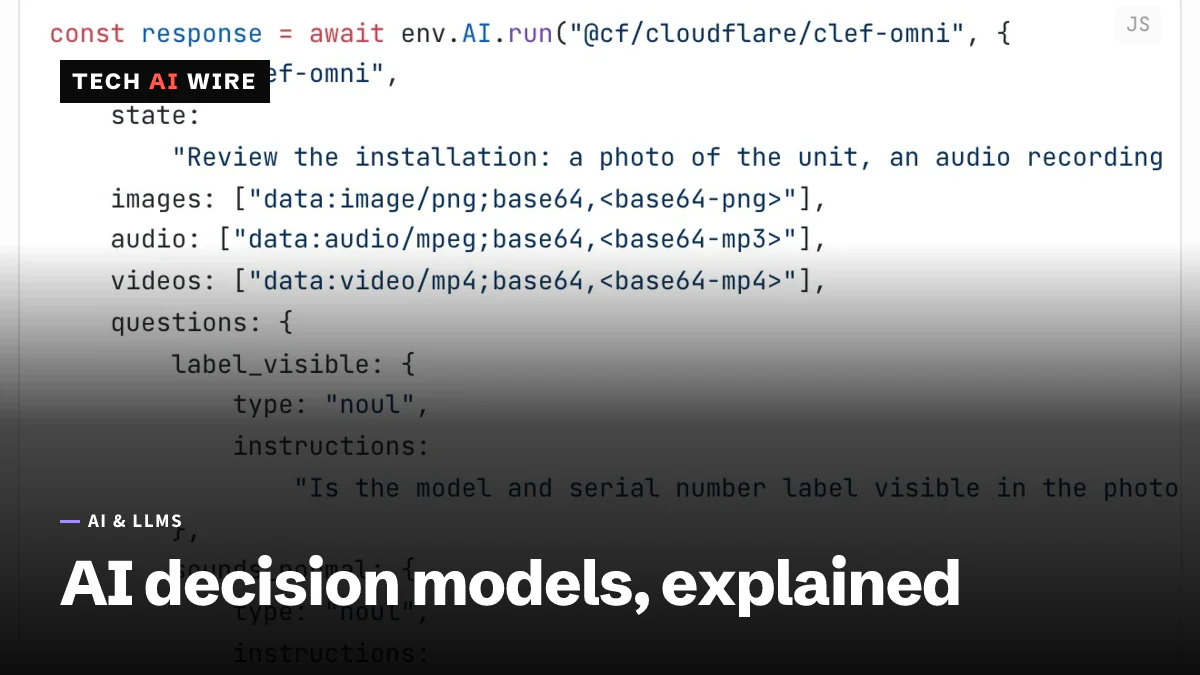
チャットボットのモデルは、答えを単語の断片、つまりトークンごとに1つずつ書きます。意思決定モデルは何も書きません。アプリは、stateと呼ばれる入力と、決まった答えを持つ質問のリストを送ります。モデルは、許された答えのそれぞれに確率を返します。
このカテゴリーをJevで始めたTypeSafeは、これを関数呼び出しにたとえています。TypeSafeのfounderであるDiogo Almeida氏は「構造化されていないstateを入れると、型付きの確率的な判断が出てくる」と述べました。「型付き」とは、答えが常に決まった形で返るという意味です。はい・いいえの質問なら、返ってくるのは「はい」か「いいえ」だけです。
ほとんどの提供企業は、名前は違っても同じ3種類の質問を用意しています。
| 質問の種類 | 返すもの | 使われている名前 |
|---|---|---|
| はい・いいえ | 答えが「はい」である確率 | noul(Cloudflare、Perplexity、Laya)、predicate(OpenAI) |
| 1つを選ぶ | 選択肢ごとの確率 | choice |
| 評価する | 確率で重み付けした尺度上のレベル | score |
速さの理由は、テキスト生成を省くことにあります。AWSのStrandsチームは、モデルのうち単語を生み出す部分を取り除いたと説明しています。そのためDeciderは「選ばれた選択肢の中から必ず答えを出す」とのことです。Cloudflareによると、Clefは入力を1回読み、有効な答えをすべて並行して採点します。Liquid AIの説明は簡潔です。同社のd1モデルは「トークンを生成せず、1回の順方向の計算で答える」としています。
確率は「較正(キャリブレーション)」されていることが前提です。80%確実とされた答えは、およそ80%の確率で正しいはずだという意味です。アプリはこの数字を使って、そのまま実行するか、人に確認するか、より大きなモデルに質問を回すかを決められます。
これまでのモデル
| モデル | 開発元 | 重み | ベース | ホスト型の入力料金(100万トークン当たり) |
|---|---|---|---|---|
| Jev | TypeSafe | ホスト型サービス | 非公表 | 0.042ドル |
| Laya | Convai Innovations | 公開、Apache 2.0 | ModernBERT-large、421M | なし(セルフホスト) |
| Clef | Cloudflare | 公開、Apache 2.0 | Qwen3.8-27B | 0.24ドル |
| Clef-flash | Cloudflare | 公開、Apache 2.0 | Qwen3.5-9B | 0.038ドル |
| Clef-omni | Cloudflare | 公開 | 30BのMixture of Experts、3Bがアクティブ | 0.15ドル |
| Strands Decider 2B | AWSのStrandsチーム | オープンソース | Qwen3.5-2B | 非公表 |
| pplx-decider | Perplexity | 公開、Apache 2.0 | Qwen3.8-27B | 0.02ドル |
| d1-3B、d1-omni-600M | Liquid AI | 公開 | LiquidのLFM2.5モデル | 非公表 |
| Decisions API | OpenAI | ホスト型サービス | gpt-6-luna | 0.10ドル |
| Microsoft-Decision-1 | Microsoft | ホスト型サービス | Qwen3.5-9B | 0.042ドル |
TypeSafe、OpenAI、Perplexity、Microsoftはいずれも、出力トークンは無料だとしています。課金されるのは入力だけです。Perplexityのドキュメントでは、pplx-deciderの料金は入力100万トークン当たり0.02ドルです。10月1日の公開時のAlphaSignalの報道では0.04ドルでした。予算を立てる前に、最新の料金を確認してください。
いつ何が変わったか
この分野は1か月で1つのモデルから10に増えました。
| 日付 | リリース |
|---|---|
| 2026年9月15日 | TypeSafeがJevを公開 |
| 2026年9月 | Convai InnovationsがLayaを重み公開で発表 |
| 2026年10月1日 | Cloudflare Clef、Strands Decider 2B、Perplexityのpplx-decider |
| 2026年10月7日 | Liquid AIがd1-3Bとd1-omni-600Mを公開 |
| 2026年10月9日 | CloudflareがClef-omniを追加し、Clef-flashを0.090ドルから0.038ドルに値下げ |
| 2026年10月 | OpenAIのDecisions APIがパブリックベータに。Microsoft-Decision-1がFoundryに登場 |
その間に、扱える入力も広がりました。Layaが読むのはテキストだけで、Clefは公開当初から画像を受け付けていました。Cloudflareの変更履歴によると、Clef-omniは音声と動画にも対応しました。Liquid AIのd1-omni-600Mは、テキストに加えて画像か音声を受け付けます。OpenAIは、同社のAPIが「今後数週間のうちに」ベータを終えると見込んでいます。
どれくらい速いか
速さが最大の売りですが、数字はすべてモデルを作った企業自身によるものです。Liquid AIによると、d1-3BはNvidiaのグラフィックスカードRTX 4090で、1つの質問に8ミリ秒で答えます。Layaのチームは、Nvidia T4で32.8ミリ秒と報告しています。StrandsチームはRTX 3090で中央値およそ115ミリ秒を計測しました。TypeSafeはJevについて70〜500ミリ秒としています。
1回の判断にかかる費用はごくわずかです。InfoWorldはMicrosoftの数字を使って計算しています。1ドルで、同じような短い判断を27万5,000回以上こなせます。InfoWorldは、これらの数字がMicrosoft自身の主張だと付け加えています。
ベンチマークは比較が難しくなります。各社がそれぞれ独自の表を出しているからです。AlphaSignalによると、pplx-deciderは11のベンチマークで85.71%を記録し、Jevは84.51%でした。ただし、誰がテストを行ったかは書かれていません。
苦手なこと
意思決定モデルは、自分の判断を説明することも、何かを書くこともできません。Strandsチームによると、Deciderは複雑な問題では推論モデルより大幅に劣ります。コーディングやチャットボット、要約にも向きません。Layaのチームは、1つの質問の選択肢を20未満にするよう勧めています。リストが長くなるほど精度が落ちるためです。同チームのテストでは、Layaはクメール語のテキストで正答率0%でしたが、平均95.2%の確信度を示していました。
InfoWorldが引用するアナリストも同じ懸念を示しています。Kanerikaのdevelopment manager for AIであるAmit Kumar Jena氏は「正確そうに見える確率は、不確かな判断に、本来以上の権威を与えかねない」と述べました。
開発者にとっての意味
エージェントの中の定型的な判断には、意思決定モデルを使いましょう。サポートチケットの振り分け、ツールの選択、ガードレールの確認、出力の採点などです。推論や文章が必要な場面には、本格的な言語モデルを残しておきます。Strandsチームが提案しているのも、こうしたハイブリッド型のエージェントです。
数字を信用する前に、自社のデータで較正を確かめてください。答えが分かっている過去の事例を数百件流し、確信度80%が本当に80%の正解率になるかを確認します。InfoWorldが引用するアナリストが勧めるように、やり直しのきく判断から始めましょう。
料金は、実際のトラフィックで比べてください。リクエストの費用は、送る入力トークンの数で決まります。ホスト型の料金には、100万トークン当たり0.02ドルから0.24ドルまで12倍の差があります。また、ClefはJevのAPIに合わせているため、試すのはWebアドレスを変えるのとほぼ同じ手間で済む場合があります。
データを社内にとどめる必要があるなら、公開モデルが選択肢になります。Laya、Clef、Decider、pplx-decider、Liquid AIのd1は、どれも自社のハードウェアで動かせます。
出典
- Introducing System One Models & Jev - TypeSafe AI
- Clef: open-weight decision models - Cloudflare Blog
- Clef-omni adds audio and video input, Clef-flash is now cheaper, and Clef is faster - Cloudflare Changelog
- Introducing Strands Decider - Strands Agents
- Decisions API guide - OpenAI
- Decisions API quickstart - Perplexity
- Multimodal open d1 decision models for the edge - Liquid AI on Hugging Face
- Perplexity Releases pplx-decider, a 27B Open Model That Replaces Label Parsing - AlphaSignal
- Microsoft separates decision-making from generative AI with a new model - InfoWorld
- Laya - System 1 decision engine with calibrated probabilities - Convai Innovations
関連記事
Meta、同社初のフロンティア級モデル「Muse Wonder」を公開
Metaは10月12日、同社初のフロンティアモデルMuse Wonderを、入力100万トークンあたり4ドル、出力100万トークンあたり20ドルで公開しました。より大きなWonder FullはMuse Code専用です。

Mistral Large 4が登場、パラメーターは1.05兆
Mistral Large 4は1.05兆パラメーターのオープンウェイト(open-weight)MoEモデルで、コンテキストは100万トークン。APIプレビューの入力価格は100万トークンあたり1.36ドルだ。重みは10月中に公開される。

Xiaomi、1兆パラメーターのMiMo-V2.6-ProをMITライセンスのオープンウェイトで公開
Xiaomi(シャオミ)のMiMo-V2.6-Proは、パラメーター数が1.02兆、うちアクティブなものが420億で、100万トークンのコンテキストを持ち、重みはMITライセンスです。ただし、約680GBのGPUメモリーが必要です。