Los modelos de decisión de IA, explicados
Un modelo de decisión elige entre respuestas fijas y devuelve una probabilidad para cada una, en lugar de escribir texto. Los precios alojados empiezan en 0,02 $ por millón de tokens.
5 min de lectura
En cifras
- lowest hosted price per million input tokens (Perplexity)
- $0.02
- for output tokens at TypeSafe, OpenAI, Perplexity and Microsoft
- $0
- one d1-3B decision on an RTX 4090, per Liquid AI
- 8 ms
- gap between the cheapest and dearest hosted price
- 12x
- pplx-decider
- 2¢
- Clef-flash
- 3.8¢
- Jev
- 4.2¢
- Microsoft-Decision-1
- 4.2¢
- OpenAI gpt-6-luna
- 10¢
- Clef-omni
- 15¢
- Clef
- 24¢
Un modelo de decisión es un modelo de IA que elige entre un conjunto fijo de respuestas y devuelve una probabilidad para cada una, en lugar de escribir texto. Al menos ocho empresas han lanzado uno desde mediados de septiembre de 2026, desde Jev de TypeSafe hasta modelos de Cloudflare, AWS, Perplexity, Liquid AI, OpenAI y Microsoft. Importan porque los agentes de IA toman muchas decisiones pequeñas de sí o no, o de elegir una opción. Un modelo de decisión las toma más rápido y más barato que un chatbot.
Cómo funciona un modelo de decisión
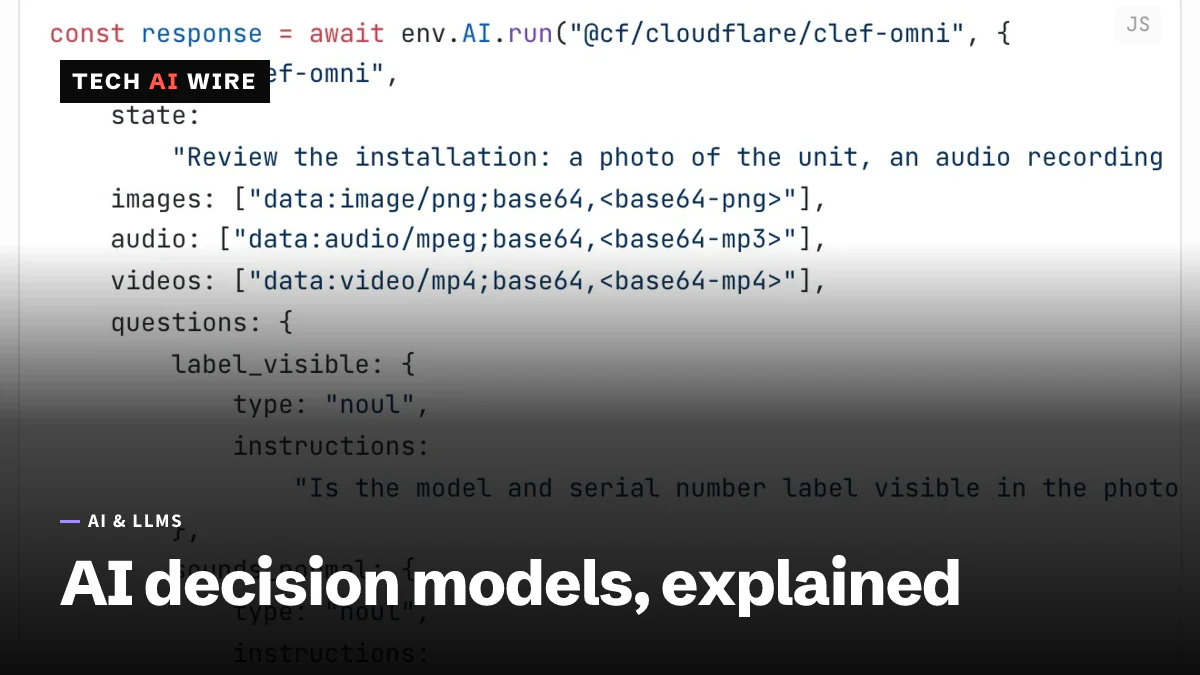
Un modelo de chatbot escribe su respuesta un fragmento de palabra, o token, cada vez. Un modelo de decisión no escribe nada. Una aplicación le envía una entrada, llamada state, junto con una lista de preguntas con respuestas fijas. El modelo devuelve una probabilidad para cada respuesta permitida.
TypeSafe, que inició la categoría con Jev, lo describe como una llamada a una función. "Entra un state sin estructura, salen decisiones probabilísticas tipadas", dijo Diogo Almeida, founder de TypeSafe. "Tipadas" significa que la respuesta siempre tiene la forma esperada. Una pregunta de sí o no solo puede volver como sí o no.
La mayoría de los proveedores ofrecen los mismos tres tipos de pregunta, aunque los nombres cambian:
| Tipo de pregunta | Qué devuelve | Nombres usados |
|---|---|---|
| Sí o no | La probabilidad de que la respuesta sea sí | noul (Cloudflare, Perplexity, Laya), predicate (OpenAI) |
| Elegir una | Una probabilidad para cada opción | choice |
| Calificar | Un nivel en una escala, ponderado por probabilidad | score |
La velocidad viene de saltarse la generación de texto. El equipo de Strands en AWS dice que eliminó la parte del modelo que produce palabras. Por eso Decider "siempre produce una respuesta de entre las opciones seleccionadas". Cloudflare dice que Clef lee la entrada una vez y luego puntúa en paralelo todas las respuestas válidas. Liquid AI lo resume así: sus modelos d1 "no producen tokens, sino que responden en una sola pasada hacia delante".
Las probabilidades deben estar calibradas. Eso significa que una respuesta marcada como segura al 80 % debería acertar alrededor del 80 % de las veces. Una aplicación puede usar ese número para actuar, consultar a una persona o pasar la pregunta a un modelo más grande.
Los modelos hasta ahora
| Modelo | Fabricante | Pesos | Basado en | Precio de entrada alojado por millón de tokens |
|---|---|---|---|---|
| Jev | TypeSafe | Servicio alojado | No indicado | 0,042 $ |
| Laya | Convai Innovations | Abiertos, Apache 2.0 | ModernBERT-large, 421M | Ninguno (autoalojado) |
| Clef | Cloudflare | Abiertos, Apache 2.0 | Qwen3.8-27B | 0,24 $ |
| Clef-flash | Cloudflare | Abiertos, Apache 2.0 | Qwen3.5-9B | 0,038 $ |
| Clef-omni | Cloudflare | Abiertos | Mixture of experts de 30B, 3B activos | 0,15 $ |
| Strands Decider 2B | Equipo de Strands de AWS | Código abierto | Qwen3.5-2B | No indicado |
| pplx-decider | Perplexity | Abiertos, Apache 2.0 | Qwen3.8-27B | 0,02 $ |
| d1-3B, d1-omni-600M | Liquid AI | Abiertos | Modelos LFM2.5 de Liquid | No indicado |
| Decisions API | OpenAI | Servicio alojado | gpt-6-luna | 0,10 $ |
| Microsoft-Decision-1 | Microsoft | Servicio alojado | Qwen3.5-9B | 0,042 $ |
TypeSafe, OpenAI, Perplexity y Microsoft dicen que los tokens de salida son gratis, así que solo se cobra la entrada. La documentación de Perplexity indica 0,02 $ por millón de tokens de entrada para pplx-decider. La nota de AlphaSignal sobre el lanzamiento del 1 de octubre daba 0,04 $. Conviene comprobar el precio actual antes de hacer un presupuesto.
Qué cambió y cuándo
El sector pasó de un modelo a diez en un mes:
| Fecha | Lanzamiento |
|---|---|
| 15 de septiembre de 2026 | TypeSafe lanza Jev |
| Septiembre de 2026 | Convai Innovations publica Laya con pesos abiertos |
| 1 de octubre de 2026 | Cloudflare Clef, Strands Decider 2B y pplx-decider de Perplexity |
| 7 de octubre de 2026 | Liquid AI publica d1-3B y d1-omni-600M |
| 9 de octubre de 2026 | Cloudflare añade Clef-omni y baja Clef-flash de 0,090 $ a 0,038 $ |
| Octubre de 2026 | La Decisions API de OpenAI en beta pública; Microsoft-Decision-1 en Foundry |
Los tipos de entrada se ampliaron por el camino. Laya solo lee texto, y Clef acepta imágenes desde su lanzamiento. Clef-omni ahora también acepta audio y vídeo, según el registro de cambios de Cloudflare. El d1-omni-600M de Liquid AI admite texto con imágenes o con audio. OpenAI dice que espera que su API salga de la beta "en las próximas semanas".
Qué tan rápidos son
La velocidad es el principal argumento de venta, y cada cifra viene de la empresa que creó el modelo. Liquid AI dice que d1-3B responde una pregunta en 8 ms en una tarjeta gráfica Nvidia RTX 4090. El equipo de Laya informa de 32,8 ms en una Nvidia T4. El equipo de Strands midió una mediana de unos 115 ms en una RTX 3090. TypeSafe da para Jev un rango de 70 a 500 ms.
El costo por decisión es mínimo. InfoWorld hace las cuentas con las cifras de Microsoft: 1 $ cubre más de 275.000 decisiones cortas similares. InfoWorld señala que estas cifras son afirmaciones de la propia Microsoft.
Los benchmarks son más difíciles de comparar. Cada empresa publica sus propias tablas. AlphaSignal informa que pplx-decider obtuvo un 85,71 % en 11 benchmarks, frente al 84,51 % de Jev. Pero no dice quién hizo las pruebas.
Dónde se quedan cortos
Un modelo de decisión no puede explicarse ni escribir nada. El equipo de Strands dice que Decider es bastante peor que los modelos de razonamiento en problemas complejos. Tampoco sirve para programar, para chatbots ni para resúmenes. El equipo de Laya recomienda menos de 20 opciones por pregunta, porque la precisión cae a medida que crece la lista. Sus pruebas también mostraron que Laya obtuvo un 0 % con texto en jemer, mientras indicaba una confianza media del 95,2 %.
InfoWorld cita a analistas que plantean la misma preocupación. "Una probabilidad de apariencia precisa puede darle a una decisión incierta más autoridad de la que merece", dijo Amit Kumar Jena, development manager for AI en Kanerika.
Qué significa esto para los desarrolladores
Usa un modelo de decisión para las elecciones rutinarias dentro de un agente: dirigir un ticket de soporte, elegir una herramienta, comprobar una regla de seguridad o calificar una respuesta. Reserva un modelo de lenguaje completo para los casos que necesitan razonamiento o texto. El equipo de Strands propone justo este tipo de agente híbrido.
Prueba la calibración con tus propios datos antes de fiarte de los números. Pasa unos cientos de casos anteriores con respuesta conocida. Comprueba que un 80 % de confianza signifique de verdad un 80 % de aciertos. Empieza por decisiones reversibles, como recomiendan analistas que cita InfoWorld.
Compara precios con tu tráfico real. El costo de una solicitud depende de cuántos tokens de entrada envía. Los precios alojados varían hasta doce veces, de 0,02 $ a 0,24 $ por millón. Además, Clef sigue la API de Jev, así que probarlo puede ser casi como cambiar una dirección web.
Si los datos deben quedarse en casa, los modelos abiertos son el camino. Laya, Clef, Decider, pplx-decider y el d1 de Liquid AI pueden funcionar en tu propio hardware.
Fuentes
- Introducing System One Models & Jev - TypeSafe AI
- Clef: open-weight decision models - Cloudflare Blog
- Clef-omni adds audio and video input, Clef-flash is now cheaper, and Clef is faster - Cloudflare Changelog
- Introducing Strands Decider - Strands Agents
- Decisions API guide - OpenAI
- Decisions API quickstart - Perplexity
- Multimodal open d1 decision models for the edge - Liquid AI on Hugging Face
- Perplexity Releases pplx-decider, a 27B Open Model That Replaces Label Parsing - AlphaSignal
- Microsoft separates decision-making from generative AI with a new model - InfoWorld
- Laya - System 1 decision engine with calibrated probabilities - Convai Innovations
Artículos relacionados
Meta lanza Muse Wonder, su primer modelo de frontera
Meta lanzó Muse Wonder el 12 de octubre a 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida. El modelo mayor, Wonder Full, queda reservado para Muse Code.

Mistral Large 4 llega con 1,05 billones de parámetros
Mistral Large 4 es un modelo MoE de pesos abiertos con 1,05 billones de parámetros y un contexto de 1 millón de tokens. La vista previa de la API cuesta 1,36 $ por millón de tokens de entrada. Los pesos llegan en octubre.

Xiaomi lanza MiMo-V2.6-Pro con 1 billón de parámetros en pesos abiertos bajo MIT
MiMo-V2.6-Pro de Xiaomi tiene 1,02 billones de parámetros, 42.000 millones activos, un contexto de 1 millón de tokens y pesos con licencia MIT, pero necesita unos 680 GB de memoria de GPU.