Cloudflare Clef: modelos de pesos abertos que devolvem decisões
O Clef (27B) e o Clef-flash (9B), da Cloudflare, respondem a perguntas tipadas em vez de escrever texto, com latência mediana de 209 ms e 39 ms, sob Apache 2.0.
3 min de leitura
Em números
- parameters in Clef, built on Qwen 3.8-27B
- 27B
- parameters in Clef-flash, built on Qwen 3.5-9B
- 9B
- Clef-flash median latency
- 38.8 ms
- token context window
- 64k
- Clef-flash
- 38.8 ms
- Clef
- 209.3 ms
- Jev
- 524.1 ms
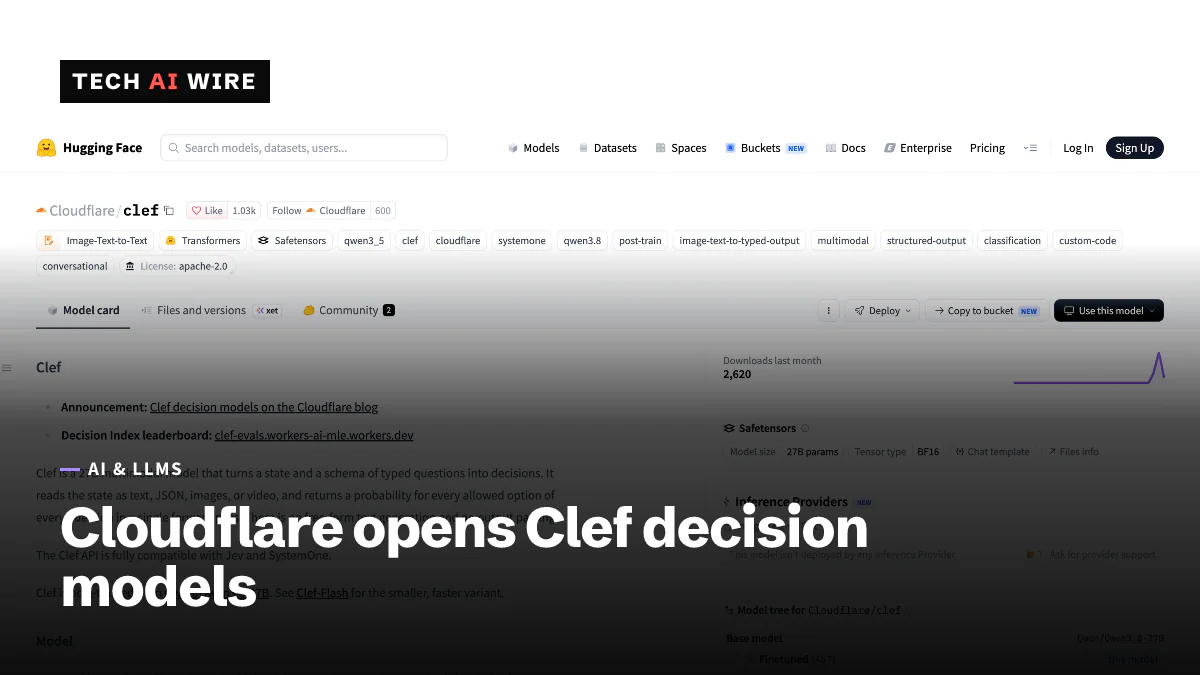
A Cloudflare lançou em 1º de outubro de 2026 dois modelos de decisão de pesos abertos, o Clef e o Clef-flash. Eles não escrevem texto. Eles leem uma entrada e respondem a um conjunto fixo de perguntas tipadas com probabilidades. Isso permite que um agente de IA escolha rapidamente o próximo passo. Segundo o anúncio da Cloudflare, os dois podem ser baixados de graça sob a licença Apache 2.0 e rodam no Workers AI, o serviço hospedado da Cloudflare.
O que é um modelo de decisão
"Um modelo de decisão faz classificações para ajudar agentes a decidir como agir, com base em certas probabilidades", escreve a Cloudflare. Um modelo de chat produz uma resposta um token por vez. O Clef pula essa etapa. A Cloudflare chama o design de não autorregressivo. Ou seja, ele não gera a saída palavra por palavra.
O Traictory explica o mecanismo. Cada modelo lê a entrada inteira de uma só vez e depois pontua cada resposta possível em paralelo. Nada é gerado, então não há tokens de raciocínio para esperar.
É a mesma ideia por trás do Jev, da TypeSafe, um modelo fechado lançado em 15 de setembro, e do Laya, da Convai, um modelo aberto de 421 milhões de parâmetros lançado quatro dias depois. O Clef leva a ideia a uma plataforma hospedada que muitos desenvolvedores já usam.
Os dois modelos
| Clef | Clef-flash | |
|---|---|---|
| Parâmetros | 27 bilhões | 9 bilhões |
| Modelo base | Qwen 3.8-27B | Qwen 3.5-9B |
| Latência mediana | 209,3 ms | 38,8 ms |
| Janela de contexto | 64k tokens | 64k tokens |
| Licença | Apache 2.0 | Apache 2.0 |
A Cloudflare informa uma latência de percentil 95 de 122,4 ms para o Clef-flash. Isso significa que 95% das requisições dele terminaram dentro desse tempo.
Os dois modelos são construídos sobre o Qwen, a família de modelos abertos da Alibaba. Segundo o Traictory, a base Qwen fica congelada. A Cloudflare treinou sobre ela pequenas camadas adicionais, chamadas adaptadores low-rank de rank 256.
O Clef também tem um codificador de visão, então pode receber imagens como entrada. A Cloudflare apresenta isso como uma diferença em relação ao Jev, que só lida com texto.
Alegações de velocidade e preço
A Cloudflare diz que os dois modelos cortam a latência pela metade em comparação com o gpt-oss-120b, um modelo aberto da OpenAI, em seus próprios testes de inteligência de ameaças. A empresa diz que avaliou os modelos em 43 benchmarks.
O preço chamou atenção. O Traictory coloca o Clef a 0,24 dólar por milhão de tokens no Workers AI, contra 0,042 dólar por milhão do Jev. Isso torna o Clef quase seis vezes mais caro por token. O Traictory informa latência mediana de 524,1 ms para o Jev, contra 209,3 ms do Clef.
Para o uso hospedado, a Cloudflare diz que "não lê, não armazena nem treina com as suas requisições". Os pesos também estão no Hugging Face. Assim, uma equipe pode rodá-los no próprio hardware e evitar totalmente o preço por token. O mesmo anúncio apresenta uma nova plataforma de ajuste fino por aprendizado por reforço para treinar esse tipo de modelo.
As questões em aberto
Segundo o Traictory, comentaristas do Hacker News questionaram tanto o preço quanto o método dos benchmarks. "Benchmarks públicos são fáceis de burlar", escreveu um deles. O Traictory também observa que "nenhuma execução de terceiros é citada" para as alegações de qualidade.
O Traictory lista três lacunas: validação independente, testes contra a versão atual do Jev e dados de uso real em produção. Nada disso existe ainda.
O que isso significa para desenvolvedores
Observe as decisões que o seu agente toma antes de cada passo. Rotear uma requisição, sinalizar uma mensagem ou escolher uma ferramenta são todas tarefas de classificação. Se hoje um grande modelo de chat cuida delas, um modelo de decisão poderia reduzir essa etapa de segundos para milissegundos.
Comece pelo Clef-flash. Com mediana de 38,8 ms, ele é rápido o bastante para ficar no caminho das requisições de um app em produção. Passe para o modelo de 27B só se os seus próprios testes mostrarem que o menor erra respostas demais.
Faça a sua própria avaliação antes de trocar. Os números publicados vêm da Cloudflare, e nenhum grupo externo os reproduziu. Pegue de 200 a 500 entradas reais dos seus logs, marque as respostas corretas e compare o Clef com o que você usa hoje.
Compare os custos nos dois sentidos. No Workers AI, você paga por token. Com os pesos sob Apache 2.0, você paga pelas suas próprias GPUs. Uma etapa de classificação muito usada pode tornar a hospedagem própria a opção mais barata, e ela mantém os dados dentro de casa.
Fontes
Artigos relacionados
Strands Decider 2B toma decisões de agentes em 115 ms
O Strands Decider 2B, da AWS, é um modelo de código aberto que escolhe em uma lista em vez de escrever texto. Ele responde em 115 ms em uma RTX 3090 e marca 72,3% no JevBench.
AstaBrief 8B: modelo aberto do Ai2 escreve relatórios com citações
O Ai2 lançou o AstaBrief 8B, um modelo sob Apache 2.0 baseado no Qwen3-8B que escreve relatórios de pesquisa com citações em 51,1 segundos, 3,5 vezes mais rápido que o modo Thinking do Asta.
A Qwen Research License explicada
A Qwen Research License permite que qualquer pessoa baixe o Qwen-Image-2.1, mas limita o uso a pesquisa ou avaliação. Uso comercial exige uma licença à parte da Qwen.