EmbeddingGemma 2 leva a busca multimodal para o celular
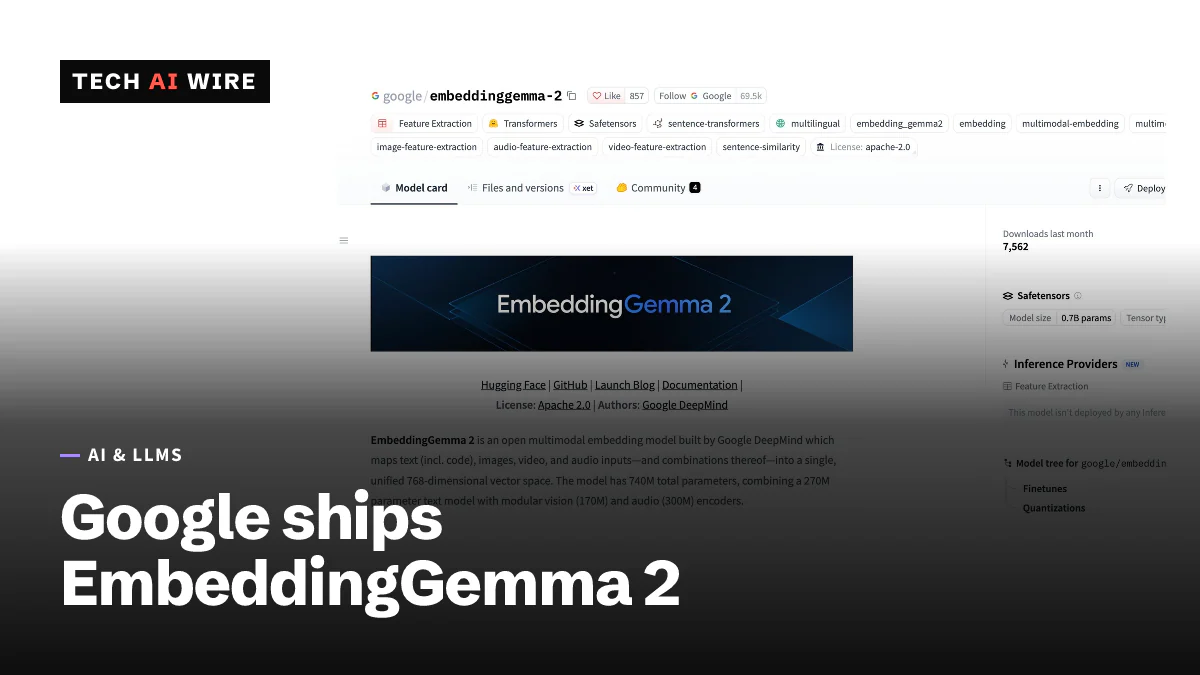
O EmbeddingGemma 2, do Google DeepMind, coloca texto, código, imagens, vídeo e áudio em um só espaço vetorial, com 740M de parâmetros. O uso só de texto precisa de cerca de 191 MB de RAM.
4 min de leitura
Em números
- total parameters across three encoders
- 740M
- embedding dimensions, truncatable to 128
- 768
- RAM for text-only use on a Pixel 11 Pro
- ~191 MB
- MTEB Code score, up from 68.76
- 78.68
O Google DeepMind lançou o EmbeddingGemma 2 em 6 de outubro de 2026, um modelo aberto que transforma texto, código, imagens, vídeo e áudio em vetores de um mesmo espaço compartilhado. Ele tem 740 milhões de parâmetros e sai sob a licença Apache 2.0, segundo o guia do desenvolvedor do Google. A versão só de texto roda em cerca de 191 MB de memória em um celular. Isso torna prático pesquisar as fotos, notas de voz e documentos de um usuário sem enviá-los a um servidor.
O que um modelo de embeddings faz
Um modelo de embeddings transforma um conteúdo em uma lista de números, chamada vetor. Conteúdos semelhantes acabam com vetores semelhantes. A busca passa a ser, então, encontrar os vetores mais próximos de uma consulta.
Esse é o motor por trás do RAG, ou geração aumentada por recuperação, em que um app encontra documentos relevantes antes de pedir a um modelo de linguagem que responda. O EmbeddingGemma 2 coloca todos os tipos de mídia no mesmo espaço. Uma consulta de texto como "cachorro na praia" pode, portanto, encontrar diretamente uma foto, um quadro de vídeo ou um clipe de áudio.
O guia para edge o descreve como um modelo que "mapeia texto, imagens, quadros de vídeo e áudio em um único espaço vetorial unificado".
Como ele é construído
O modelo é formado por codificadores empilháveis que compartilham um espaço de embeddings:
| Parte | Parâmetros |
|---|---|
| Codificador de texto e código | 270M |
| Codificador de visão | 170M |
| Codificador de áudio | 300M |
| Total | 740M |
Empilhável significa que um app só de texto pode carregar apenas o núcleo de 270M e acrescentar visão ou áudio somente se precisar.
A saída é um vetor de 768 dimensões. Ele pode ser reduzido a 512, 256 ou 128 dimensões com Matryoshka Representation Learning, um método de treinamento que coloca a informação mais importante no início de cada vetor. O Google diz que 128 dimensões reduzem o armazenamento em 6 vezes. "A maior parte da qualidade total do embedding original é mantida em texto e código, e cerca de 95% em recuperação de imagem, vídeo e fala", diz o guia do desenvolvedor.
A janela de contexto é de 8.192 tokens, quatro vezes a da primeira versão. O Unite.AI lista o que cabe em uma única chamada:
- 29 imagens, a 280 tokens cada
- 58 quadros de vídeo, a 140 tokens cada
- 5,5 minutos de áudio, a 25 tokens por segundo
O Unite.AI acrescenta que o modelo oferece suporte a mais de 100 idiomas e que o corte dos dados de treinamento é janeiro de 2025.
Benchmarks e velocidade
| Teste | EmbeddingGemma 2 | Fonte |
|---|---|---|
| MTEB Code | 78,68 (EmbeddingGemma 1: 68,76) | Unite.AI, Crypto Briefing |
| MTEB multilingual | 61,36 | Unite.AI |
| MMEB v2 recuperação de imagens | 57,28 | Unite.AI |
| MMEB v2 recuperação de vídeo | 50,67 | Unite.AI |
| MSEB áudio | 69,54 | Unite.AI |
A pontuação em código é o maior salto, um ganho de 9,92 pontos. O guia do Google o descreve como 14% maior que o da primeira versão.
Em hardware, o Google informa cerca de 191 MB de RAM para uso só de texto e cerca de 567 MB para uso multimodal completo em um Pixel 11 Pro, com quantização. O guia para edge mediu o embedding de uma imagem em 37,3 milissegundos em uma GPU de MacBook M5 Pro, ou 26,9 imagens por segundo.
O mesmo guia diz que o modelo consegue classificar uma entrada entre 500 opções em menos de 100 milissegundos, sem precisar de treinamento. Isso o aproxima da nova classe de modelos de decisão, como o Clef da Cloudflare.
Onde encontrar
Os pesos estão no Hugging Face como google/embeddinggemma-2, e também no Kaggle e na LiteRT Community. O Crypto Briefing lista suporte em sentence-transformers, Hugging Face transformers, LiteRT e MediaPipe, MLX e Ollama. O Google também oferece pacotes LiteRT pré-quantizados como arquivos .litertlm. O modelo também alimenta o AI Edge Foresight, um app experimental para Mac que faz notas de reunião offline.
O que isso significa para os desenvolvedores
- Leve a busca para o dispositivo. Com cerca de 191 MB para texto, o modelo cabe em um app móvel. O conteúdo privado pode ser indexado localmente, o que, segundo o Unite.AI, significa que arquivos pessoais "não precisam ser enviados a um servidor só para se tornarem pesquisáveis".
- Use o truncamento para reduzir o armazenamento. Se o seu banco de vetores for grande, teste 256 ou 128 dimensões. O Google informa uma economia de 6 vezes com 128, mantendo a maior parte da qualidade em texto.
- Refaça os embeddings se trocar de modelo. Os vetores do EmbeddingGemma 1 e 2 não são intercambiáveis. Planeje uma reindexação completa em vez de misturá-los.
- Teste na busca de código. Um ganho de 9,92 pontos no MTEB Code torna o modelo digno de teste para busca em repositórios e RAG de código.
- Carregue só os codificadores de que precisa. Um recurso só de texto não precisa dos 470M de parâmetros dos codificadores de visão e áudio. Cargas menores significam inicialização mais rápida em celulares.
Execute-o primeiro contra o seu modelo de embeddings atual, com as suas próprias consultas. Os benchmarks públicos mostram a direção, e os seus próprios dados mostram o ganho real.
Fontes
- EmbeddingGemma 2: The Developer Guide - Google Developers Blog
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 - Google Developers Blog
- DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space - Unite.AI
- Google releases EmbeddingGemma 2, a 740 million parameter open-weight model under Apache 2.0 - Crypto Briefing
Artigos relacionados
Liquid AI LFM2.5-VL-DSpark acelera seu modelo de visão 3B
O modelo de rascunho LFM2.5-VL-DSpark da Liquid AI, com 280M de parâmetros, decodifica seu modelo de visão 3B até 3.13x mais rápido em um M5 Max, com saída idêntica.
Google AI Edge Foresight faz notas de reunião offline
O Google AI Edge Foresight, um app experimental para Mac, transforma anotações rápidas em notas de reunião no próprio dispositivo com o Gemma 4 e o EmbeddingGemma 2, de 740M de parâmetros.
Strands Decider 2B toma decisões de agentes em 115 ms
O Strands Decider 2B, da AWS, é um modelo de código aberto que escolhe em uma lista em vez de escrever texto. Ele responde em 115 ms em uma RTX 3090 e marca 72,3% no JevBench.