EmbeddingGemma 2、マルチモーダル検索をスマートフォンで実現
Google DeepMindのEmbeddingGemma 2は、テキスト、コード、画像、動画、音声を7億4000万パラメーターで1つのベクトル空間に写す。テキストのみなら、必要なRAMは約191 MBだ。エンベディングの新世代である。
4 分で読めます
数字で見る
- total parameters across three encoders
- 740M
- embedding dimensions, truncatable to 128
- 768
- RAM for text-only use on a Pixel 11 Pro
- ~191 MB
- MTEB Code score, up from 68.76
- 78.68
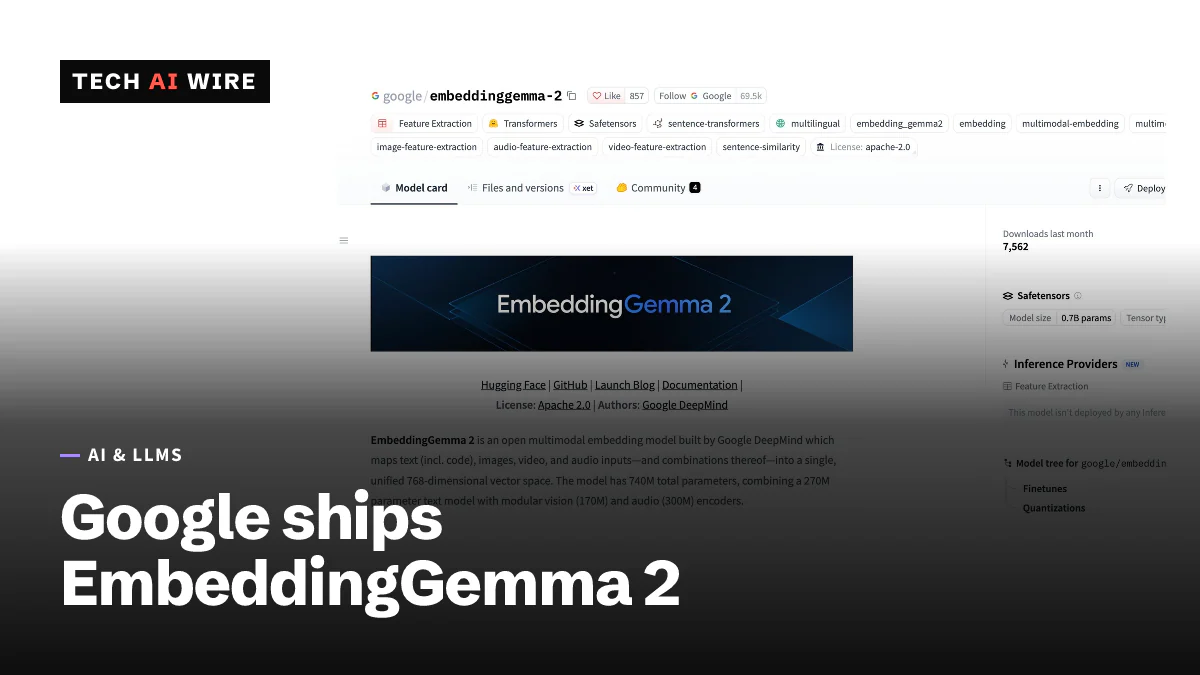
Google DeepMindは2026年10月6日、EmbeddingGemma 2を公開した。テキスト、コード、画像、動画、音声を、共通の空間にあるベクトルに変換するオープンモデルである。パラメーターは7億4000万で、Apache 2.0ライセンスで提供される。Googleの開発者ガイドによると、テキストのみのバージョンはスマートフォン上で約191 MBのメモリで動く。これにより、ユーザーの写真、音声メモ、文書をサーバーに送らずに検索することが現実的になる。
エンベディングモデルの役割
エンベディングモデルは、コンテンツを「ベクトル」と呼ばれる数値のリストに変換する。似たコンテンツは似たベクトルになる。検索は、クエリに最も近いベクトルを探す作業になる。
これがRAG、つまり検索拡張生成の土台だ。アプリは言語モデルに回答させる前に、関連する文書を見つける。EmbeddingGemma 2は、あらゆる種類のメディアを同じ空間に置く。そのため「浜辺の犬」というテキストのクエリで、写真、動画のフレーム、音声クリップを直接見つけられる。
エッジ向けガイドは、これを「テキスト、画像、動画フレーム、音声を単一の統一されたベクトル空間に写すモデル」と説明している。
仕組み
このモデルは、1つのエンベディング空間を共有する積み重ね可能なエンコーダーでできている。
| 部品 | パラメーター |
|---|---|
| テキストとコードのエンコーダー | 2億7000万 |
| ビジョンエンコーダー | 1億7000万 |
| オーディオエンコーダー | 3億 |
| 合計 | 7億4000万 |
積み重ね可能とは、テキストのみのアプリなら2億7000万の中核部分だけを読み込み、必要なときだけビジョンやオーディオを足せるという意味だ。
出力は768次元のベクトルである。Matryoshka Representation Learningを使えば、512、256、128次元まで削れる。これは、各ベクトルの先頭に最も重要な情報を詰め込む学習手法だ。Googleによると、128次元ならストレージは6分の1になる。開発者ガイドは「テキストとコードでは元のエンベディングの品質の大部分が保たれ、画像、動画、音声の検索では約95%が保たれる」と述べている。
コンテキストウィンドウは8192トークンで、初代の4倍だ。Unite.AIは、1回の呼び出しに収まる量を挙げている。
- 画像29枚(各280トークン)
- 動画フレーム58枚(各140トークン)
- 音声5.5分(1秒あたり25トークン)
Unite.AIはさらに、このモデルが100を超える言語に対応し、学習データのカットオフは2025年1月だと付け加えている。
ベンチマークと速度
| テスト | EmbeddingGemma 2 | 出典 |
|---|---|---|
| MTEB Code | 78.68(EmbeddingGemma 1:68.76) | Unite.AI、Crypto Briefing |
| MTEB multilingual | 61.36 | Unite.AI |
| MMEB v2 画像検索 | 57.28 | Unite.AI |
| MMEB v2 動画検索 | 50.67 | Unite.AI |
| MSEB 音声 | 69.54 | Unite.AI |
コードのスコアが最大の伸びで、9.92ポイント上がった。Googleのガイドは、これを初代より14%高いと説明している。
ハードウェアについて、Googleは量子化を使った場合、Pixel 11 Proでテキストのみなら約191 MB、フルのマルチモーダルなら約567 MBのRAMが必要だと報告している。エッジ向けガイドは、MacBook M5 ProのGPUで画像1枚のエンベディングに37.3ミリ秒かかり、毎秒26.9枚だったと計測した。
同じガイドは、このモデルが学習なしで、入力を500の選択肢から100ミリ秒未満で振り分けられると述べている。これは、CloudflareのClefのような新しい種類の判断モデルに近い。
入手先
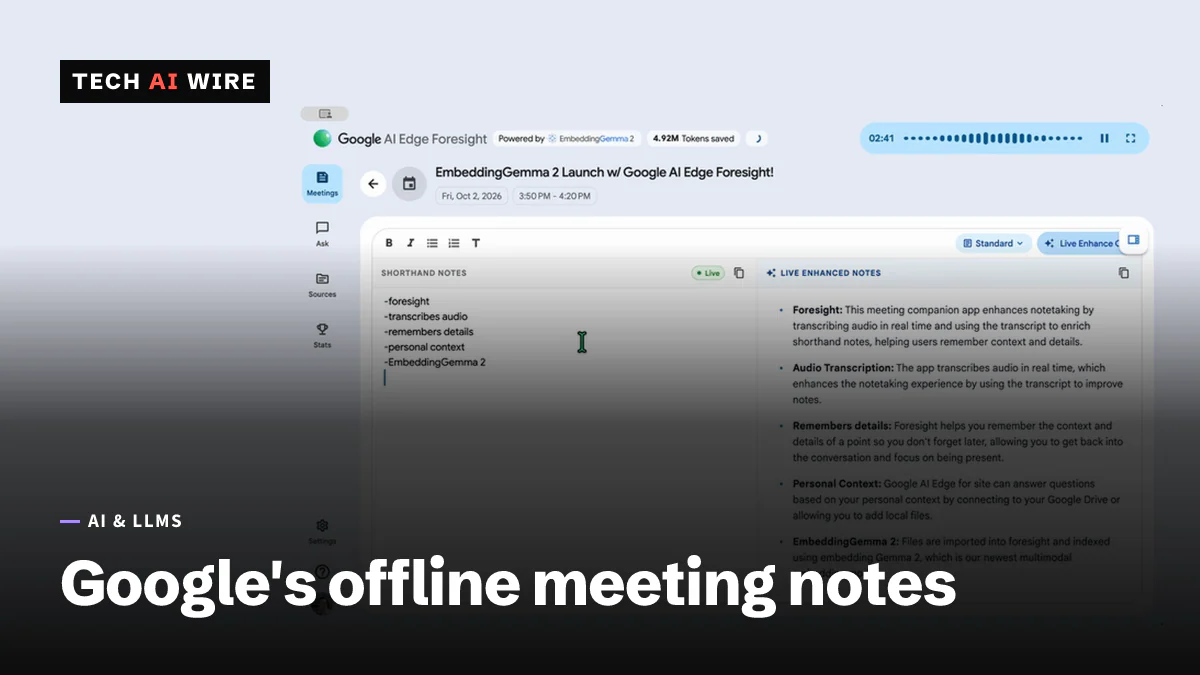
重みは、Hugging Faceにgoogle/embeddinggemma-2として、またKaggleとLiteRT Communityにある。Crypto Briefingは、sentence-transformers、Hugging Face transformers、LiteRTとMediaPipe、MLX、Ollamaでの対応を挙げている。Googleは、量子化済みのLiteRTバンドルも.litertlmファイルとして提供している。Googleは、会議メモをオフラインで作成する実験的なMacアプリAI Edge Foresightでもこのモデルを使っている。
開発者にとっての意味
- 検索をデバイスに移す。 テキストなら約191 MBなので、モバイルアプリに収まる。プライベートなコンテンツをローカルで索引化できる。Unite.AIによると、これは個人のファイルが「検索可能にするためだけにサーバーへアップロードされなくてよい」ことを意味する。
- 切り詰めでストレージを減らす。 ベクトルデータベースが大きいなら、256次元か128次元を試すとよい。Googleは、128次元でテキストの品質の大部分を保ちつつ6分の1になると報告している。
- モデルを変えたら再エンベディングする。 EmbeddingGemma 1と2のベクトルは互換性がない。混ぜずに、全面的な再索引化を計画すること。
- コード検索で試す。 MTEB Codeで9.92ポイント上がったので、リポジトリ検索とコードRAGで試す価値がある。
- 必要なエンコーダーだけ読み込む。 テキストのみの機能に、ビジョンとオーディオのエンコーダーの4億7000万パラメーターは要らない。負荷が小さいほど、スマートフォンでの起動は速くなる。
まず、自分のクエリで、今使っているエンベディングモデルと比べてみること。公開ベンチマークは方向性を示し、自分のデータが本当の改善幅を示す。
出典
- EmbeddingGemma 2: The Developer Guide - Google Developers Blog
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 - Google Developers Blog
- DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space - Unite.AI
- Google releases EmbeddingGemma 2, a 740 million parameter open-weight model under Apache 2.0 - Crypto Briefing
関連記事
Liquid AIのLFM2.5-VL-DSpark、3B視覚モデルを高速化
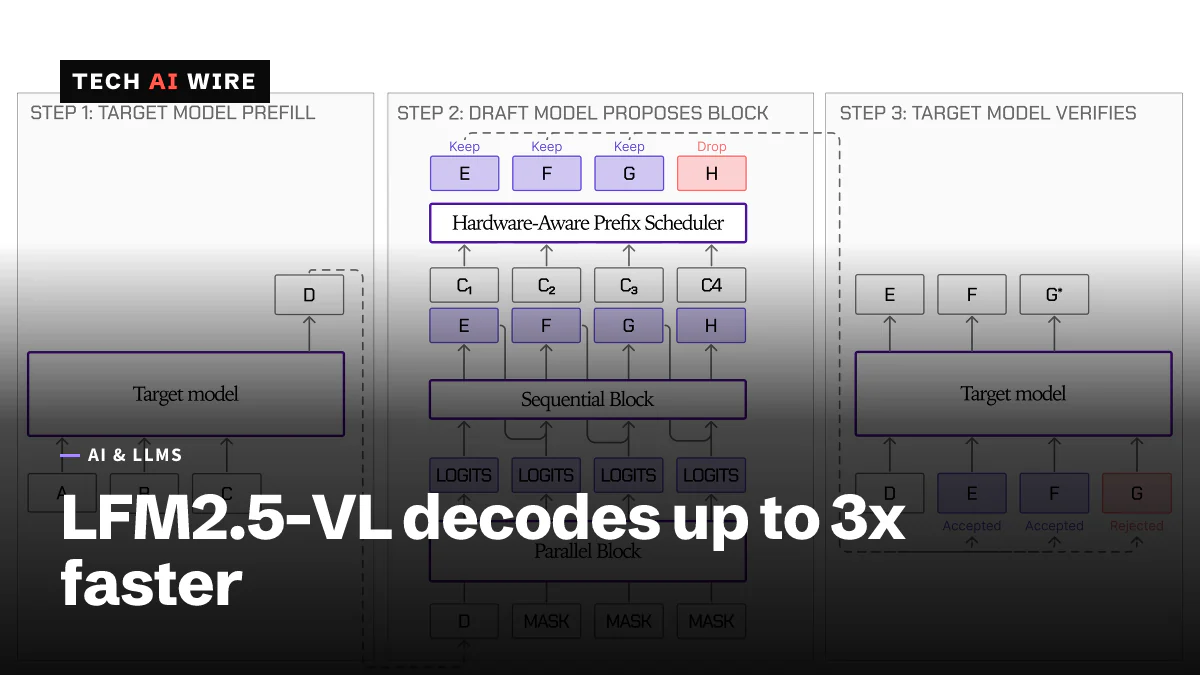
Liquid AIの280MパラメータのドラフトモデルLFM2.5-VL-DSparkは、投機的デコーディング (スペキュレイティブ・デコーディング)で3B視覚モデルのデコードをM5 Maxで最大3.13x高速化し、出力は同一のままです。
Google AI Edge Foresight、会議メモをオフラインで作成
Googleの実験的なMacアプリGoogle AI Edge Foresightは、Gemma 4と、7億4000万パラメーターの埋め込み(エンベディング)モデルEmbeddingGemma 2を使い、走り書きをデバイス上で会議メモに仕上げる。
Strands Decider 2Bはエージェントの判断を115ミリ秒で下す
AWSのStrands Decider 2Bは、テキストを書かずに選択肢から選ぶオープンソースのデシジョンモデルだ。RTX 3090で115ミリ秒で答え、JevBenchで72.3%を記録した。