EmbeddingGemma 2 lleva la búsqueda multimodal al teléfono
EmbeddingGemma 2 de Google DeepMind sitúa texto, código, imágenes, vídeo y audio en un solo espacio vectorial, con 740M de parámetros. El uso solo de texto necesita unos 191 MB de RAM.
4 min de lectura
En cifras
- total parameters across three encoders
- 740M
- embedding dimensions, truncatable to 128
- 768
- RAM for text-only use on a Pixel 11 Pro
- ~191 MB
- MTEB Code score, up from 68.76
- 78.68
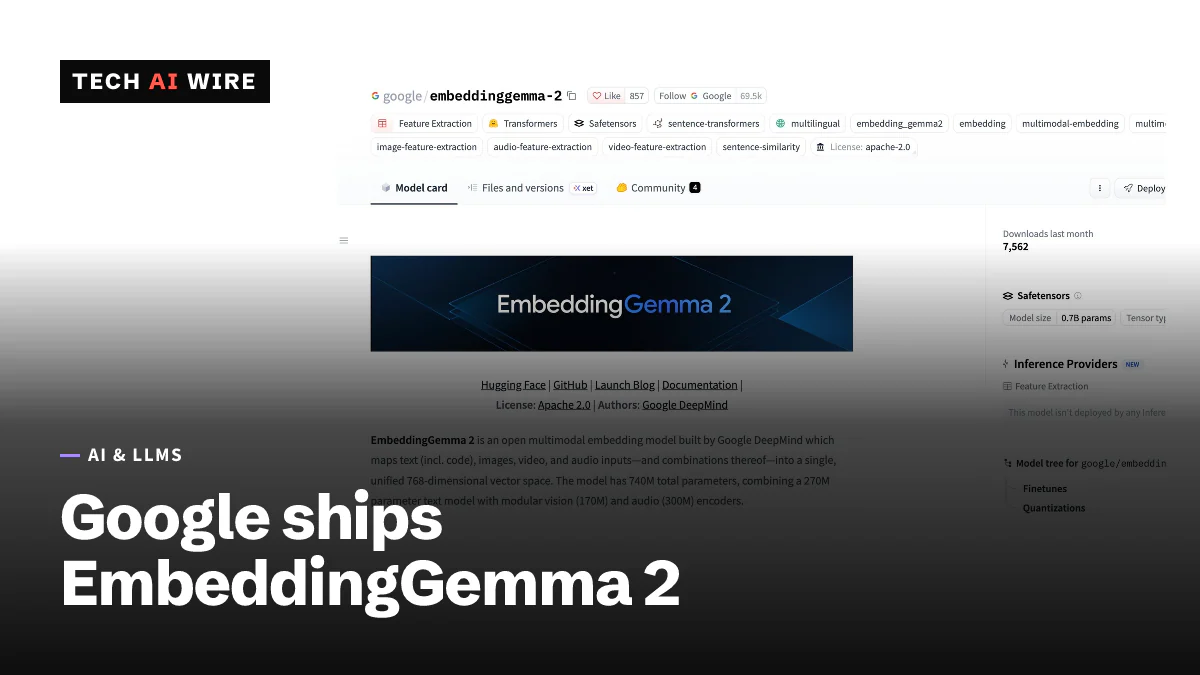
Google DeepMind lanzó EmbeddingGemma 2 el 6 de octubre de 2026, un modelo abierto que convierte texto, código, imágenes, vídeo y audio en vectores de un mismo espacio compartido. Tiene 740 millones de parámetros y se distribuye bajo la licencia Apache 2.0, según la guía para desarrolladores de Google. La versión solo de texto funciona con unos 191 MB de memoria en un teléfono. Eso hace viable buscar en las fotos, notas de voz y documentos de un usuario sin enviarlos a un servidor.
Qué hace un modelo de embeddings
Un modelo de embeddings convierte un contenido en una lista de números, llamada vector. Los contenidos similares acaban con vectores similares. La búsqueda consiste entonces en encontrar los vectores más cercanos a una consulta.
Este es el motor detrás de RAG, o generación aumentada por recuperación, en la que una aplicación encuentra documentos relevantes antes de pedir a un modelo de lenguaje que responda. EmbeddingGemma 2 coloca todo tipo de medios en el mismo espacio. Una consulta de texto como «perro en una playa» puede, por tanto, encontrar directamente una foto, un fotograma de vídeo o un clip de audio.
La guía para edge lo describe como un modelo que «asigna texto, imágenes, fotogramas de vídeo y audio a un único espacio vectorial unificado».
Cómo está construido
El modelo se compone de codificadores apilables que comparten un espacio de embeddings:
| Parte | Parámetros |
|---|---|
| Codificador de texto y código | 270M |
| Codificador de visión | 170M |
| Codificador de audio | 300M |
| Total | 740M |
Apilable significa que una aplicación solo de texto puede cargar únicamente el núcleo de 270M y añadir visión o audio solo si los necesita.
La salida es un vector de 768 dimensiones. Se puede reducir a 512, 256 o 128 dimensiones con Matryoshka Representation Learning, un método de entrenamiento que coloca la información más importante al principio de cada vector. Google afirma que 128 dimensiones reducen el almacenamiento 6 veces. «Se conserva la mayor parte de la calidad total del embedding original en texto y código, y cerca del 95 % en recuperación de imagen, vídeo y voz», señala la guía para desarrolladores.
La ventana de contexto es de 8192 tokens, cuatro veces la de la primera versión. Unite.AI enumera lo que cabe en una sola llamada:
- 29 imágenes, a 280 tokens cada una
- 58 fotogramas de vídeo, a 140 tokens cada uno
- 5,5 minutos de audio, a 25 tokens por segundo
Unite.AI añade que el modelo admite más de 100 idiomas y que su corte de datos de entrenamiento es enero de 2025.
Benchmarks y velocidad
| Prueba | EmbeddingGemma 2 | Fuente |
|---|---|---|
| MTEB Code | 78,68 (EmbeddingGemma 1: 68,76) | Unite.AI, Crypto Briefing |
| MTEB multilingual | 61,36 | Unite.AI |
| MMEB v2 recuperación de imágenes | 57,28 | Unite.AI |
| MMEB v2 recuperación de vídeo | 50,67 | Unite.AI |
| MSEB audio | 69,54 | Unite.AI |
La puntuación en código es el mayor salto, una mejora de 9,92 puntos. La guía de Google la describe como un 14 % superior a la de la primera versión.
En hardware, Google indica unos 191 MB de RAM para el uso solo de texto y unos 567 MB para el uso multimodal completo en un Pixel 11 Pro, con cuantización. La guía para edge midió el embedding de una imagen en 37,3 milisegundos en una GPU de MacBook M5 Pro, es decir, 26,9 imágenes por segundo.
La misma guía dice que el modelo puede clasificar una entrada entre 500 opciones en menos de 100 milisegundos, sin necesidad de entrenamiento. Eso lo acerca a la nueva clase de modelos de decisión como Clef de Cloudflare.
Dónde conseguirlo
Los pesos están en Hugging Face como google/embeddinggemma-2, y en Kaggle y la LiteRT Community. Crypto Briefing enumera compatibilidad con sentence-transformers, Hugging Face transformers, LiteRT y MediaPipe, MLX y Ollama. Google también distribuye paquetes LiteRT precuantizados como archivos .litertlm. El modelo también impulsa AI Edge Foresight, una app experimental para Mac que toma notas de reuniones sin conexión.
Qué significa para los desarrolladores
- Lleve la búsqueda al dispositivo. Con unos 191 MB para texto, el modelo cabe en una aplicación móvil. El contenido privado puede indexarse en local, lo que según Unite.AI significa que los archivos personales «no tienen que subirse a un servidor solo para poder buscarse».
- Use el truncado para reducir el almacenamiento. Si su base de datos de vectores es grande, pruebe 256 o 128 dimensiones. Google indica un ahorro de 6 veces con 128, conservando la mayor parte de la calidad en texto.
- Reincruste si cambia de modelo. Los vectores de EmbeddingGemma 1 y 2 no son intercambiables. Planifique una reindexación completa en lugar de mezclarlos.
- Pruébelo en búsqueda de código. Una mejora de 9,92 puntos en MTEB Code justifica probarlo en búsqueda de repositorios y RAG de código.
- Cargue solo los codificadores que necesita. Una función solo de texto no necesita los 470M de parámetros de los codificadores de visión y audio. Cargas más pequeñas significan arranques más rápidos en teléfonos.
Ejecútelo primero contra su modelo de embeddings actual con sus propias consultas. Los benchmarks públicos muestran la dirección, y sus propios datos muestran la mejora real.
Fuentes
- EmbeddingGemma 2: The Developer Guide - Google Developers Blog
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 - Google Developers Blog
- DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space - Unite.AI
- Google releases EmbeddingGemma 2, a 740 million parameter open-weight model under Apache 2.0 - Crypto Briefing
Artículos relacionados
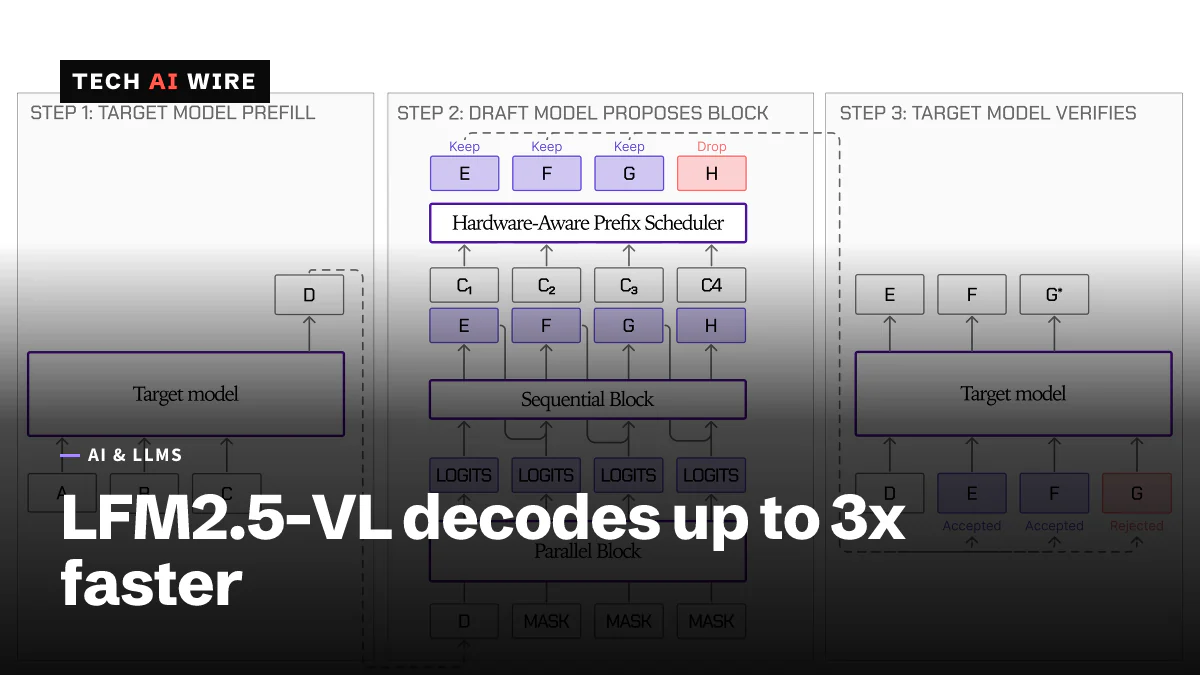
Liquid AI LFM2.5-VL-DSpark acelera su modelo de visión 3B
El modelo borrador LFM2.5-VL-DSpark de Liquid AI, de 280M de parámetros, decodifica su modelo de visión 3B hasta 3.13x más rápido en un M5 Max, con una salida idéntica.
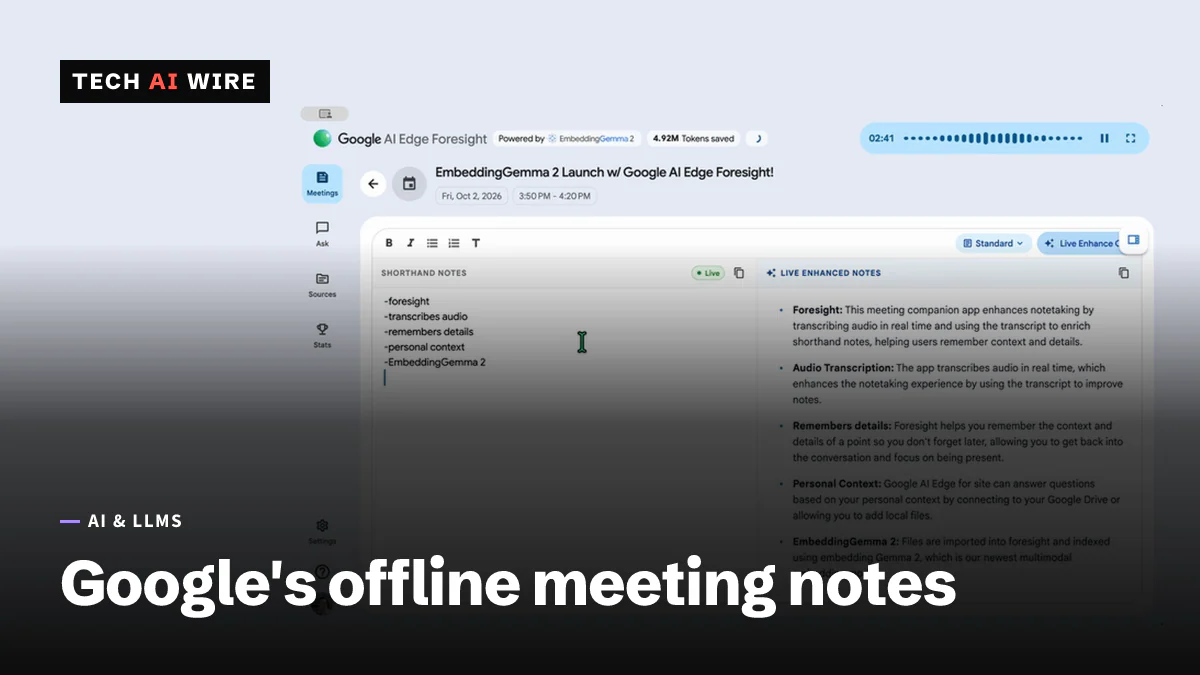
Google AI Edge Foresight toma notas de reuniones sin conexión
Google AI Edge Foresight, una aplicación experimental para Mac, convierte apuntes rápidos en notas de reunión en el propio dispositivo con Gemma 4 y EmbeddingGemma 2, de 740M de parámetros.
Strands Decider 2B toma decisiones de agentes en 115 ms
Strands Decider 2B de AWS es un modelo de código abierto que elige de una lista en lugar de escribir texto. Responde en 115 ms en una RTX 3090 y obtiene un 72,3 % en JevBench.