Strands Decider 2B toma decisões de agentes em 115 ms
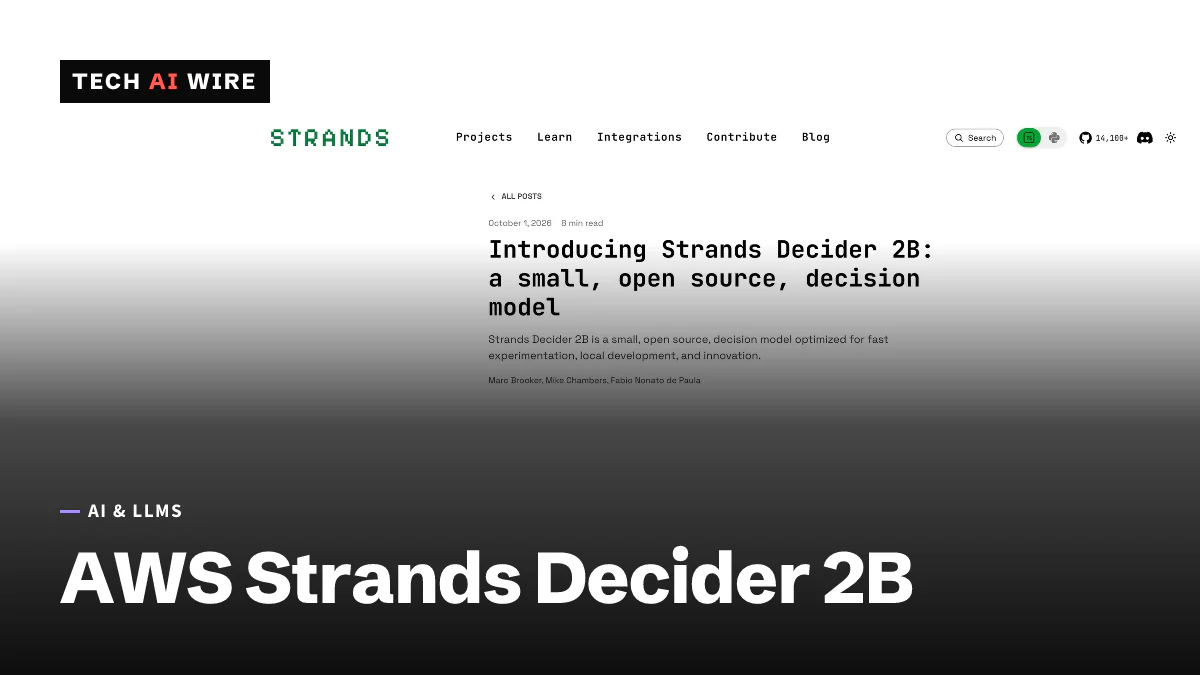
O Strands Decider 2B, da AWS, é um modelo de código aberto que escolhe em uma lista em vez de escrever texto. Ele responde em 115 ms em uma RTX 3090 e marca 72,3% no JevBench.
4 min de leitura
Em números
- median latency on an RTX 3090
- 115 ms
- accuracy on JevBench v1's 231 tasks
- 72.3%
- parameters in the pointer head that replaces text output
- 1M
- license, per Tech Times
- Apache 2.0
A equipe Strands Labs, da AWS, lançou o Strands Decider 2B em 1º de outubro de 2026, um modelo de código aberto que toma decisões para agentes de IA sem escrever texto. Dada uma pergunta e uma lista de opções, ele pontua cada opção e devolve sua escolha com um valor de confiança. O anúncio da Strands informa um tempo de resposta mediano de 115 milissegundos em uma placa de vídeo RTX 3090. Isso o torna barato o bastante para rodar antes de cada chamada cara a um modelo de linguagem grande.
O que um modelo de decisão faz
A maioria dos agentes de IA pede a um modelo de linguagem grande, ou LLM, que faça pequenas escolhas o dia todo. Qual ferramenta deve rodar em seguida? Qual modelo deve responder? Esta solicitação é permitida? O LLM escreve a resposta como texto, token por token. Isso é lento e custa dinheiro.
Um modelo de decisão pula a escrita. Ele lê a pergunta e a lista de respostas permitidas e dá uma pontuação a cada resposta. As opções são fornecidas no momento em que você pergunta. Assim, o mesmo modelo pode escolher entre ferramentas em uma chamada e entre políticas na seguinte.
A Strands lista estas tarefas:
- roteamento de modelos, que envia cada solicitação ao modelo certo
- seleção de ferramentas
- avaliações
- guardrails, que bloqueiam solicitações que violam uma política
- gerenciamento de memória e contexto
Os limites são igualmente claros. A AWS diz que o modelo «não consegue escrever código, resumir documentos, manter uma conversa nem se destacar em tarefas de raciocínio complexo», informa o Techstrong.ai.
Como ele é construído
O Decider 2B parte do modelo Qwen3.5-2B-Base, da Alibaba. A Strands removeu a cabeça de modelagem de linguagem, a camada final que transforma o estado interno do modelo em palavras. No lugar dela há uma «cabeça de ponteiros» com cerca de 1 milhão de parâmetros, segundo o SiliconANGLE.
O Tech Times explica como a cabeça funciona. Ela compara a leitura que o modelo faz da entrada com cada opção candidata, usando um produto escalar, uma pontuação simples de similaridade. O resultado é uma lista ordenada de opções com probabilidades. A própria publicação da Strands diz que o modelo foi adaptado com um adaptador LoRA de posto 16, um pequeno complemento treinado em vez do conjunto completo de pesos.
Os relatos dão o tamanho como cerca de 1,9 bilhão de parâmetros. A Strands arredonda para 2 bilhões no nome.
Os números
| Medida | Resultado | Informado por |
|---|---|---|
| Latência mediana, RTX 3090 | 115 ms | Strands, Tech Times |
| Latência no percentil 95 | 299 ms | Tech Times |
| Latência, MacBook Apple M3 | 153 ms | Strands |
| Precisão no JevBench v1 | 72,3% (167 de 231 tarefas) | Tech Times, Techstrong.ai |
| Tarefas do nível fácil | 100% | Techstrong.ai |
| Tarefas do nível difícil | 50,5% | Techstrong.ai |
| Erro de calibração esperado | 0,052 | Tech Times |
O JevBench é um conjunto de testes público para modelos de decisão. A Strands diz que o Decider 2B ficou em terceiro entre 33 modelos da classe 2B. Sem contar os modelos um pouco acima de 2 bilhões de parâmetros, ele fica em primeiro entre 30.
O erro de calibração mede o quanto a confiança de um modelo corresponde à realidade. Um valor baixo como 0,052 significa que, quando o modelo diz ter 90% de certeza, ele acerta perto dessa frequência. Isso importa mais aqui do que a precisão bruta, como a próxima seção explica.
O modelo e seu código podem ser baixados de graça. O Tech Times informa a licença Apache 2.0. Os pesos estão no Hugging Face, na organização StrandsAgents, e o código de treinamento está no GitHub, em strands-labs/strands-decider.
Uma classe de modelos em crescimento
Os modelos de decisão estão virando uma categoria própria. Segundo o Techstrong.ai, a Strands credita ao Jev, da TypeSafe AI, lançado em setembro, o mérito de chamar a atenção para essa abordagem. Um rival de pesos abertos, o Laya, respondeu ao Jev no mesmo mês. A Cloudflare veio em seguida, em 4 de outubro, com o Clef, modelos de pesos abertos que devolvem decisões.
A AWS apresenta a troca em termos de velocidade. O modelo «elimina a necessidade de gerar texto, que consome enormes quantidades de tokens e aumenta a latência da resposta», disse a empresa ao SiliconANGLE.
O que isso significa para os desenvolvedores
- Coloque-o na frente do seu LLM, não no lugar dele. Use o Decider 2B para as etapas de escolha fixa de um agente: roteamento, escolha de ferramentas e verificações de política. Deixe a escrita e o raciocínio para o modelo grande.
- Use a pontuação de confiança como um filtro. Como o modelo é bem calibrado, você pode definir um limite. Acima dele, aja com base na escolha. Abaixo, passe a decisão a um modelo maior ou a uma pessoa.
- Mantenha-o longe das decisões difíceis. Uma pontuação de 50,5% nas tarefas difíceis fica perto de um cara ou coroa com duas opções. Teste suas próprias decisões e separe-as por dificuldade antes de confiar nele.
- Escreva opções que o modelo consiga distinguir. A cabeça de ponteiros compara a entrada com o texto de cada opção. Rótulos claros e distintos dão a ele mais material do que rótulos quase iguais.
- Rode-o localmente. Com cerca de 2 bilhões de parâmetros, ele cabe em uma GPU de consumo ou em um notebook. Assim, as decisões de rotina ficam fora do medidor e fora da rede.
Primeiro, monte um pequeno conjunto de testes a partir dos logs reais do seu agente. Depois, compare as escolhas do Decider 2B com as do seu LLM e meça com que frequência elas coincidem.
Fontes
- Introducing Strands Decider 2B: a small, open source, decision model - Strands Agents
- AWS debuts Strands Decider 2B, a first lightweight decision model for accelerate agentic workflows - SiliconANGLE
- AWS Releases Decision Model for AI Agents That Routes Without Generating Any Text - Tech Times
- AWS Explores Decision Models With Strands Decider 2B - Techstrong.ai
Artigos relacionados
Cloudflare Clef: modelos de pesos abertos que devolvem decisões
O Clef (27B) e o Clef-flash (9B), da Cloudflare, respondem a perguntas tipadas em vez de escrever texto, com latência mediana de 209 ms e 39 ms, sob Apache 2.0.
Qwen3.5-9B gasta 32 KB por token no cache KV
O Qwen3.5-9B usa atenção completa em apenas 8 das suas 32 camadas, então o cache KV custa 32 KB por token. Essa proporção decide se ele cabe em 8 GB.
EmbeddingGemma 2 leva a busca multimodal para o celular
O EmbeddingGemma 2, do Google DeepMind, coloca texto, código, imagens, vídeo e áudio em um só espaço vetorial, com 740M de parâmetros. O uso só de texto precisa de cerca de 191 MB de RAM.