Liquid AI LFM2.5-VL-DSpark acelera seu modelo de visão 3B
O modelo de rascunho LFM2.5-VL-DSpark da Liquid AI, com 280M de parâmetros, decodifica seu modelo de visão 3B até 3.13x mais rápido em um M5 Max, com saída idêntica.
Por Claire Whitmore
3 min de leitura
Traduzido automaticamente do original em inglês, que Claire Whitmore verificou e editou. Prevalece a versão em inglês. Como trabalhamos
Em números
- parameters in the DSpark draft model
- 279.5M
- added on top of the 3B target model
- 8.9%
- best decode speedup, Apple M5 Max
- 3.13x
- Apple M5 Max (MLX)
- 3.13x
- Nvidia H100
- 2.66x
- Apple M3 Ultra (llama.cpp)
- 2.14x
A Liquid AI lançou o LFM2.5-VL-DSpark em 24 de setembro de 2026, um pequeno modelo complementar que faz seu modelo de visão e linguagem de 3 bilhões de parâmetros responder mais rápido. No chip M5 Max da Apple, ele decodifica até 3.13 vezes mais rápido, segundo a publicação da Liquid AI no Hugging Face. A saída continua exatamente a mesma, o que importa para quem roda modelos de compreensão de imagens em hardware local.
Um modelo de visão e linguagem lê imagens e texto e responde em texto. O modelo da Liquid AI para isso é o LFM2.5-VL-3B. O DSpark não o substitui. Ele funciona ao lado dele e o ajuda a escrever respostas mais rápido.
Como um modelo de rascunho acelera as respostas
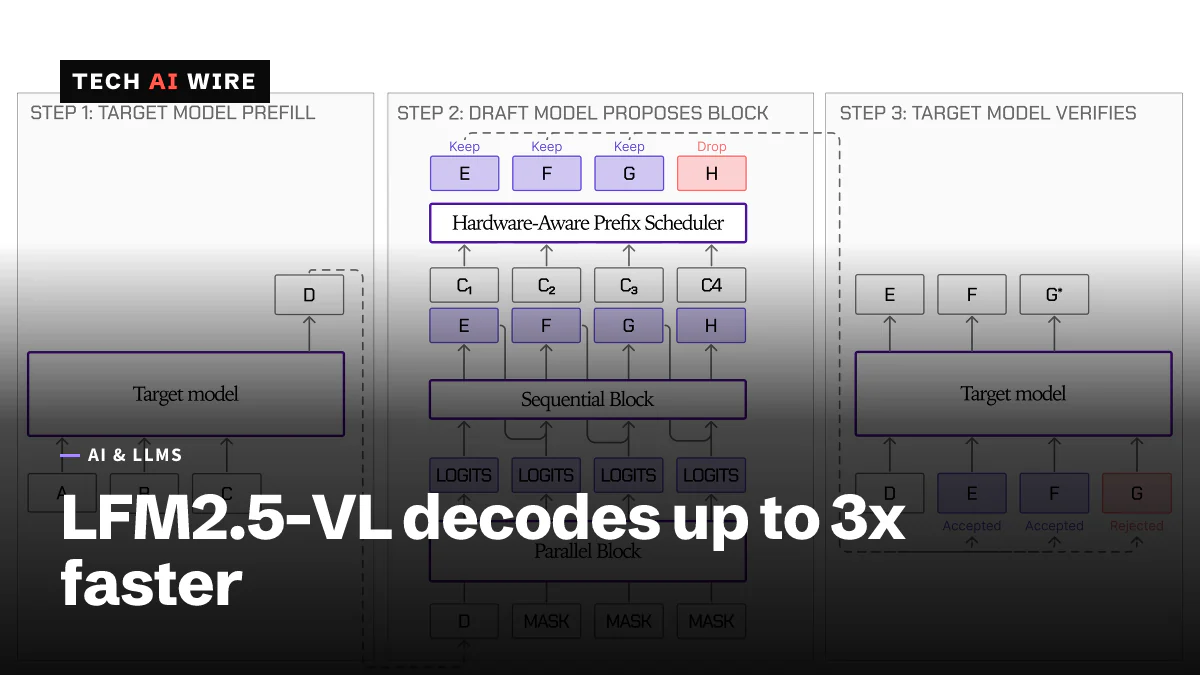
A técnica se chama decodificação especulativa. Um pequeno modelo de "rascunho" adivinha rapidamente as próximas palavras, chamadas tokens. O grande modelo "alvo" então verifica todos esses palpites em uma única passada. Ele mantém os que aprova e descarta o resto.
Verificar um lote de palpites de uma vez é muito mais barato do que escrever cada token um por um. Em sua publicação anterior sobre o DSpark, a Liquid AI explica o motivo: "A maior parte da latência vem da transferência dos pesos da DRAM para a SRAM, não de computação intensa." Em termos simples, a parte lenta é mover o modelo pela memória, não a conta em si.
Como o modelo alvo aprova cada token, a resposta final não muda. A Liquid AI diz que o método "troca um aumento mínimo no uso de memória por uma aceleração maior, sem alterar a qualidade da saída."
O que há dentro do LFM2.5-VL-DSpark
O RuntimeWire estima o modelo de rascunho em 279.5 milhões de parâmetros, cerca de 8.9% do tamanho do modelo alvo. Ele usa quatro camadas só de atenção e propõe blocos de oito a nove tokens por vez.
A publicação da Liquid AI detalha ainda mais o rascunho: uma pilha de decodificador de 193.0M, uma camada de projeção de 21.0M e uma "cabeça de Markov" de 65.5M. O rascunho trabalha sobre as representações internas do modelo alvo, então trata entradas de imagem e de texto da mesma forma.
Aceleração por hardware
Os ganhos dependem da máquina. A velocidade de decodificação é a rapidez com que o modelo escreve sua resposta. A velocidade de ponta a ponta também inclui a leitura da imagem e do prompt.
| Hardware | Aceleração na decodificação | Aceleração de ponta a ponta |
|---|---|---|
| Apple M5 Max (MLX) | 2.30x-3.13x | 1.56x-2.62x |
| Apple M3 Ultra (llama.cpp) | 1.57x-2.14x | 1.30x-1.77x |
| Nvidia H100 GPU | 2.04x-2.66x | 1.64x-2.27x |
O RuntimeWire informa que o modelo alvo aceita de 3.2 a 4.5 tokens de rascunho por verificação. Esses testes usaram tamanho de lote um e pesos de 16 bits.
Os limites apontados pela Liquid AI
A decodificação especulativa "acelera apenas a decodificação, não a codificação visual nem o prefill", diz a publicação no Hugging Face. A codificação visual transforma a imagem em números que o modelo pode usar. O prefill lê o prompt antes de a resposta começar. Em dispositivos pequenos, essas etapas tomam boa parte do tempo, então os ganhos de ponta a ponta são menores que os da decodificação.
O rascunho também não roda sozinho. Ele só funciona em par com o LFM2.5-VL-3B.
O que isso significa para desenvolvedores
Se você roda o LFM2.5-VL-3B localmente, experimente o rascunho agora. A Liquid AI diz que ele já está integrado ao llama.cpp, ao MLX-VLM e ao SGLang, então deve se encaixar em uma configuração existente.
Meça sua própria carga de trabalho, não o número da manchete. Respostas curtas sobre imagens grandes terão os menores ganhos, porque a codificação da imagem domina. Respostas longas em texto, como descrever um gráfico em detalhes, terão os maiores.
Reserve memória. O rascunho acrescenta menos de 9% ao tamanho do modelo, o que é pouco, mas não zero em um celular ou notebook com pouca RAM.
Observe também o padrão. A Liquid AI já lançou em agosto rascunhos DSpark para seus modelos de texto, com uma aceleração média de 2.67x relatada em uma H100 para o LFM2.5-2.6B. Um rascunho equivalente para o modelo de visão sugere que esses pequenos modelos auxiliares estão se tornando parte padrão dos lançamentos de pesos abertos, não um extra.
Fontes
Artigos relacionados
Nanbeige4.3-33B: modelo aberto supera o Qwen em programação com agentes
O laboratório Nanbeige, da BOSS Zhipin, lançou o Nanbeige4.3-33B sob Apache 2.0 e afirma ter 80,9 no Terminal-Bench 2.1, contra 73,0 do Qwen3.8-27B.
EmbeddingGemma 2 leva a busca multimodal para o celular
O EmbeddingGemma 2, do Google DeepMind, coloca texto, código, imagens, vídeo e áudio em um só espaço vetorial, com 740M de parâmetros. O uso só de texto precisa de cerca de 191 MB de RAM.
NVIDIA Kumo Tabular lidera o TabArena com pesos abertos
O Kumo Tabular da NVIDIA faz previsões a partir de uma tabela rotulada em uma única passada, sem nenhum treinamento. Ele fica em primeiro no TabArena com 1.950 de Elo, em tamanhos de 28M a 215M.