EmbeddingGemma 2 bringt multimodale Suche aufs Smartphone
Google DeepMinds EmbeddingGemma 2 bildet Text, Code, Bilder, Video und Audio in einem Vektorraum ab, mit 740M Parametern. Die reine Textnutzung braucht etwa 191 MB RAM.
4 Min. Lesezeit
Die Zahlen
- total parameters across three encoders
- 740M
- embedding dimensions, truncatable to 128
- 768
- RAM for text-only use on a Pixel 11 Pro
- ~191 MB
- MTEB Code score, up from 68.76
- 78.68
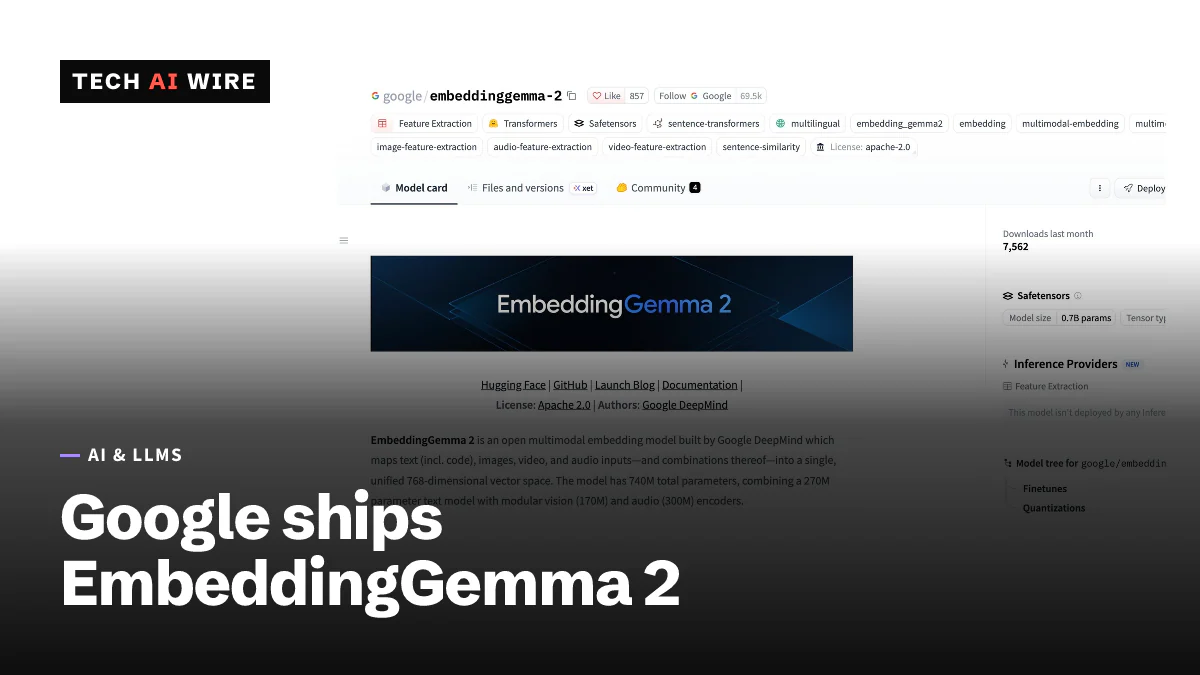
Google DeepMind hat am 6. Oktober 2026 EmbeddingGemma 2 veröffentlicht, ein offenes Modell, das Text, Code, Bilder, Video und Audio in Vektoren eines gemeinsamen Raums umwandelt. Es hat 740 Millionen Parameter und erscheint unter der Apache-2.0-Lizenz, wie Googles Entwicklerleitfaden angibt. Die reine Textversion läuft auf einem Smartphone mit etwa 191 MB Speicher. Damit lassen sich Fotos, Sprachnotizen und Dokumente eines Nutzers durchsuchen, ohne sie an einen Server zu senden.
Was ein Embedding-Modell leistet
Ein Embedding-Modell wandelt einen Inhalt in eine Liste von Zahlen um, einen sogenannten Vektor. Ähnliche Inhalte erhalten ähnliche Vektoren. Die Suche besteht dann darin, die Vektoren zu finden, die einer Anfrage am nächsten liegen.
Das ist der Motor hinter RAG, kurz für Retrieval-Augmented Generation. Dabei findet eine App zuerst passende Dokumente, bevor sie ein Sprachmodell antworten lässt. EmbeddingGemma 2 legt jede Art von Medium in denselben Raum. Eine Textanfrage wie „Hund am Strand“ kann daher direkt ein Foto, ein Videobild oder einen Audioclip finden.
Der Edge-Leitfaden beschreibt es als ein Modell, das „bildet Text, Bilder, Videobilder und Audio in einem einzigen, einheitlichen Vektorraum ab.“
So ist es aufgebaut
Das Modell besteht aus stapelbaren Encodern, die sich einen Embedding-Raum teilen:
| Teil | Parameter |
|---|---|
| Text- und Code-Encoder | 270M |
| Vision-Encoder | 170M |
| Audio-Encoder | 300M |
| Gesamt | 740M |
Stapelbar heißt: Eine reine Text-App kann nur den 270M-Kern laden und Vision oder Audio nur bei Bedarf ergänzen.
Die Ausgabe ist ein Vektor mit 768 Dimensionen. Er lässt sich mit Matryoshka Representation Learning auf 512, 256 oder 128 Dimensionen kürzen. Das ist eine Trainingsmethode, die die wichtigsten Informationen an den Anfang jedes Vektors packt. Laut Google senkt 128 Dimensionen den Speicherbedarf um das 6-Fache. „Der Großteil der vollen Qualität des ursprünglichen Embeddings bleibt bei Text und Code erhalten, und etwa 95 % bei der Suche in Bildern, Videos und Sprache“, heißt es im Entwicklerleitfaden.
Das Kontextfenster umfasst 8.192 Token, viermal so viel wie bei der ersten Version. Unite.AI listet auf, was in einen Aufruf passt:
- 29 Bilder mit je 280 Token
- 58 Videobilder mit je 140 Token
- 5,5 Minuten Audio bei 25 Token pro Sekunde
Unite.AI ergänzt, dass das Modell mehr als 100 Sprachen unterstützt und sein Trainingsdaten-Stichtag im Januar 2025 liegt.
Benchmarks und Geschwindigkeit
| Test | EmbeddingGemma 2 | Quelle |
|---|---|---|
| MTEB Code | 78,68 (EmbeddingGemma 1: 68,76) | Unite.AI, Crypto Briefing |
| MTEB multilingual | 61,36 | Unite.AI |
| MMEB v2 Bildsuche | 57,28 | Unite.AI |
| MMEB v2 Videosuche | 50,67 | Unite.AI |
| MSEB Audio | 69,54 | Unite.AI |
Der Code-Wert ist der größte Sprung, ein Plus von 9,92 Punkten. Googles Leitfaden beschreibt ihn als 14 % höher als bei der ersten Version.
Bei der Hardware nennt Google mit Quantisierung etwa 191 MB RAM für reine Textnutzung und etwa 567 MB für volle multimodale Nutzung auf einem Pixel 11 Pro. Der Edge-Leitfaden maß die Bild-Einbettung mit 37,3 Millisekunden auf einer MacBook-M5-Pro-GPU, also 26,9 Bilder pro Sekunde.
Derselbe Leitfaden sagt, das Modell könne eine Eingabe in unter 100 Millisekunden unter 500 Optionen einsortieren, ganz ohne Training. Das rückt es in die Nähe der neuen Klasse von Entscheidungsmodellen wie Cloudflares Clef.
Wo man es bekommt
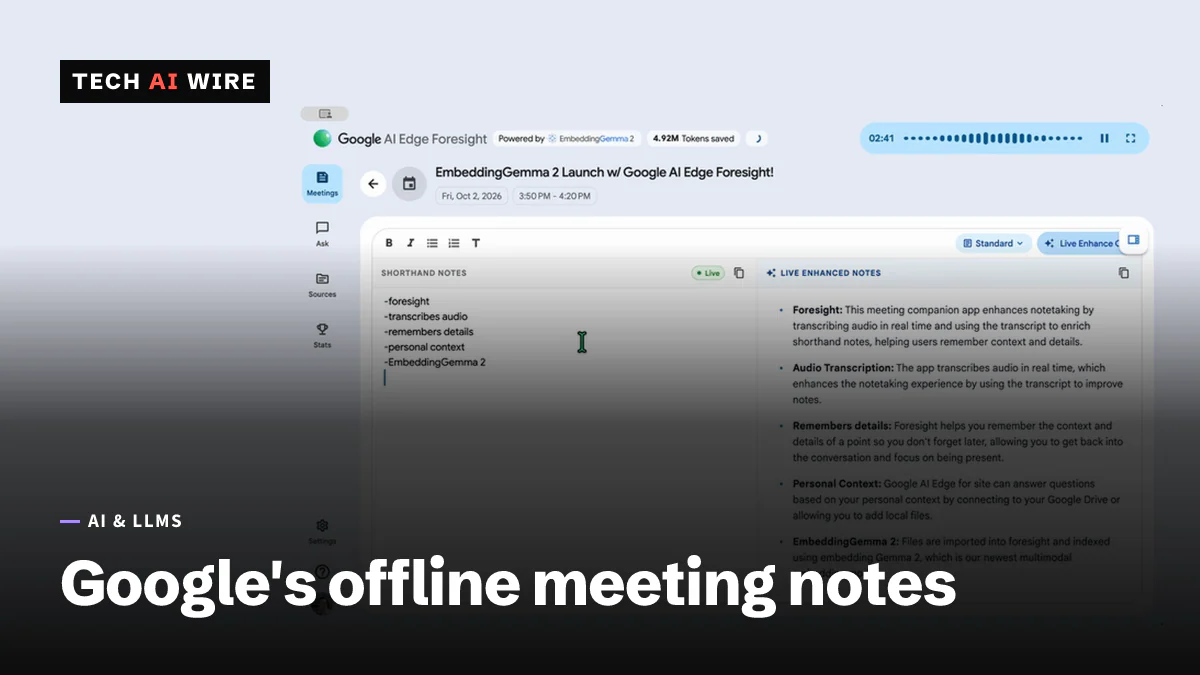
Die Gewichte liegen auf Hugging Face als google/embeddinggemma-2 sowie auf Kaggle und in der LiteRT Community. Crypto Briefing nennt Unterstützung in sentence-transformers, Hugging Face transformers, LiteRT und MediaPipe, MLX und Ollama. Google liefert außerdem vorquantisierte LiteRT-Pakete als .litertlm-Dateien. Google nutzt es auch in AI Edge Foresight, einer experimentellen Mac-App, die Meeting-Notizen offline erstellt.
Was das für Entwickler bedeutet
- Suche aufs Gerät verlagern. Mit etwa 191 MB für Text passt das Modell in eine mobile App. Private Inhalte lassen sich lokal indexieren, was laut Unite.AI bedeutet, dass persönliche Dateien „nicht auf einen Server hochgeladen werden müssen, nur um durchsuchbar zu werden.“
- Kürzung nutzen, um Speicher zu sparen. Bei einer großen Vektordatenbank lohnt ein Test mit 256 oder 128 Dimensionen. Google nennt bei 128 eine 6-fache Ersparnis bei weitgehend erhaltener Textqualität.
- Neu einbetten, wenn das Modell wechselt. Vektoren von EmbeddingGemma 1 und 2 sind nicht austauschbar. Planen Sie eine komplette Neuindizierung statt einer Mischung.
- Für die Codesuche ausprobieren. Ein Plus von 9,92 Punkten bei MTEB Code macht es einen Test für Repository-Suche und Code-RAG wert.
- Nur die nötigen Encoder laden. Eine reine Textfunktion braucht nicht die 470M Parameter der Vision- und Audio-Encoder. Kleinere Lasten bedeuten schnellere Starts auf Smartphones.
Testen Sie es zuerst mit Ihren eigenen Anfragen gegen Ihr aktuelles Embedding-Modell. Die öffentlichen Benchmarks zeigen die Richtung, Ihre eigenen Daten zeigen den echten Gewinn.
Quellen
- EmbeddingGemma 2: The Developer Guide - Google Developers Blog
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 - Google Developers Blog
- DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space - Unite.AI
- Google releases EmbeddingGemma 2, a 740 million parameter open-weight model under Apache 2.0 - Crypto Briefing
Ähnliche Artikel
Liquid AI LFM2.5-VL-DSpark beschleunigt sein 3B-Vision-Modell
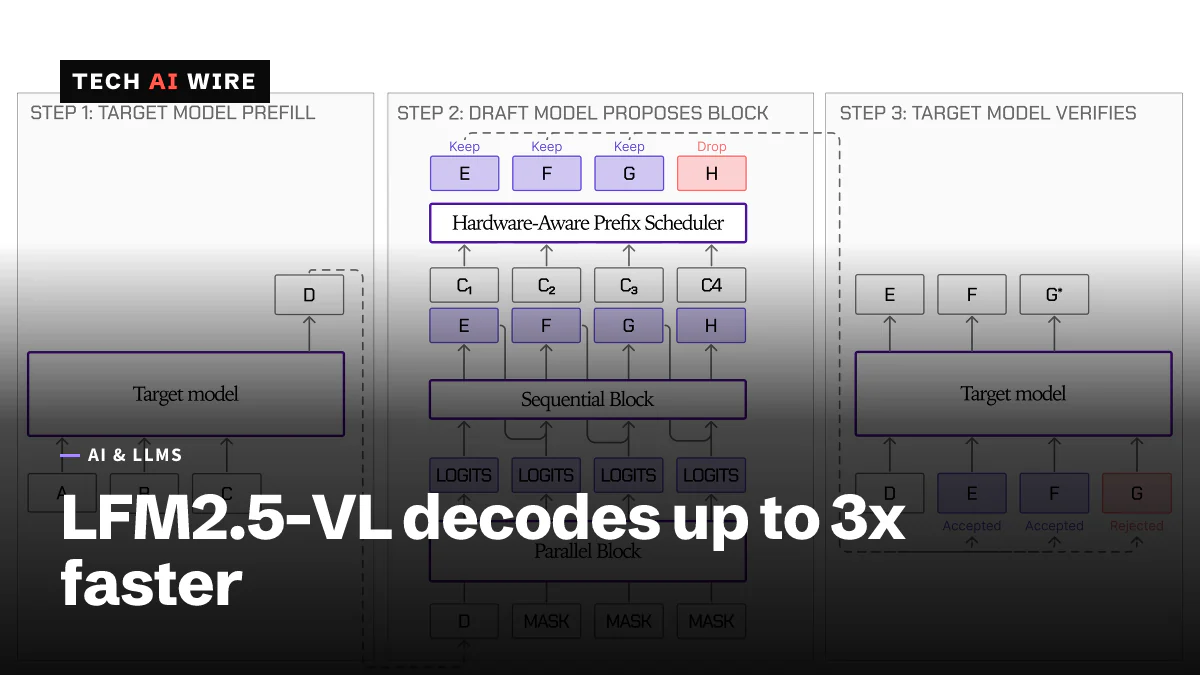
Das Draft-Modell LFM2.5-VL-DSpark von Liquid AI mit 280M Parametern dekodiert sein 3B-Vision-Modell auf einem M5 Max bis zu 3.13x schneller, bei identischer Ausgabe.
Google AI Edge Foresight schreibt Meeting-Notizen offline
Google AI Edge Foresight, eine experimentelle Mac-App, macht direkt auf dem Gerät aus Stichpunkten Meeting-Notizen. Sie nutzt Gemma 4 und EmbeddingGemma 2 mit 740 Mio. Parametern.
Strands Decider 2B trifft Agenten-Entscheidungen in 115 ms
Strands Decider 2B von AWS ist ein Open-Source-Modell, das aus einer Liste auswählt, statt Text zu schreiben. Auf einer RTX 3090 antwortet es in 115 ms und erreicht 72,3 % bei JevBench.