EmbeddingGemma 2 apporte la recherche multimodale sur un téléphone
EmbeddingGemma 2 de Google DeepMind place texte, code, images, vidéo et audio dans un seul espace vectoriel, avec 740M de paramètres. L'usage texte seul demande environ 191 Mo de RAM.
4 min de lecture
En chiffres
- total parameters across three encoders
- 740M
- embedding dimensions, truncatable to 128
- 768
- RAM for text-only use on a Pixel 11 Pro
- ~191 MB
- MTEB Code score, up from 68.76
- 78.68
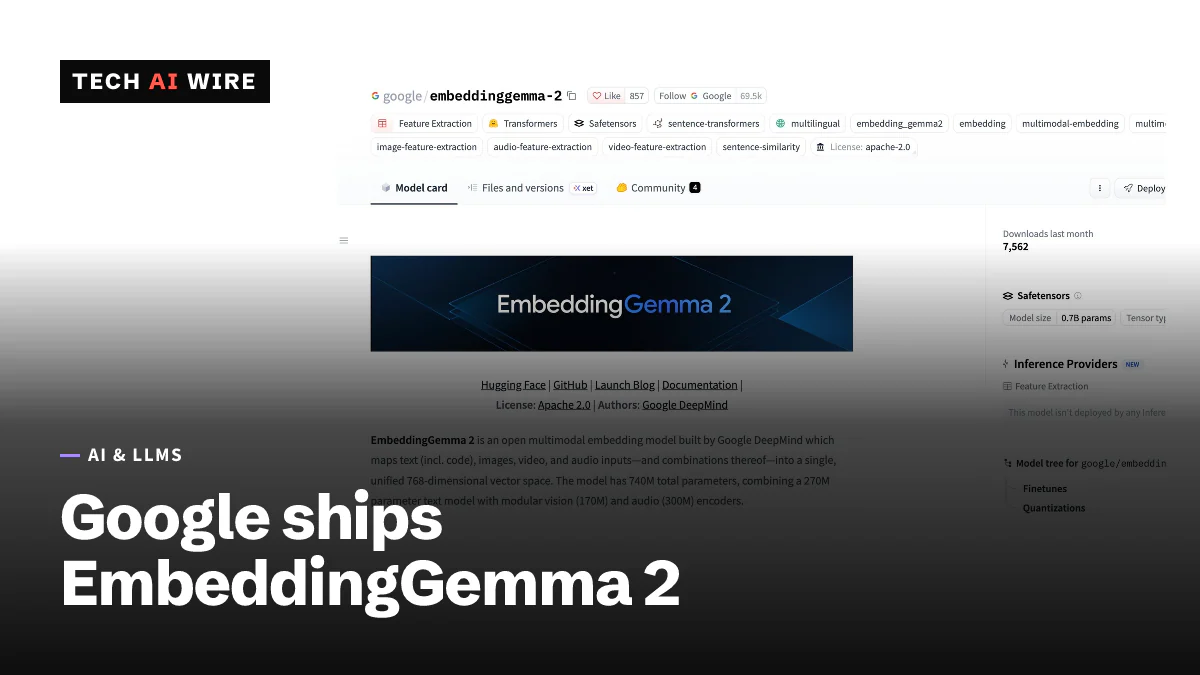
Google DeepMind a publié EmbeddingGemma 2 le 6 octobre 2026, un modèle ouvert qui transforme texte, code, images, vidéo et audio en vecteurs d'un même espace partagé. Il compte 740 millions de paramètres et sort sous licence Apache 2.0, selon le guide développeur de Google. La version texte seul tourne dans environ 191 Mo de mémoire sur un téléphone. Il devient ainsi réaliste de chercher dans les photos, les notes vocales et les documents d'un utilisateur sans les envoyer à un serveur.
Ce que fait un modèle d'embedding
Un modèle d'embedding transforme un contenu en une liste de nombres, appelée vecteur. Des contenus similaires donnent des vecteurs similaires. La recherche consiste alors à trouver les vecteurs les plus proches d'une requête.
C'est le moteur du RAG, ou génération augmentée par récupération, où une application trouve d'abord des documents pertinents avant de demander à un modèle de langage de répondre. EmbeddingGemma 2 place tous les types de médias dans le même espace. Une requête texte comme « chien sur une plage » peut donc retrouver directement une photo, une image de vidéo ou un clip audio.
Le guide edge le décrit comme un modèle qui "fait correspondre texte, images, images de vidéo et audio à un espace vectoriel unique et unifié."
Comment il est construit
Le modèle se compose d'encodeurs empilables qui partagent un seul espace d'embedding :
| Élément | Paramètres |
|---|---|
| Encodeur texte et code | 270M |
| Encodeur vision | 170M |
| Encodeur audio | 300M |
| Total | 740M |
Empilable signifie qu'une application texte seul peut charger uniquement le noyau de 270M, et n'ajouter la vision ou l'audio que si elle en a besoin.
La sortie est un vecteur de 768 dimensions. Il peut être réduit à 512, 256 ou 128 dimensions grâce au Matryoshka Representation Learning, une méthode d'entraînement qui place l'information la plus importante au début de chaque vecteur. Google indique que 128 dimensions réduisent le stockage d'un facteur 6. « L'essentiel de la qualité de l'embedding d'origine est conservé sur le texte et le code, et environ 95 % sur la recherche d'images, de vidéos et de parole », précise le guide développeur.
La fenêtre de contexte est de 8 192 jetons, soit quatre fois celle de la première version. Unite.AI énumère ce qui tient dans un seul appel :
- 29 images, à 280 jetons chacune
- 58 images de vidéo, à 140 jetons chacune
- 5,5 minutes d'audio, à 25 jetons par seconde
Unite.AI ajoute que le modèle prend en charge plus de 100 langues et que ses données d'entraînement s'arrêtent en janvier 2025.
Benchmarks et vitesse
| Test | EmbeddingGemma 2 | Source |
|---|---|---|
| MTEB Code | 78,68 (EmbeddingGemma 1 : 68,76) | Unite.AI, Crypto Briefing |
| MTEB multilingual | 61,36 | Unite.AI |
| MMEB v2 recherche d'images | 57,28 | Unite.AI |
| MMEB v2 recherche de vidéos | 50,67 | Unite.AI |
| MSEB audio | 69,54 | Unite.AI |
Le score en code est le plus gros bond, un gain de 9,92 points. Le guide de Google le décrit comme 14 % plus élevé que celui de la première version.
Côté matériel, Google indique environ 191 Mo de RAM pour l'usage texte seul et environ 567 Mo pour l'usage multimodal complet sur un Pixel 11 Pro, avec quantification. Le guide edge a mesuré l'embedding d'une image à 37,3 millisecondes sur un GPU de MacBook M5 Pro, soit 26,9 images par seconde.
Le même guide affirme que le modèle peut classer une entrée parmi 500 options en moins de 100 millisecondes, sans entraînement. Cela le rapproche de la nouvelle classe de modèles de décision comme Clef de Cloudflare.
Où le trouver
Les poids sont sur Hugging Face sous le nom google/embeddinggemma-2, ainsi que sur Kaggle et dans la LiteRT Community. Crypto Briefing cite la prise en charge dans sentence-transformers, Hugging Face transformers, LiteRT et MediaPipe, MLX et Ollama. Google fournit aussi des paquets LiteRT pré-quantifiés sous forme de fichiers .litertlm. Le modèle équipe également AI Edge Foresight, une application Mac expérimentale qui prend des notes de réunion hors ligne.
Ce que cela change pour les développeurs
- Déplacez la recherche sur l'appareil. À environ 191 Mo pour le texte, le modèle tient dans une application mobile. Le contenu privé peut être indexé en local, ce qui, selon Unite.AI, signifie que les fichiers personnels « n'ont pas besoin d'être envoyés à un serveur pour devenir consultables ».
- Utilisez la troncature pour réduire le stockage. Si votre base de vecteurs est grande, testez 256 ou 128 dimensions. Google annonce une économie de 6x à 128 avec l'essentiel de la qualité texte conservé.
- Recalculez les embeddings si vous changez de modèle. Les vecteurs d'EmbeddingGemma 1 et 2 ne sont pas interchangeables. Prévoyez une réindexation complète plutôt qu'un mélange.
- Essayez-le pour la recherche de code. Un gain de 9,92 points sur MTEB Code justifie un test pour la recherche dans les dépôts et le RAG sur code.
- Ne chargez que les encodeurs nécessaires. Une fonction texte seul n'a pas besoin des 470M de paramètres des encodeurs vision et audio. Des charges plus petites donnent des démarrages plus rapides sur téléphone.
Comparez-le d'abord à votre modèle d'embedding actuel sur vos propres requêtes. Les benchmarks publics montrent la direction, vos propres données montrent le gain réel.
Sources
- EmbeddingGemma 2: The Developer Guide - Google Developers Blog
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 - Google Developers Blog
- DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space - Unite.AI
- Google releases EmbeddingGemma 2, a 740 million parameter open-weight model under Apache 2.0 - Crypto Briefing
Articles liés
Liquid AI LFM2.5-VL-DSpark accélère son modèle de vision 3B
Le modèle brouillon LFM2.5-VL-DSpark de Liquid AI, avec 280M de paramètres, décode son modèle de vision 3B jusqu'à 3.13x plus vite sur un M5 Max, avec une sortie identique.
Google AI Edge Foresight prend des notes de réunion hors ligne
Google AI Edge Foresight, une application Mac expérimentale, transforme des notes abrégées en notes de réunion directement sur l'appareil, avec Gemma 4 et EmbeddingGemma 2 (740M de paramètres).
Strands Decider 2B tranche les choix d'agents en 115 ms
Strands Decider 2B d'AWS est un modèle open source qui choisit dans une liste au lieu d'écrire du texte. Il répond en 115 ms sur une RTX 3090 et obtient 72,3 % sur JevBench.