ElevenLabs Eleven Realtime、音声エージェントが570ミリ秒で応答
ElevenLabsの音声エージェント向けモデル「Eleven Realtime v1 Max」は、同社によると570ミリ秒で応答し、Big Bench Audioで98.8%を記録します。APIはOpenAIのRealtime(リアルタイム)形式を踏襲しています。
4 分で読めます
数字で見る
- v1 Max time to first audio, per ElevenLabs
- 570 ms
- v1 Max score on Big Bench Audio
- 98.8%
- languages supported
- 90+
- Eleven Realtime v1 Max
- 98.8%
- Grok Voice 3.0
- 98.5%
- Gemini 3.8 Live Extended Thinking
- 97.7%
- Eleven Realtime v1 Mini
- 75.9%
ElevenLabsは2026年10月20日、音声エージェントを構築するための2つの音声モデル「Eleven Realtime」を公開しました。どちらも、聞き取りと応答を1つのステップで行います。同社によると、大きい方のv1 Maxは570ミリ秒で応答を始め、標準的な音声推論テストでトップに立っています。開発者にとっては、APIの方が大きなニュースかもしれません。APIはOpenAIのRealtime形式を踏襲しているため、既存のコードは2カ所の変更で乗り換えられます。
音声エージェントとは、電話に応対するサポート窓口のように、音声で会話するソフトウェアです。ほとんどはチェーンとして作られており、音声をテキストにし、次に言語モデルを通し、最後にテキストを音声にします。つなぎ目ごとに遅延が加わります。ElevenLabsはEleven Realtimeをspeech-to-speechとして売り出しています。つまり、1つのサービスに音声が入り、そこから音声が出てくるということです。
2つのモデル:v1 Maxとv1 Mini
ElevenLabsの発表は、用途によってモデルを分けています。小さい方のv1 Miniは「低コストでの自然な会話」向けで、速度が最も重要なシンプルなチャットなどを想定しています。大きい方のv1 Maxは「複雑なタスクと複数ステップのワークフロー」向けで、ツールを使う通話も含みます。
ElevenLabsによると、分析会社のArtificial Analysisが両モデルを独立して評価しました。ツール利用を誰が測定したのかは明らかにしていません。
| 指標 | v1 Max | v1 Mini |
|---|---|---|
| 最初の音声までの時間(ElevenLabsの数値) | 570ミリ秒 | 620ミリ秒 |
| Big Bench Audio(音声での推論) | 98.8% | 75.9% |
| Full-Duplex-Bench(会話の流れ) | 94.1% | 95.8% |
| Speech Agent Arena(人間による選好) | 998 | 988 |
| 完了したツール利用タスク | 87.1% | 60.3% |
Big Bench Audioは、音声で1,000問の質問をします。Full-Duplex-Benchは、間や割り込みといった話者交代をモデルがどれだけ自然にこなすかを測ります。この項目ではMiniがMaxをわずかに上回っており、会話向けモデルという位置付けに合っています。
レイテンシーの数値は食い違っています。ElevenLabsのブログと製品ページは、Maxを570ミリ秒、Miniを620ミリ秒としています。フランスのテックメディアであるJournal du Netは、出典を示さずに470ミリ秒と500ミリ秒と報じています。Journal du Netは競合製品も挙げています。Grok Voice 3.0は810ミリ秒かかり、音声推論で98.5%を記録し、Gemini 3.8 Live Extended Thinkingは97.7%です。OpenAIのGPT-Realtime-2(High)は1.14秒かかります。
OpenAIのRealtime形式が土台
ElevenLabsによると、Realtime APIはOpenAIのRealtime仕様に準拠しています。既存のアプリを移すには、エンドポイントのURLとモデル名を変えるだけで、OpenAI自身のSDKもそのまま動きます。製品ページには、モデルIDeleven_realtime_v1_miniが載っています。
制約もあります。APIはWebSocketのみで動作し、提供開始時点でWebRTC版はないため、WebRTCで作られたブラウザーアプリは通信方式を変える必要があります。電話回線、WhatsApp、コンタクトセンター、ナレッジベース、ガードレール、モニタリングはいずれも、素のAPIではなく、ElevenLabsの別プラットフォームであるElevenAgentsが必要です。
Tech Timesは、設計について注意点を付け加えています。ElevenLabsは、speech-to-speechという呼び方とは裏腹に、Eleven Realtimeの内部はコンポーネントのチェーンであると認めています。開発者はそれらの部品を確認、設定、交換できず、途中のステップのテキスト書き起こしもありません。
料金とコンプライアンスは未確定
ElevenLabsは、これらのモデルの料金を公表していません。Realtime APIは、接続中の音声1分ごとの料金にトークン料金を加えて課金され、トークン単価はどのプランでも同じです。ElevenAgentsは、通常の分単位の料金に言語モデルのコストを加えた料金体系です。Journal du Netによると、トークン単価は提供開始時点では発表されませんでした。
コンプライアンスについても、情報源によって内容が異なります。製品ページには、プラットフォームとしてHIPAA準拠とZero Retention Modeが記載されています。Tech Timesは、v1 Miniはどちらにも対応していないと報じています。同メディアによると、v1 Maxが両方に対応するのは米国またはEUのデータレジデンシーの場合のみで、インドやシンガポールは対象外です。
両モデルとも90以上の言語を話します。音声エージェントの利用は急速に伸びています。Tech Timesによると、ElevenAgentsは週1,500万件の会話を処理しており、これは2026年2月の3倍です。この成長は、同社が今月企業価値を倍の220億ドルに引き上げた理由の1つです。
開発者にとっての意味
OpenAI互換のAPIなので、テストは手軽です。すでにOpenAIのRealtime APIをWebSocket経由で使っているなら、ブランチをElevenLabsに向けて、自分の通話で比較してください。
- 用途でモデルを選ぶ。 ツールを呼び出したり手順に従ったりするエージェントにはMax、シンプルで気軽な会話にはMiniです。
- レイテンシーを自分で測る。 Maxについては、570ミリ秒と470ミリ秒という2組の数値が出回っています。自分のネットワークとリージョンで、最初の音声までの時間を計測してください。
- 書き起こしがないと何を失うかを確認する。 通話をログに残したり、回答を監査したり、ステップ間のテキストでチェックを実行したりしているなら、この設計ではそのどれもできません。
- モデルとリージョンごとにコンプライアンスを確認する。 医療や規制業種のチームは、Miniで構築する前に、HIPAAとデータレジデンシーの条件を書面で受け取るべきです。
- 導入を決める前に料金の発表を待つ。 分単位やトークン単位の料金はまだ公表されていません。MistralのVoxtral 3音声エージェントなどの競合とのコスト比較は、ElevenLabsが料金を公表してからにしてください。
出典
関連記事
Mistral Voxtral 3が音声エージェントに対応、1分あたり0.0035ドルから
MistralのVoxtral(ボクストラル)3は、1分あたり0.0035ドルからの音声認識、100万文字あたり13ドルの音声モデル、1分あたり0.04ドルからの音声エージェントAPIを追加しました。
Elorianの初モデルGlimpse、推論しながら画像を見直す
Elorian初のモデルGlimpseは、入力100万トークンあたり0.60ドルで、画像を見直しながら推論(リーズニング)します。11件のテストのうち4件でGPT-6 Astraを上回りました。
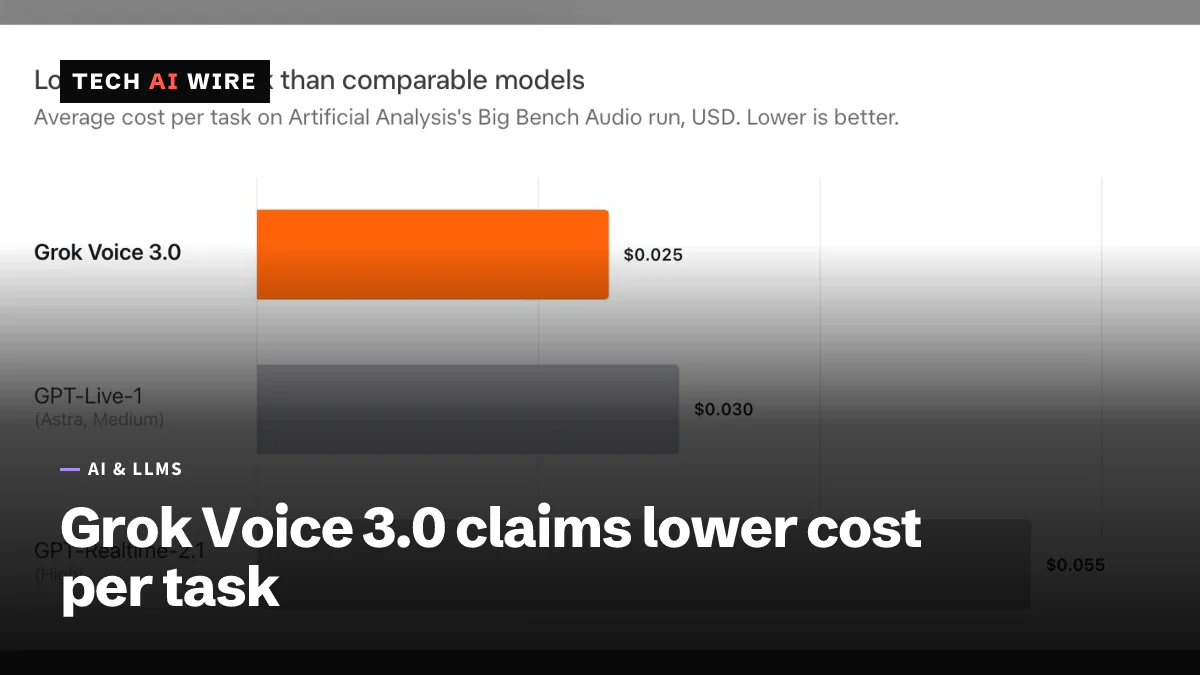
xAIのGrok Voice 3.0、1分0.08ドルで提供開始
xAIの音声モデルGrok Voice 3.0(グロック・ボイス)は、Voice Agent APIで1分0.08ドルです。価格は2.0と同じで、Artificial AnalysisのSpeech-to-Speech Indexで86.9を記録しました。