ElevenLabs Eleven Realtime : des agents vocaux qui répondent en 570 ms
Eleven Realtime v1 Max d'ElevenLabs répond en 570 ms et obtient 98,8 % sur Big Bench Audio, selon l'entreprise. Son API reprend le format Realtime d'OpenAI.
4 min de lecture
En chiffres
- v1 Max time to first audio, per ElevenLabs
- 570 ms
- v1 Max score on Big Bench Audio
- 98.8%
- languages supported
- 90+
- Eleven Realtime v1 Max
- 98.8%
- Grok Voice 3.0
- 98.5%
- Gemini 3.8 Live Extended Thinking
- 97.7%
- Eleven Realtime v1 Mini
- 75.9%
ElevenLabs a lancé Eleven Realtime le 20 octobre 2026 : deux modèles vocaux qui écoutent et répondent en une seule étape, pour créer des agents vocaux. Selon l'entreprise, le plus grand, v1 Max, commence à répondre en 570 millisecondes et arrive en tête d'un test standard de raisonnement vocal. Pour les développeurs, la plus grande nouveauté est peut-être l'API. Elle reprend le format Realtime d'OpenAI, si bien que du code existant peut basculer avec deux modifications.
Un agent vocal est un logiciel qui mène une conversation parlée, comme une ligne d'assistance qui répond aux appels. La plupart sont construits comme une chaîne : transcription de la parole en texte, puis un modèle de langage, puis synthèse de la parole à partir du texte. Chaque maillon ajoute du délai. ElevenLabs vend Eleven Realtime comme un modèle speech-to-speech, autrement dit l'audio entre dans un seul service et en ressort sous forme d'audio.
Deux modèles : v1 Max et v1 Mini
L'annonce d'ElevenLabs répartit la famille selon l'usage. Le plus petit, v1 Mini, est destiné à une « conversation naturelle à faible coût », comme des échanges simples où la vitesse compte le plus. Le plus grand, v1 Max, vise les « tâches complexes et les workflows en plusieurs étapes », y compris les appels qui utilisent des outils.
ElevenLabs indique que le cabinet d'analyse Artificial Analysis a évalué les deux modèles de façon indépendante. L'entreprise ne précise pas qui a mesuré l'utilisation d'outils.
| Mesure | v1 Max | v1 Mini |
|---|---|---|
| Délai avant le premier son, selon ElevenLabs | 570 ms | 620 ms |
| Big Bench Audio (raisonnement oral) | 98,8 % | 75,9 % |
| Full-Duplex-Bench (fluidité de la conversation) | 94,1 % | 95,8 % |
| Speech Agent Arena (préférence humaine) | 998 | 988 |
| Tâches avec outils accomplies | 87,1 % | 60,3 % |
Big Bench Audio pose 1 000 questions à l'oral. Full-Duplex-Bench mesure avec quel naturel un modèle gère les tours de parole, comme les pauses et les interruptions. Mini devance de peu Max sur ce test, ce qui correspond à son positionnement de modèle conversationnel.
Les chiffres de latence se contredisent. Le blog et la page produit d'ElevenLabs donnent 570 ms pour Max et 620 ms pour Mini. Journal du Net, un média tech français, rapporte 470 ms et 500 ms sans citer de source. Journal du Net cite aussi des concurrents. Grok Voice 3.0 met 810 ms et obtient 98,5 % en raisonnement vocal, et Gemini 3.8 Live Extended Thinking obtient 97,7 %. GPT-Realtime-2 (High) d'OpenAI met 1,14 seconde.
Bâti sur le format Realtime d'OpenAI
Selon ElevenLabs, la Realtime API suit la spécification Realtime d'OpenAI. Pour migrer une application existante, il suffit de changer l'URL du point de terminaison et le nom du modèle, et le SDK d'OpenAI lui-même fonctionne sans modification. La page produit affiche l'identifiant de modèle eleven_realtime_v1_mini.
Il y a des limites. L'API fonctionne uniquement via WebSocket, sans version WebRTC au lancement, donc les applications de navigateur construites sur WebRTC doivent changer de transport. Les lignes téléphoniques, WhatsApp, les centres de contact, les bases de connaissances, les garde-fous et la supervision nécessitent tous ElevenAgents, la plateforme distincte d'ElevenLabs, et non l'API seule.
Tech Times ajoute une réserve sur la conception. ElevenLabs confirme qu'Eleven Realtime est en interne une chaîne de composants, malgré l'étiquette speech-to-speech. Les développeurs ne peuvent ni inspecter, ni configurer, ni remplacer ces éléments, et il n'existe aucune transcription textuelle de l'étape intermédiaire.
Les prix et la conformité ne sont pas fixés
ElevenLabs n'a publié aucun prix pour ces modèles. La Realtime API est facturée à la minute d'audio connecté, plus les tokens, avec les mêmes prix par token sur toutes les offres. ElevenAgents applique sa tarification standard à la minute, plus le coût du modèle de langage. Selon Journal du Net, le prix par token n'a pas été annoncé au lancement.
La conformité varie aussi selon la source. La page produit mentionne la conformité HIPAA et un Zero Retention Mode pour la plateforme. Tech Times rapporte que v1 Mini ne dispose ni de l'une ni de l'autre. Selon le média, v1 Max ne prend en charge les deux qu'avec une résidence des données aux États-Unis ou dans l'UE, pas en Inde ni à Singapour.
Les deux modèles parlent plus de 90 langues. L'usage des agents vocaux progresse vite : ElevenAgents a traité 15 millions de conversations par semaine, trois fois son volume de février 2026, selon Tech Times. Cette croissance explique en partie pourquoi l'entreprise a doublé sa valorisation à 22 milliards de dollars ce mois-ci.
Ce que cela signifie pour les développeurs
L'API compatible avec OpenAI rend un test peu coûteux. Si vous utilisez déjà la Realtime API d'OpenAI via WebSocket, faites pointer une branche vers ElevenLabs et comparez sur vos propres appels.
- Choisissez le modèle selon l'usage. Max pour les agents qui appellent des outils ou suivent des étapes ; Mini pour des conversations simples et détendues.
- Mesurez la latence vous-même. Deux séries de chiffres circulent, 570 ms et 470 ms pour Max. Chronométrez le premier son sur votre propre réseau et dans votre propre région.
- Vérifiez ce que vous perdez sans transcription. Si vous enregistrez les appels, auditez les réponses ou faites des contrôles sur le texte entre les étapes, cette conception ne vous offre rien de tout cela.
- Confirmez la conformité par modèle et par région. Les équipes de santé et des secteurs réglementés devraient obtenir par écrit les conditions HIPAA et de résidence des données avant de bâtir sur Mini.
- Attendez les prix avant de vous engager. Aucun tarif à la minute ou par token n'est publié. Ne comparez donc les coûts avec des concurrents comme les agents vocaux Voxtral 3 de Mistral qu'une fois qu'ElevenLabs les aura publiés.
Sources
Articles liés
Mistral Voxtral 3 ajoute des agents vocaux dès 0,0035 dollar par minute
Voxtral 3 de Mistral ajoute la reconnaissance vocale dès 0,0035 dollar par minute, un modèle de voix à 13 dollars par million de caractères et une API d'agents vocaux dès 0,04 dollar par minute.
Le modèle Glimpse d'Elorian réexamine les images pendant qu'il raisonne
Glimpse, le premier modèle d'Elorian, coûte 0,60 $ par million de tokens en entrée et revient sur les images pendant qu'il raisonne. Il a battu GPT-6 Astra sur 4 tests sur 11.
xAI lance Grok Voice 3.0 à 0,08 $ la minute
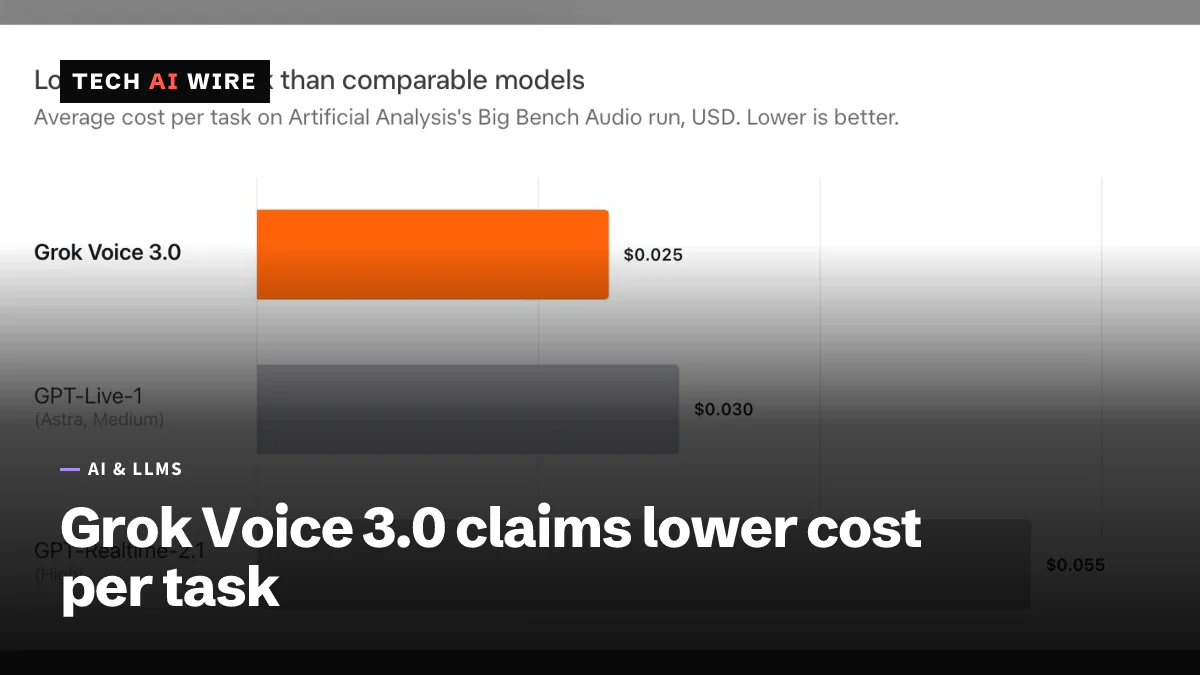
Le modèle vocal Grok Voice 3.0 de xAI coûte 0,08 $ la minute dans la Voice Agent API, comme la version 2.0. Il obtient 86,9 au Speech-to-Speech Index d'Artificial Analysis.