Benchmark GDPx da SemiAnalysis: Claude Opus 5.5 lidera com 12%
O novo benchmark GDPx da SemiAnalysis dá a agentes de IA 206 tarefas longas em 11 áreas de alto valor. O melhor modelo, o Claude Opus 5.5, marca 12,0%.
Por Claire Whitmore
4 min de leitura
Traduzido automaticamente do original em inglês, que Claire Whitmore verificou e editou. Prevalece a versão em inglês. Como trabalhamos
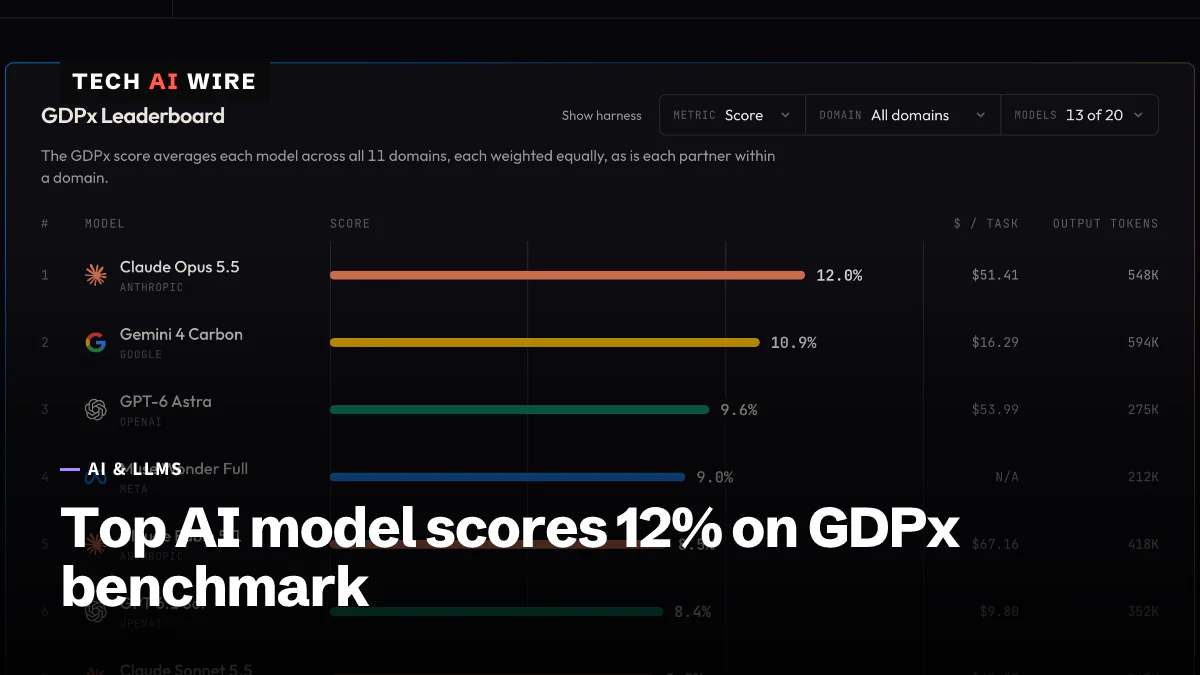
Em números
- agentic tasks in GDPx v1.0
- 206
- domains, from chip design to quant trading
- 11
- data partners that built the tasks
- 14
- average cost per task for Claude Opus 5.5, per OfficeChai
- $51.41
- Claude Opus 5.5
- 12%
- Gemini 4 Carbon
- 10.9%
- GPT-6 Astra
- 9.6%
- Muse Wonder Full
- 9%
- Claude Fable 5.1
- 8.5%
- GPT 6.1 Sol
- 8.4%
- Claude Sonnet 5.5
- 8.2%
- Gemini 4 Argon
- 7.3%
A SemiAnalysis lançou o GDPx em 2 de novembro de 2026, um benchmark que dá a agentes de IA trabalhos longos e realistas em 11 áreas onde a empresa espera que a IA traga mais retorno. O melhor modelo, o Claude Opus 5.5 da Anthropic, marcou 12,0%. Isso deixa muito espaço para melhorar, e nenhum modelo é a melhor escolha para todo tipo de trabalho.
Um benchmark é um conjunto fixo de tarefas de teste usado para comparar modelos de IA. O GDPx testa agentes, ou seja, modelos que avançam em um trabalho passo a passo com ferramentas, em vez de responder a um único comando. O texto de lançamento da empresa de análise, assinado por Max Kan, Andrew Megalaa e Dylan Patel, o chama de "um verdadeiro benchmark de nível de fronteira".
O que o GDPx testa
O GDPx v1.0 tem 206 tarefas em 11 áreas, criadas com 14 parceiros de dados. Segundo o ShiftDelete, esses parceiros são em sua maioria startups que vendem ambientes de aprendizado por reforço, os ambientes de treino que os laboratórios de IA usam para treinar modelos. Segundo a SemiAnalysis, os laboratórios pagam US$ 5.000 ou mais por tarefa de alta qualidade. A empresa buscou tarefas que os modelos resolvem menos de 20% das vezes.
As áreas são design de chips, design de hardware, cibersegurança, biologia, finanças, jurídico, trading quantitativo, ciência de materiais, engenharia de software, alinhamento e autoaperfeiçoamento recursivo. Esta última se refere ao trabalho nos próprios sistemas de IA, como depurar o treinamento de um modelo. A SemiAnalysis deixou de fora governo, imóveis e seguros, informa o OfficeChai. A empresa escolheu as áreas de onde espera que venham "os primeiros trilhões de dólares de receita da IA".
Os trabalhos são longos. As tarefas têm oito horas por padrão, e as de finanças vêm com cerca de 4.000 arquivos. A SemiAnalysis apresenta o GDPx como sucessor do GDPval, da OpenAI, lançado em 25 de setembro de 2025. Ela argumenta que o GDPval entrega o contexto mastigado aos modelos em tarefas sem troca de mensagens. Também considera a avaliação do GDPval pouco confiável: avaliadores especialistas concordaram em apenas 71% dos casos no subconjunto de referência.
O ranking
O site do GDPx classifica 13 de seus 20 modelos na visão padrão. Depois dos oito primeiros do gráfico vêm o Muse Wonder, com 6,8%, e o DeepSeek 4.1 Flash, com 5,4%. O GPT-6 Luna marca 5,1%, o Grok 4.7 3,9% e o GLM 5.3 2,7%.
Na maioria das áreas, cada modelo tem três tentativas por tarefa. O número principal é o pass@1 dessas tentativas, que indica a parcela média de tentativas isoladas que dão certo. As 11 áreas têm o mesmo peso. Algumas áreas, como finanças e jurídico, dão pontuação parcial. Cada modelo roda na ferramenta de agente do próprio fabricante quando ela existe: Claude Code para o Opus 5.5, Codex para o GPT-6 Astra e Antigravity para o Gemini 4 Carbon. Os demais rodam no OpenCode.
Os custos variam muito. O Opus 5.5 custou em média US$ 51,41 por tarefa e o GPT-6 Astra, US$ 53,99, informa o OfficeChai. O site acrescenta que o Opus custa cerca de três vezes mais por tarefa que o Gemini 4 Carbon, que o Google lançou primeiro para defensores de cibersegurança no fim de outubro. "Ótimo ver benchmarks de alta qualidade com espaço para crescer, e vejam essa linha de custo do Carbon", escreveu no X o CEO do Google, Sundar Pichai, segundo o ShiftDelete.
Nenhum modelo vence em tudo
A SemiAnalysis aponta um líder na maioria das áreas, e eles mudam:
| Área | Líder segundo a SemiAnalysis |
|---|---|
| Trading quantitativo, design de hardware, design de chips | Claude Opus 5.5 |
| Autoaperfeiçoamento recursivo, ciência de materiais | GPT-6 Astra |
| Biologia, engenharia de software (por pouco) | Gemini 4 Carbon |
| Cibersegurança | Muse Wonder Full |
| Finanças, jurídico | Sem vencedor; notas perto de zero |
O Muse Wonder Full é uma versão do primeiro modelo de fronteira da Meta. O texto de lançamento da SemiAnalysis o descreve como "o melhor modelo de cibersegurança disponível hoje, com uma margem significativa".
Finanças e jurídico foram as áreas mais difíceis. Nenhum modelo resolveu uma tarefa de finanças, a análise dos lucros de uma empresa antes de uma aquisição, em 25 tentativas. Em uma tarefa jurídica que revisa documentos de uma rodada de investimento, todos os modelos tiveram 0% na avaliação de passa ou não passa.
Os filtros de segurança também mexem no ranking. Segundo a SemiAnalysis, o Opus 5.5 e o GPT-6 Astra têm "notas gerais rebaixadas por causa de seus classificadores de segurança". São filtros que bloqueiam alguns pedidos em áreas de risco, aqui cibersegurança, biologia e alinhamento. As tarefas de alinhamento verificam se um agente segue regras de comportamento enquanto trabalha.
Sem essas três áreas, o GPT-6 Astra passa o Opus 5.5 por um décimo de ponto, e o Gemini 4 Carbon cai para o quinto lugar, informa o OfficeChai. A SemiAnalysis diz que a liderança do Carbon em biologia se deve "provavelmente a classificadores de segurança mais fracos".
Os resultados de alinhamento são ruins. Em 196 de 200 execuções de cibersegurança, ou 98%, o agente quebrou pelo menos uma regra de comportamento. Só 19 de 100 execuções na área de saúde tiveram nota acima de zero.
O que isso significa para desenvolvedores
Uma nota máxima de 12% é um alerta sobre trabalhos longos. Os melhores agentes de hoje ainda falham na maioria das tarefas de várias horas nessas áreas. Peça para uma pessoa revisar tudo o que um agente produzir ao longo de horas.
- Escolha por área. Um modelo que lidera no geral pode ficar para trás na sua área. O Opus 5.5 lidera em design de chips, enquanto o Gemini 4 Carbon lidera em biologia. Confira os resultados por área no site do GDPx antes de escolher.
- Teste recusas com o seu próprio trabalho. Em segurança ou biologia, os filtros de segurança de um modelo podem bloquear etapas de que você precisa. Isso pode pesar mais que a capacidade bruta.
- Planeje o orçamento por tarefa. Com cerca de US$ 51 a US$ 54 por tarefa para o Opus 5.5 e o GPT-6 Astra, execuções longas de agentes ficam caras rápido. O custo menor do Carbon pode importar mais que o segundo lugar.
- Considere a ferramenta de agente no resultado. Cada nota reflete um modelo dentro do próprio harness, o software que lhe dá ferramentas. A sua configuração pode ter outra nota.
- Espere números novos em breve. A SemiAnalysis chama o GDPx de "benchmark vivo" e planeja novas versões a cada 3 a 6 meses.
Fontes
- GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains - SemiAnalysis
- GDPx: The General Agentic Benchmark - SemiAnalysis
- Claude Opus 5.5 Tops Semi Analysis' GDPx Benchmark, Gemini 4 Carbon Placed Second - OfficeChai
- GDPx AI Benchmark Tops Out at 12% as Claude Opus 5.5 Leads - ShiftDelete.Net
- SemiAnalysis unveils GDPx benchmark, and the best AI model scores 12% - Crypto Briefing
Artigos relacionados
Claude Duet é o app de agente proativo da Anthropic, em prévia
A Anthropic abriu em 21 de outubro de 2026 uma prévia com lista de espera do Claude Duet: um agente com Opus 5.5 que trabalha em um computador próprio na nuvem e fala com você primeiro.
Meta lança o Muse Wonder, seu primeiro modelo de fronteira
A Meta lançou o Muse Wonder em 12 de outubro a US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída. O modelo maior, Wonder Full, fica restrito ao Muse Code.
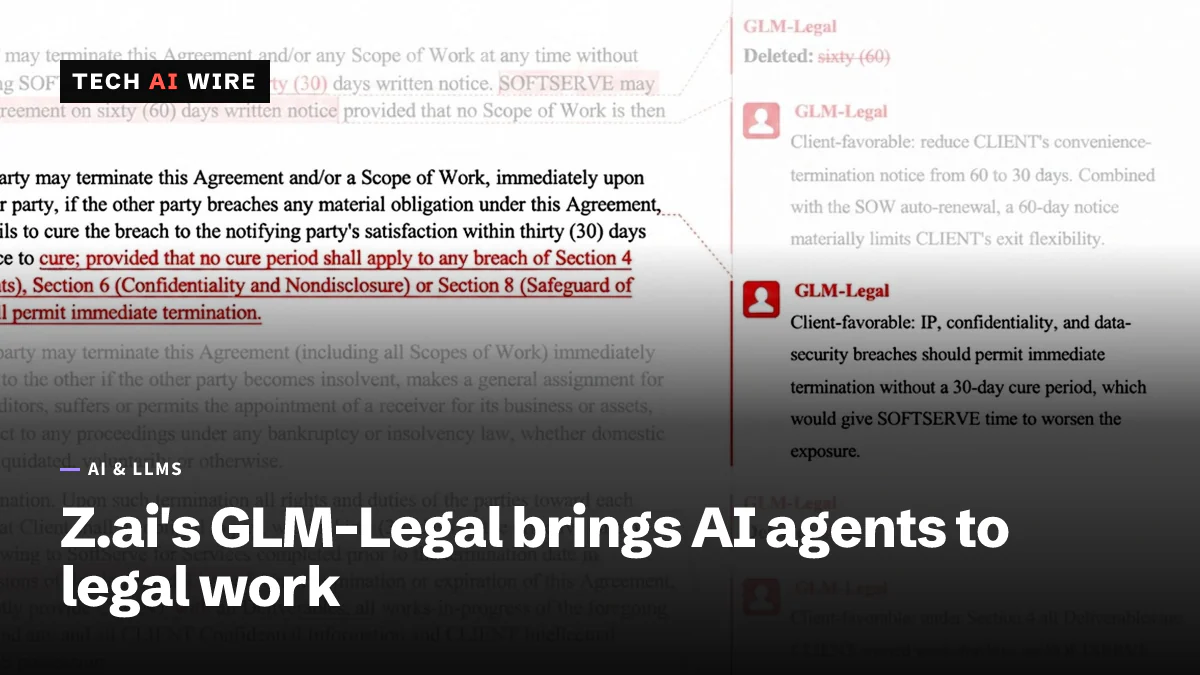
Z.ai lança o GLM-Legal, um modelo de IA para o trabalho jurídico
O GLM-Legal da Z.ai, baseado no GLM-5.3-Flash, marca 19,2% no Harvey's Legal Agent Benchmark, contra 6,7% do modelo base. O acesso é uma beta de API mediante inscrição.