ElevenLabs Eleven Realtime: Sprachagenten antworten in 570 ms
Eleven Realtime v1 Max von ElevenLabs antwortet laut dem Unternehmen in 570 ms und erreicht 98,8 % bei Big Bench Audio. Die API übernimmt das Realtime-Format von OpenAI.
4 Min. Lesezeit
Die Zahlen
- v1 Max time to first audio, per ElevenLabs
- 570 ms
- v1 Max score on Big Bench Audio
- 98.8%
- languages supported
- 90+
- Eleven Realtime v1 Max
- 98.8%
- Grok Voice 3.0
- 98.5%
- Gemini 3.8 Live Extended Thinking
- 97.7%
- Eleven Realtime v1 Mini
- 75.9%
ElevenLabs hat Eleven Realtime am 20. Oktober 2026 vorgestellt: zwei Sprachmodelle für den Bau von Sprachagenten, die in einem Schritt zuhören und antworten. Laut dem Unternehmen beginnt das größere, v1 Max, nach 570 Millisekunden zu antworten und liegt in einem gängigen Test für Sprach-Reasoning vorn. Für Entwickler ist die API womöglich die größere Neuigkeit. Sie übernimmt das Realtime-Format von OpenAI, sodass bestehender Code mit zwei Änderungen wechseln kann.
Ein Sprachagent ist Software, die ein gesprochenes Gespräch führt, etwa eine Support-Hotline, die Anrufe annimmt. Die meisten sind als Kette aufgebaut: Sprache zu Text, dann ein Sprachmodell, dann Text zu Sprache. Jedes Glied fügt Verzögerung hinzu. ElevenLabs vermarktet Eleven Realtime als Speech-to-Speech, das heißt, Audio geht in einen einzigen Dienst hinein und kommt als Audio wieder heraus.
Zwei Modelle: v1 Max und v1 Mini
Die Ankündigung von ElevenLabs teilt die Familie nach Aufgaben auf. Das kleinere v1 Mini ist für "natürliche Unterhaltungen zu niedrigen Kosten" gedacht, etwa einfache Chats, bei denen Tempo am meisten zählt. Das größere v1 Max ist für "komplexe Aufgaben und mehrstufige Workflows" gedacht, darunter Gespräche, in denen Tools genutzt werden.
Laut ElevenLabs hat das Analyseunternehmen Artificial Analysis beide Modelle unabhängig bewertet. Wer die Tool-Nutzung gemessen hat, nennt das Unternehmen nicht.
| Messgröße | v1 Max | v1 Mini |
|---|---|---|
| Zeit bis zum ersten Audio, laut ElevenLabs | 570 ms | 620 ms |
| Big Bench Audio (gesprochenes Reasoning) | 98,8 % | 75,9 % |
| Full-Duplex-Bench (Gesprächsfluss) | 94,1 % | 95,8 % |
| Speech Agent Arena (menschliche Präferenz) | 998 | 988 |
| Erledigte Aufgaben mit Tool-Nutzung | 87,1 % | 60,3 % |
Big Bench Audio stellt 1.000 gesprochene Fragen. Full-Duplex-Bench misst, wie natürlich ein Modell mit dem Sprecherwechsel umgeht, etwa mit Pausen und Unterbrechungen. Hier liegt Mini knapp vor Max, was zu seiner Rolle als Gesprächsmodell passt.
Die Latenzangaben widersprechen sich. Der Blog und die Produktseite von ElevenLabs nennen 570 ms für Max und 620 ms für Mini. Journal du Net, ein französisches Tech-Medium, berichtet von 470 ms und 500 ms, ohne eine Quelle zu nennen. Journal du Net führt auch Konkurrenten auf. Grok Voice 3.0 braucht 810 ms und erreicht 98,5 % beim Sprach-Reasoning, Gemini 3.8 Live Extended Thinking kommt auf 97,7 %. GPT-Realtime-2 (High) von OpenAI braucht 1,14 Sekunden.
Aufgebaut auf dem Realtime-Format von OpenAI
Die Realtime API folgt laut ElevenLabs der Realtime-Spezifikation von OpenAI. Um eine bestehende App umzuziehen, ändert man die Endpunkt-URL und den Modellnamen, und das SDK von OpenAI selbst funktioniert unverändert. Die Produktseite zeigt die Modell-ID eleven_realtime_v1_mini.
Es gibt Grenzen. Die API läuft nur über WebSocket, zum Start gibt es keine WebRTC-Version, daher müssen Browser-Apps auf WebRTC-Basis das Transportprotokoll wechseln. Telefonleitungen, WhatsApp, Contact Center, Wissensdatenbanken, Guardrails und Monitoring erfordern alle die separate Plattform ElevenAgents von ElevenLabs, nicht die reine API.
Tech Times ergänzt einen Vorbehalt zur Bauweise. ElevenLabs bestätigt, dass Eleven Realtime intern eine Kette von Komponenten ist, trotz der Bezeichnung Speech-to-Speech. Entwickler können diese Teile weder einsehen noch konfigurieren oder austauschen, und es gibt kein Texttranskript des Zwischenschritts.
Preise und Compliance sind nicht geklärt
ElevenLabs hat keine Preise für die Modelle veröffentlicht. Die Realtime API wird pro Minute verbundenen Audios plus Tokens abgerechnet, mit denselben Tokenpreisen in jedem Tarif. ElevenAgents nutzt die üblichen Minutenpreise plus die Kosten des Sprachmodells. Laut Journal du Net wurde der Preis pro Token zum Start nicht bekannt gegeben.
Auch bei der Compliance unterscheiden sich die Quellen. Die Produktseite nennt für die Plattform HIPAA-Konformität und einen Zero Retention Mode. Tech Times berichtet, dass v1 Mini keins von beidem bietet. Laut dem Medium unterstützt v1 Max beides nur mit Datenresidenz in den USA oder der EU, nicht in Indien oder Singapur.
Beide Modelle sprechen mehr als 90 Sprachen. Die Nutzung von Sprachagenten wächst schnell: ElevenAgents verarbeitete laut Tech Times 15 Millionen Gespräche pro Woche, dreimal so viele wie im Februar 2026. Dieses Wachstum ist ein Grund, warum das Unternehmen seine Bewertung diesen Monat auf 22 Milliarden Dollar verdoppelt hat.
Was das für Entwickler bedeutet
Die OpenAI-kompatible API macht einen Test günstig. Wenn Sie die Realtime API von OpenAI bereits über WebSocket nutzen, richten Sie einen Branch auf ElevenLabs aus und vergleichen Sie mit Ihren eigenen Gesprächen.
- Wählen Sie das Modell nach Aufgabe. Max für Agenten, die Tools aufrufen oder Schritten folgen; Mini für einfache, gesprächige Unterhaltungen.
- Messen Sie die Latenz selbst. Zwei Zahlenreihen kursieren, 570 ms und 470 ms für Max. Messen Sie die Zeit bis zum ersten Audio in Ihrem eigenen Netzwerk und Ihrer eigenen Region.
- Prüfen Sie, was Ihnen ohne Transkript fehlt. Wenn Sie Gespräche protokollieren, Antworten prüfen oder Kontrollen auf den Text zwischen den Schritten laufen lassen, bietet Ihnen diese Bauweise nichts davon.
- Klären Sie die Compliance je Modell und Region. Teams im Gesundheitswesen und in regulierten Branchen sollten sich die Bedingungen zu HIPAA und Datenresidenz schriftlich geben lassen, bevor sie auf Mini aufbauen.
- Warten Sie die Preise ab, bevor Sie sich festlegen. Es sind noch keine Minuten- oder Tokenpreise veröffentlicht. Vergleichen Sie die Kosten mit Konkurrenten wie den Voxtral-3-Sprachagenten von Mistral daher erst, wenn ElevenLabs sie bekannt gibt.
Quellen
Ähnliche Artikel
Mistral Voxtral 3 bringt Sprachagenten ab 0,0035 US-Dollar pro Minute
Mistrals Voxtral 3 bringt Speech-to-Text ab 0,0035 US-Dollar pro Minute, ein Stimmmodell für 13 US-Dollar pro Million Zeichen und eine Voice-Agent-API ab 0,04 US-Dollar pro Minute.
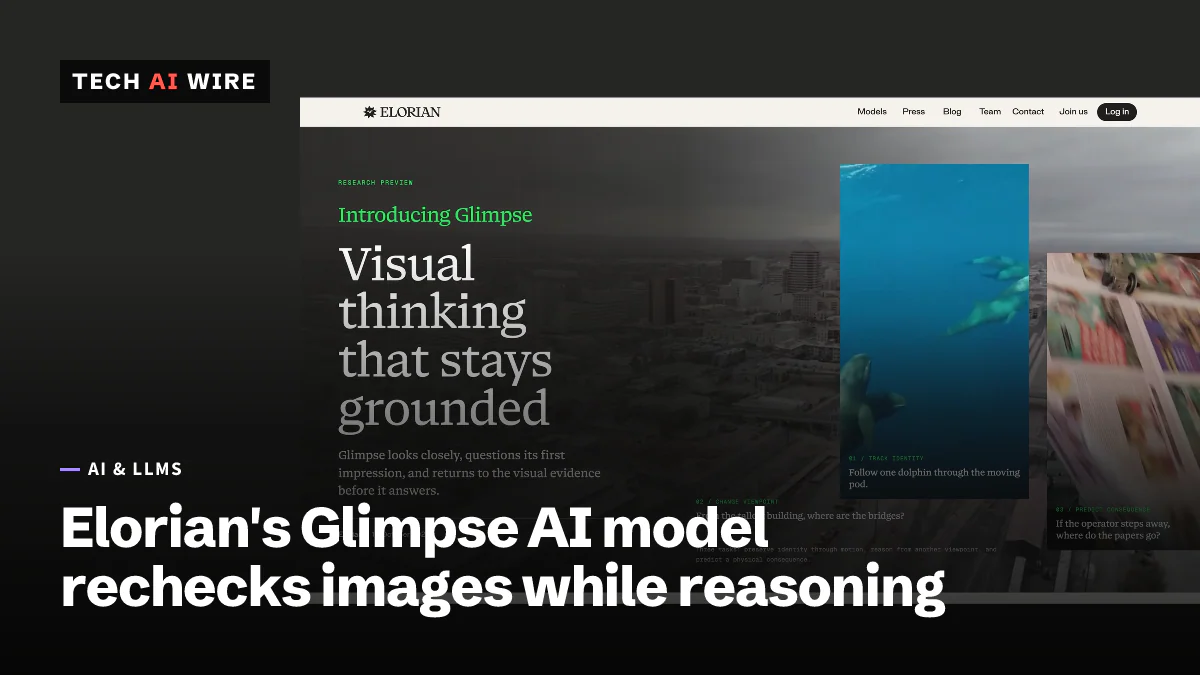
Elorian-Modell Glimpse prüft Bilder erneut, während es schlussfolgert
Elorians erstes Modell, Glimpse, kostet 0,60 $ pro Million Eingabe-Token und schaut beim Schlussfolgern erneut auf Bilder. Es schlug GPT-6 Astra in 4 von 11 Tests.
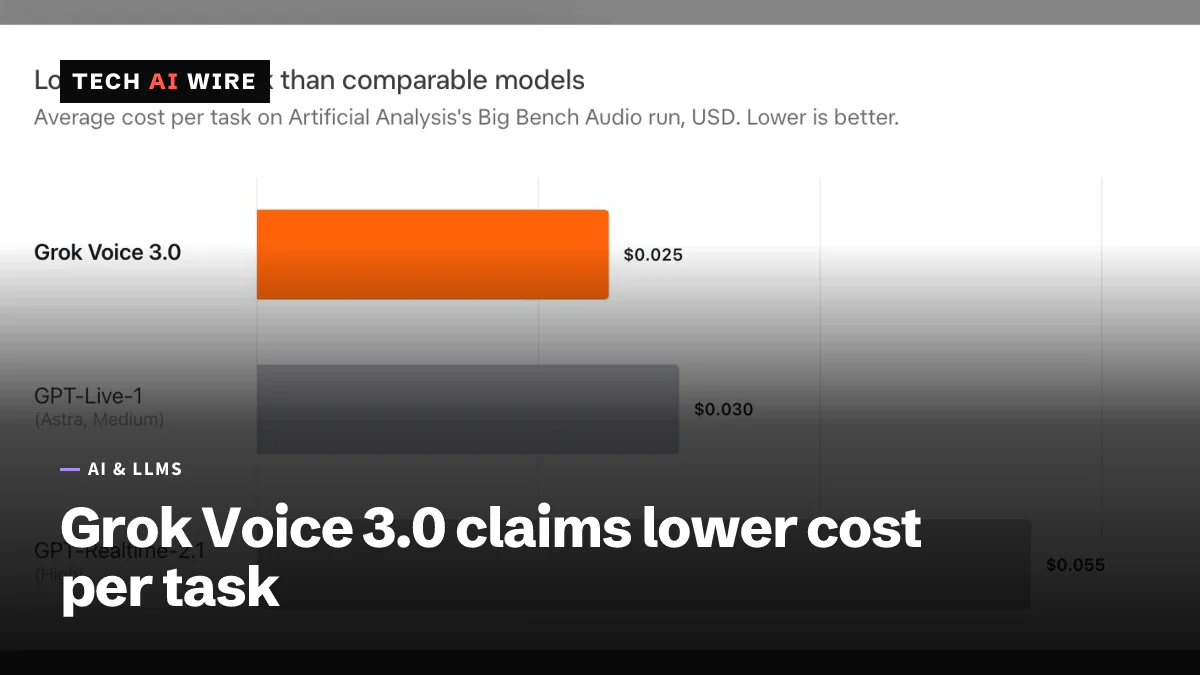
xAI Grok Voice 3.0 startet für 0,08 $ pro Minute
Das Sprachmodell Grok Voice 3.0 von xAI kostet in der Voice Agent API 0,08 $ pro Minute, so viel wie Version 2.0. Im Speech-to-Speech-Index von Artificial Analysis erreicht es 86,9 Punkte.