ElevenLabs Eleven Realtime: agentes de voz que responden en 570 ms
Eleven Realtime v1 Max de ElevenLabs responde en 570 ms y logra un 98,8 % en Big Bench Audio, según la empresa. Su API copia el formato Realtime de OpenAI.
4 min de lectura
En cifras
- v1 Max time to first audio, per ElevenLabs
- 570 ms
- v1 Max score on Big Bench Audio
- 98.8%
- languages supported
- 90+
- Eleven Realtime v1 Max
- 98.8%
- Grok Voice 3.0
- 98.5%
- Gemini 3.8 Live Extended Thinking
- 97.7%
- Eleven Realtime v1 Mini
- 75.9%
ElevenLabs lanzó Eleven Realtime el 20 de octubre de 2026: dos modelos de voz que escuchan y responden en un solo paso, pensados para crear agentes de voz. Según la empresa, el más grande, v1 Max, empieza a responder en 570 milisegundos y lidera una prueba estándar de razonamiento por voz. Para los desarrolladores, la noticia más importante quizá sea la API. Copia el formato Realtime de OpenAI, así que el código existente puede cambiarse con dos modificaciones.
Un agente de voz es un software que mantiene una conversación hablada, como una línea de soporte que atiende llamadas. La mayoría se construyen como una cadena: voz a texto, luego un modelo de lenguaje y luego texto a voz. Cada eslabón añade retraso. ElevenLabs vende Eleven Realtime como speech-to-speech, es decir, el audio entra en un único servicio y de él sale audio.
Dos modelos: v1 Max y v1 Mini
El anuncio de ElevenLabs divide la familia por tarea. El pequeño, v1 Mini, está pensado para una "conversación natural a bajo coste", como chats sencillos donde la velocidad es lo que más importa. El grande, v1 Max, está pensado para "tareas complejas y flujos de trabajo de varios pasos", incluidas llamadas que usan herramientas.
ElevenLabs dice que la firma de análisis Artificial Analysis evaluó ambos modelos de forma independiente. No dice quién midió el uso de herramientas.
| Medida | v1 Max | v1 Mini |
|---|---|---|
| Tiempo hasta el primer audio, según ElevenLabs | 570 ms | 620 ms |
| Big Bench Audio (razonamiento hablado) | 98,8 % | 75,9 % |
| Full-Duplex-Bench (fluidez de la conversación) | 94,1 % | 95,8 % |
| Speech Agent Arena (preferencia humana) | 998 | 988 |
| Tareas con herramientas completadas | 87,1 % | 60,3 % |
Big Bench Audio plantea 1.000 preguntas habladas. Full-Duplex-Bench mide con qué naturalidad gestiona un modelo los turnos de palabra, como pausas e interrupciones. En esa prueba Mini supera por poco a Max, lo que encaja con su papel de modelo conversacional.
Las cifras de latencia no coinciden. El blog y la página de producto de ElevenLabs dan 570 ms para Max y 620 ms para Mini. Journal du Net, un medio tecnológico francés, informa de 470 ms y 500 ms sin citar una fuente. Journal du Net también enumera rivales. Grok Voice 3.0 tarda 810 ms y logra un 98,5 % en razonamiento por voz, y Gemini 3.8 Live Extended Thinking logra un 97,7 %. GPT-Realtime-2 (High) de OpenAI tarda 1,14 segundos.
Basado en el formato Realtime de OpenAI
Según ElevenLabs, la Realtime API sigue la especificación Realtime de OpenAI. Para migrar una app existente basta con cambiar la URL del endpoint y el nombre del modelo, y el propio SDK de OpenAI funciona sin cambios. La página de producto muestra el ID de modelo eleven_realtime_v1_mini.
Hay límites. La API funciona solo sobre WebSocket, sin versión WebRTC en el lanzamiento, así que las apps de navegador basadas en WebRTC deben cambiar de transporte. Las líneas telefónicas, WhatsApp, los centros de contacto, las bases de conocimiento, las barreras de seguridad y la monitorización requieren ElevenAgents, la plataforma independiente de ElevenLabs, y no la API sola.
Tech Times añade una advertencia sobre el diseño. ElevenLabs confirma que Eleven Realtime es por dentro una cadena de componentes, pese a la etiqueta speech-to-speech. Los desarrolladores no pueden inspeccionar, configurar ni sustituir esas piezas, y no hay transcripción de texto del paso intermedio.
Precios y cumplimiento normativo, sin cerrar
ElevenLabs no ha publicado precios para los modelos. La Realtime API se cobra por minuto de audio conectado más tokens, con los mismos precios por token en todos los planes. ElevenAgents usa su precio estándar por minuto más el coste del modelo de lenguaje. Journal du Net dice que el precio por token no se anunció en el lanzamiento.
El cumplimiento normativo también varía según la fuente. La página de producto indica cumplimiento de HIPAA y un Zero Retention Mode para la plataforma. Tech Times informa de que v1 Mini no tiene ninguno de los dos. Según el medio, v1 Max solo admite ambos con residencia de datos en EE. UU. o la UE, no en India ni en Singapur.
Ambos modelos hablan más de 90 idiomas. El uso de agentes de voz crece rápido: ElevenAgents gestionó 15 millones de conversaciones a la semana, el triple que en febrero de 2026, según Tech Times. Ese crecimiento es parte de la razón por la que la empresa duplicó su valoración hasta 22.000 millones de dólares este mes.
Qué significa esto para los desarrolladores
La API compatible con OpenAI hace que probar salga barato. Si ya usas la Realtime API de OpenAI sobre WebSocket, apunta una rama a ElevenLabs y compara con tus propias llamadas.
- Elige el modelo según la tarea. Max para agentes que llaman a herramientas o siguen pasos; Mini para conversaciones sencillas y distendidas.
- Mide tú mismo la latencia. Circulan dos juegos de cifras, 570 ms y 470 ms para Max. Cronometra el primer audio en tu propia red y región.
- Comprueba qué pierdes sin transcripción. Si registras llamadas, auditas respuestas o ejecutas controles sobre el texto entre pasos, este diseño no te da nada de eso.
- Confirma el cumplimiento por modelo y región. Los equipos sanitarios y de sectores regulados deberían obtener por escrito las condiciones de HIPAA y de residencia de datos antes de construir sobre Mini.
- Espera a los precios antes de comprometerte. No hay tarifas publicadas por minuto ni por token. Compara costes con rivales como los agentes de voz Voxtral 3 de Mistral solo cuando ElevenLabs las publique.
Fuentes
Artículos relacionados
Mistral Voxtral 3 suma agentes de voz desde 0,0035 dólares por minuto
Voxtral 3 de Mistral suma voz a texto desde 0,0035 dólares por minuto, un modelo de voz a 13 dólares por millón de caracteres y una API de agentes de voz desde 0,04 dólares por minuto.
El modelo Glimpse de Elorian vuelve a mirar las imágenes mientras razona
Glimpse, el primer modelo de Elorian, cuesta 0,60 dólares por millón de tokens de entrada y vuelve a mirar las imágenes mientras razona. Superó a GPT-6 Astra en 4 de 11 pruebas.
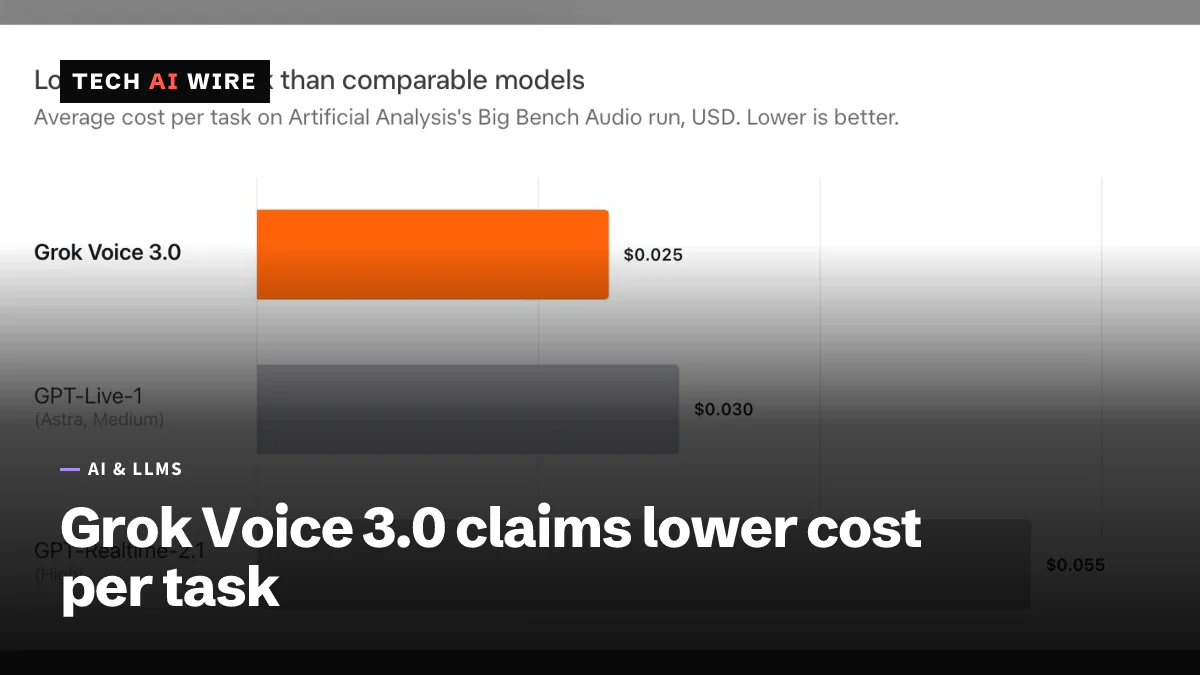
xAI lanza Grok Voice 3.0 a 0,08 dólares por minuto
El modelo de voz Grok Voice 3.0 de xAI cuesta 0,08 dólares por minuto en la Voice Agent API, igual que la versión 2.0, y logra 86,9 en el Speech-to-Speech Index de Artificial Analysis.