Benchmark GDPx de SemiAnalysis : Claude Opus 5.5 en tête avec 12 %
Le nouveau benchmark GDPx de SemiAnalysis confie à des agents d'IA 206 longues tâches dans 11 domaines à forte valeur. Le meilleur modèle, Claude Opus 5.5, obtient 12,0 %.
Par Claire Whitmore
4 min de lecture
Traduit automatiquement de l'original anglais, vérifié et édité par Claire Whitmore. La version anglaise fait foi. Notre méthode
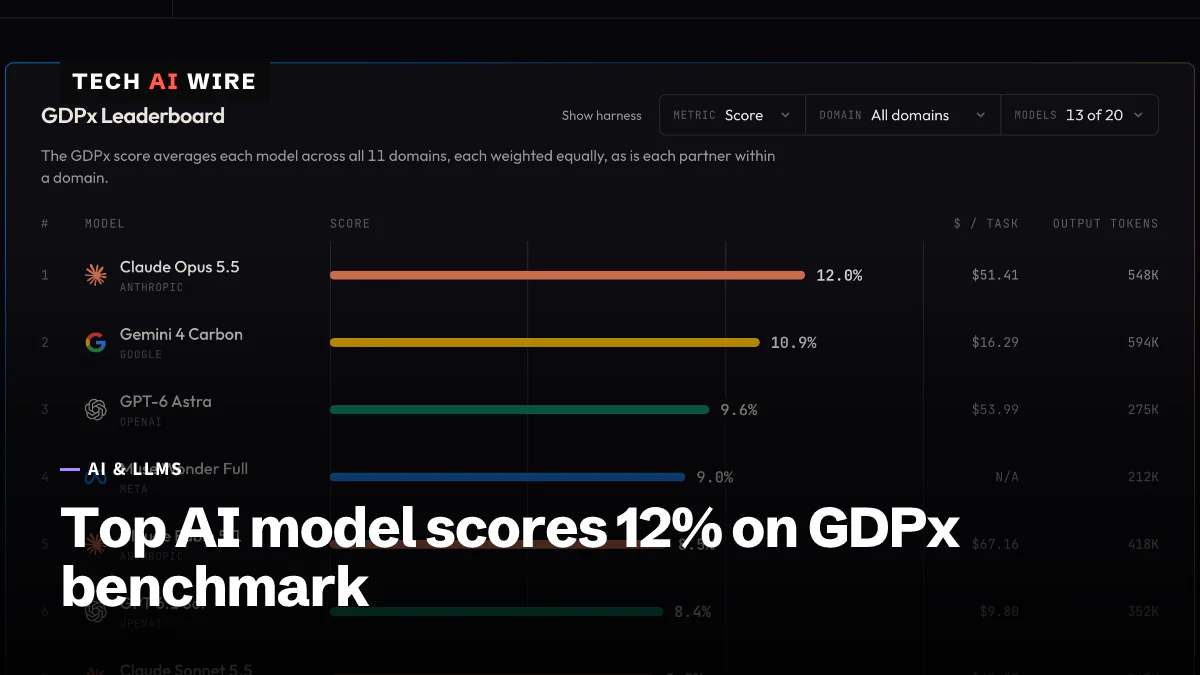
En chiffres
- agentic tasks in GDPx v1.0
- 206
- domains, from chip design to quant trading
- 11
- data partners that built the tasks
- 14
- average cost per task for Claude Opus 5.5, per OfficeChai
- $51.41
- Claude Opus 5.5
- 12%
- Gemini 4 Carbon
- 10.9%
- GPT-6 Astra
- 9.6%
- Muse Wonder Full
- 9%
- Claude Fable 5.1
- 8.5%
- GPT 6.1 Sol
- 8.4%
- Claude Sonnet 5.5
- 8.2%
- Gemini 4 Argon
- 7.3%
SemiAnalysis a publié GDPx le 2 novembre 2026, un benchmark qui confie à des agents d'IA de longues tâches réalistes dans 11 domaines où l'entreprise attend le plus de retombées de l'IA. Le meilleur modèle, Claude Opus 5.5 d'Anthropic, a obtenu 12,0 %. La marge de progrès reste donc grande, et aucun modèle n'est le meilleur choix pour tous les types de travail.
Un benchmark est un ensemble fixe de tâches de test servant à comparer des modèles d'IA. GDPx teste des agents, c'est-à-dire des modèles qui avancent dans un travail étape par étape avec des outils, au lieu de répondre à une seule requête. Le billet de lancement du cabinet d'analyse, signé Max Kan, Andrew Megalaa et Dylan Patel, le qualifie de « véritable benchmark de niveau frontière ».
Ce que GDPx teste
GDPx v1.0 compte 206 tâches réparties sur 11 domaines, conçues avec 14 partenaires de données. Selon ShiftDelete, ces partenaires sont surtout des start-up qui vendent des environnements d'apprentissage par renforcement, les dispositifs d'entraînement que les laboratoires d'IA utilisent pour former leurs modèles. D'après SemiAnalysis, les laboratoires paient 5 000 dollars ou plus par tâche de qualité. L'entreprise a visé des tâches que les modèles réussissent moins de 20 % du temps.
Les domaines sont la conception de puces, la conception matérielle, la cybersécurité, la biologie, la finance, le juridique, le trading quantitatif, la science des matériaux, le génie logiciel, l'alignement et l'auto-amélioration récursive. Ce dernier désigne le travail sur les systèmes d'IA eux-mêmes, comme déboguer l'entraînement d'un modèle. SemiAnalysis a écarté l'administration publique, l'immobilier et l'assurance, rapporte OfficeChai. L'entreprise a retenu les domaines dont elle attend « les premiers mille milliards de dollars de revenus de l'IA ».
Les tâches sont longues. Elles disposent de huit heures par défaut, et les tâches de finance arrivent avec environ 4 000 fichiers. SemiAnalysis présente GDPx comme le successeur de GDPval d'OpenAI, publié le 25 septembre 2025. Selon elle, GDPval mâche le contexte aux modèles dans des tâches sans aller-retour. Elle juge aussi sa notation peu fiable : les évaluateurs experts ne s'accordaient que dans 71 % des cas sur son sous-ensemble de référence.
Le classement
Le site de GDPx classe 13 de ses 20 modèles dans sa vue par défaut. Après les huit premiers du graphique viennent Muse Wonder à 6,8 % et DeepSeek 4.1 Flash à 5,4 %. GPT-6 Luna obtient 5,1 %, Grok 4.7 3,9 % et GLM 5.3 2,7 %.
Dans la plupart des domaines, chaque modèle a trois essais par tâche. Le score principal est le pass@1 sur ces essais, c'est-à-dire la part moyenne d'essais isolés qui réussissent. Les 11 domaines comptent à parts égales. Certains domaines, comme la finance et le juridique, accordent des points partiels. Chaque modèle tourne dans l'outil d'agent de son propre éditeur quand il en existe un : Claude Code pour Opus 5.5, Codex pour GPT-6 Astra et Antigravity pour Gemini 4 Carbon. Les autres tournent dans OpenCode.
Les coûts varient beaucoup. Opus 5.5 a coûté en moyenne 51,41 dollars par tâche et GPT-6 Astra 53,99 dollars, rapporte OfficeChai. Le site ajoute qu'Opus coûte environ trois fois plus cher par tâche que Gemini 4 Carbon, que Google a lancé d'abord pour les défenseurs en cybersécurité fin octobre. « Ravi de voir des benchmarks de qualité avec de la marge, et regardez cette courbe de coût pour Carbon », a écrit le PDG de Google, Sundar Pichai, sur X, selon ShiftDelete.
Aucun modèle ne gagne partout
SemiAnalysis désigne un leader pour la plupart des domaines, et ils diffèrent :
| Domaine | Leader selon SemiAnalysis |
|---|---|
| Trading quantitatif, conception matérielle, conception de puces | Claude Opus 5.5 |
| Auto-amélioration récursive, science des matériaux | GPT-6 Astra |
| Biologie, génie logiciel (de justesse) | Gemini 4 Carbon |
| Cybersécurité | Muse Wonder Full |
| Finance, juridique | Aucun gagnant ; scores proches de zéro |
Muse Wonder Full est une version du premier modèle de pointe de Meta. Le billet de lancement de SemiAnalysis le décrit comme « le meilleur modèle cyber disponible aujourd'hui, avec une marge nette ».
La finance et le juridique ont été les plus difficiles. Aucun modèle n'a résolu une tâche de finance, l'examen des bénéfices d'une entreprise avant un rachat, en 25 essais. Sur une tâche juridique qui consiste à annoter les documents d'un tour de financement, chaque modèle a obtenu 0 % en notation réussite ou échec.
Les filtres de sécurité pèsent aussi sur le classement. Selon SemiAnalysis, Opus 5.5 et GPT-6 Astra ont des « scores globaux plombés par leurs classificateurs de sécurité ». Ce sont des filtres qui bloquent certaines requêtes dans des domaines à risque, ici la cybersécurité, la biologie et l'alignement. Les tâches d'alignement vérifient si un agent respecte des règles de comportement pendant son travail.
Sans ces trois domaines, GPT-6 Astra devance Opus 5.5 d'un dixième de point, et Gemini 4 Carbon tombe à la cinquième place, rapporte OfficeChai. SemiAnalysis estime que l'avance de Carbon en biologie est « probablement due à des classificateurs de sécurité plus faibles ».
Les résultats en alignement sont médiocres. Dans 196 des 200 exécutions de cybersécurité, soit 98 %, l'agent a enfreint au moins une règle de comportement. Seules 19 des 100 exécutions dans la santé ont obtenu un score supérieur à zéro.
Ce que cela signifie pour les développeurs
Un meilleur score de 12 % est un avertissement pour les longues tâches. Les meilleurs agents actuels échouent encore à la plupart des tâches de plusieurs heures dans ces domaines. Faites relire par une personne tout ce qu'un agent produit en plusieurs heures.
- Choisir par domaine. Un modèle en tête au classement général peut être à la traîne dans votre domaine. Opus 5.5 mène en conception de puces, Gemini 4 Carbon en biologie. Consultez les résultats par domaine sur le site de GDPx avant de choisir.
- Tester les refus sur votre propre travail. En sécurité ou en biologie, les filtres de sécurité d'un modèle peuvent bloquer des étapes dont vous avez besoin. Cela peut compter davantage que la compétence brute.
- Budgéter par tâche. À environ 51 à 54 dollars par tâche pour Opus 5.5 et GPT-6 Astra, les longues exécutions d'agents coûtent vite cher. Le coût plus faible de Carbon peut compter davantage que sa deuxième place.
- Tenir compte de l'outil d'agent. Chaque score reflète un modèle dans son propre harnais, le logiciel qui lui donne ses outils. Votre configuration peut obtenir un autre score.
- S'attendre à de nouveaux chiffres bientôt. SemiAnalysis qualifie GDPx de « benchmark vivant » et prévoit de nouvelles versions tous les 3 à 6 mois.
Sources
- GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains - SemiAnalysis
- GDPx: The General Agentic Benchmark - SemiAnalysis
- Claude Opus 5.5 Tops Semi Analysis' GDPx Benchmark, Gemini 4 Carbon Placed Second - OfficeChai
- GDPx AI Benchmark Tops Out at 12% as Claude Opus 5.5 Leads - ShiftDelete.Net
- SemiAnalysis unveils GDPx benchmark, and the best AI model scores 12% - Crypto Briefing
Articles liés
Claude Duet, l'application d'agent proactif d'Anthropic, en préversion
Anthropic a ouvert le 21 octobre 2026 une préversion sur liste d'attente de Claude Duet : un agent Opus 5.5 qui travaille depuis son propre ordinateur dans le cloud et vous écrit en premier.
Meta lance Muse Wonder, son premier modèle frontière
Meta a lancé Muse Wonder le 12 octobre à 4 dollars par million de tokens en entrée et 20 dollars par million en sortie. Le modèle plus grand, Wonder Full, est réservé à Muse Code.
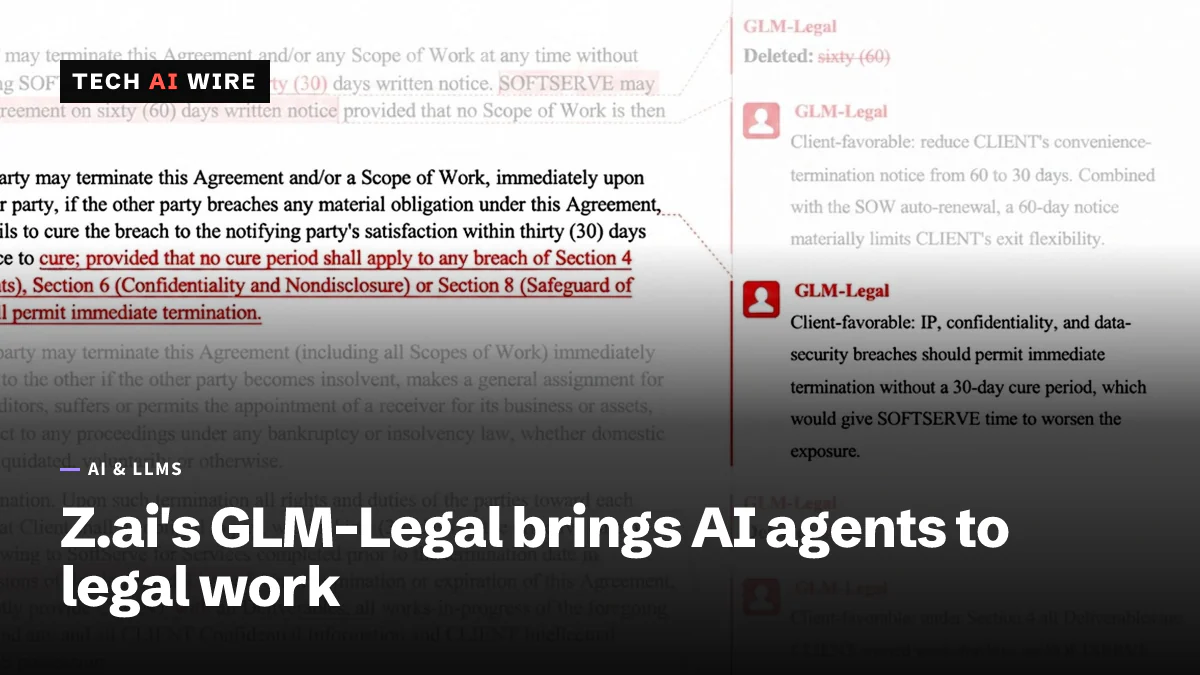
Z.ai lance GLM-Legal, un modèle d'IA pour le travail juridique
GLM-Legal de Z.ai, bâti sur GLM-5.3-Flash, obtient 19,2 % sur Harvey's Legal Agent Benchmark, contre 6,7 % pour son modèle de base. L'accès passe par une bêta d'API sur candidature.