Benchmark GDPx de SemiAnalysis: Claude Opus 5.5 lidera con un 12 %
El nuevo benchmark GDPx de SemiAnalysis pone a agentes de IA ante 206 tareas largas en 11 campos de alto valor. El mejor modelo, Claude Opus 5.5, logra un 12,0 %.
Por Claire Whitmore
4 min de lectura
Traducido automáticamente del original en inglés, que Claire Whitmore verificó y editó. Prevalece la versión en inglés. Cómo trabajamos
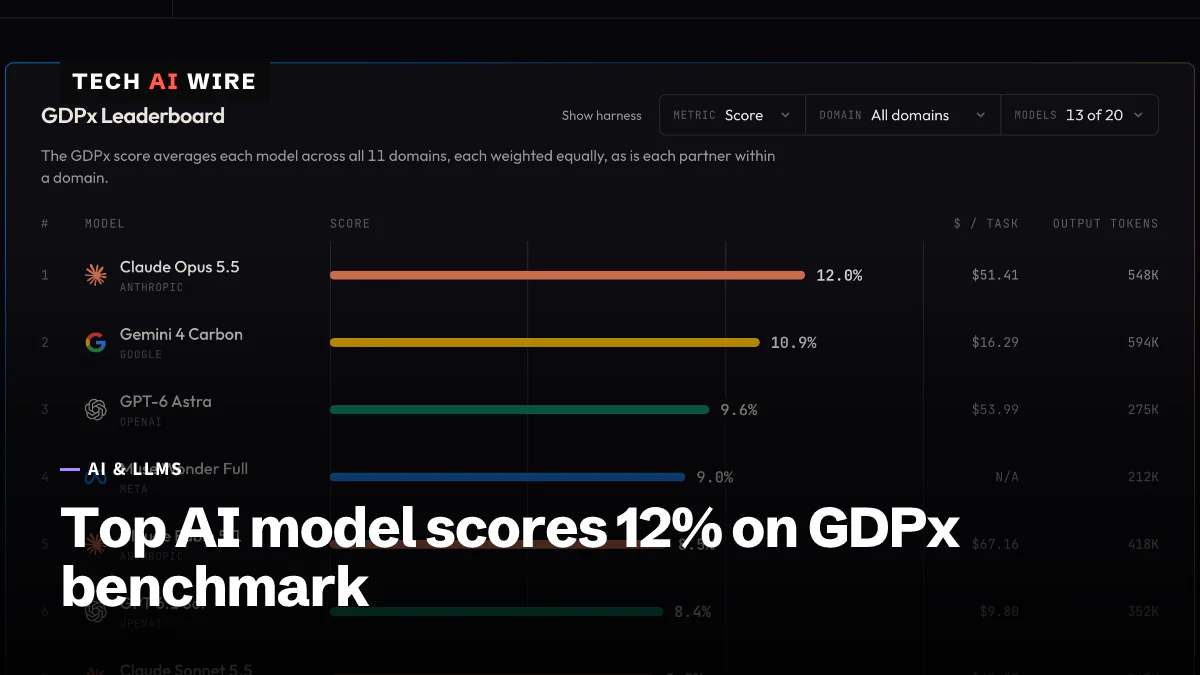
En cifras
- agentic tasks in GDPx v1.0
- 206
- domains, from chip design to quant trading
- 11
- data partners that built the tasks
- 14
- average cost per task for Claude Opus 5.5, per OfficeChai
- $51.41
- Claude Opus 5.5
- 12%
- Gemini 4 Carbon
- 10.9%
- GPT-6 Astra
- 9.6%
- Muse Wonder Full
- 9%
- Claude Fable 5.1
- 8.5%
- GPT 6.1 Sol
- 8.4%
- Claude Sonnet 5.5
- 8.2%
- Gemini 4 Argon
- 7.3%
SemiAnalysis publicó GDPx el 2 de noviembre de 2026, un benchmark que da a agentes de IA trabajos largos y realistas en 11 campos donde la empresa espera que la IA rinda más. El mejor modelo, Claude Opus 5.5 de Anthropic, obtuvo un 12,0 %. Eso deja mucho margen de mejora, y ningún modelo es la mejor opción para todo tipo de trabajo.
Un benchmark es un conjunto fijo de tareas de prueba que sirve para comparar modelos de IA. GDPx pone a prueba agentes, es decir, modelos que avanzan en un trabajo paso a paso con herramientas en lugar de responder a una sola instrucción. La publicación de lanzamiento de la firma de análisis, firmada por Max Kan, Andrew Megalaa y Dylan Patel, lo llama «un auténtico benchmark de nivel de frontera».
Qué pone a prueba GDPx
GDPx v1.0 tiene 206 tareas repartidas en 11 campos, creadas con 14 socios de datos. Según ShiftDelete, la mayoría de esos socios son startups que venden entornos de aprendizaje por refuerzo, los entornos de práctica que los laboratorios de IA usan para entrenar modelos. Según SemiAnalysis, los laboratorios pagan 5.000 dólares o más por cada tarea de calidad. La empresa buscó tareas que los modelos resuelven menos del 20 % de las veces.
Los campos son diseño de chips, diseño de hardware, ciberseguridad, biología, finanzas, trabajo legal, trading cuantitativo, ciencia de materiales, ingeniería de software, alineación y automejora recursiva. Este último se refiere al trabajo sobre los propios sistemas de IA, como depurar el entrenamiento de un modelo. SemiAnalysis dejó fuera la administración pública, el sector inmobiliario y los seguros, según OfficeChai. Eligió los campos de los que espera que salgan «los primeros billones de dólares de ingresos de la IA».
Los trabajos son largos. Las tareas tienen ocho horas por defecto, y las de finanzas incluyen unos 4.000 archivos. SemiAnalysis presenta GDPx como sucesor de GDPval, de OpenAI, publicado el 25 de septiembre de 2025. Sostiene que GDPval da el contexto masticado a los modelos en tareas sin ida y vuelta. También considera poco fiable su evaluación: los evaluadores expertos coincidieron solo en el 71 % de los casos en su subconjunto de referencia.
La clasificación
El sitio de GDPx clasifica 13 de sus 20 modelos en su vista predeterminada. Tras los ocho primeros del gráfico vienen Muse Wonder con un 6,8 % y DeepSeek 4.1 Flash con un 5,4 %. GPT-6 Luna obtiene un 5,1 %, Grok 4.7 un 3,9 % y GLM 5.3 un 2,7 %.
En la mayoría de los campos, cada modelo tiene tres intentos por tarea. La cifra principal es el pass@1 de esos intentos, que indica el porcentaje medio de intentos sueltos que salen bien. Los 11 campos cuentan lo mismo. Algunos campos, como finanzas y legal, dan puntuación parcial. Cada modelo funciona con la herramienta de agente de su propio fabricante cuando existe: Claude Code para Opus 5.5, Codex para GPT-6 Astra y Antigravity para Gemini 4 Carbon. El resto funciona en OpenCode.
Los costes varían mucho. Opus 5.5 costó de media 51,41 dólares por tarea y GPT-6 Astra 53,99 dólares, según OfficeChai. El medio añade que Opus cuesta unas tres veces más por tarea que Gemini 4 Carbon, que Google lanzó primero para defensores de ciberseguridad a finales de octubre. «Qué bien ver benchmarks de calidad con margen de mejora, y miren esa línea de costes de Carbon», escribió en X el consejero delegado de Google, Sundar Pichai, según ShiftDelete.
Ningún modelo gana en todo
SemiAnalysis nombra un líder en la mayoría de los campos, y no son los mismos:
| Campo | Líder según SemiAnalysis |
|---|---|
| Trading cuantitativo, diseño de hardware, diseño de chips | Claude Opus 5.5 |
| Automejora recursiva, ciencia de materiales | GPT-6 Astra |
| Biología, ingeniería de software (por poco) | Gemini 4 Carbon |
| Ciberseguridad | Muse Wonder Full |
| Finanzas, legal | Sin ganador; puntuaciones cercanas a cero |
Muse Wonder Full es una versión del primer modelo de frontera de Meta. La publicación de lanzamiento de SemiAnalysis lo describe como «el mejor modelo de ciberseguridad disponible hoy, con un margen notable».
Finanzas y legal fueron los más difíciles. Ningún modelo resolvió una tarea de finanzas, la revisión de los beneficios de una empresa antes de una compra, en 25 intentos. En una tarea legal que consiste en revisar los documentos de una ronda de financiación, todos los modelos sacaron un 0 % con evaluación de aprobado o suspenso.
Los filtros de seguridad también influyen en la clasificación. Según SemiAnalysis, Opus 5.5 y GPT-6 Astra tienen «puntuaciones generales lastradas por sus clasificadores de seguridad». Son filtros que bloquean algunas solicitudes en campos de riesgo, aquí ciberseguridad, biología y alineación. Las tareas de alineación comprueban si un agente respeta reglas de comportamiento mientras trabaja.
Sin esos tres campos, GPT-6 Astra supera a Opus 5.5 por una décima de punto, y Gemini 4 Carbon cae al quinto puesto, según OfficeChai. SemiAnalysis afirma que el liderazgo de Carbon en biología se debe «probablemente a unos clasificadores de seguridad más débiles».
Los resultados de alineación son malos. En 196 de 200 ejecuciones de ciberseguridad, un 98 %, el agente rompió al menos una regla de comportamiento. Solo 19 de 100 ejecuciones del ámbito sanitario puntuaron por encima de cero.
Qué significa esto para los desarrolladores
Una puntuación máxima del 12 % es una advertencia sobre los trabajos largos. Los mejores agentes actuales todavía fallan en la mayoría de las tareas de varias horas en estos campos. Haz que una persona revise todo lo que un agente produzca durante horas.
- Elige por campo. Un modelo que lidera en general puede quedarse atrás en tu campo. Opus 5.5 lidera el diseño de chips, mientras que Gemini 4 Carbon lidera la biología. Consulta los resultados por campo en el sitio de GDPx antes de elegir.
- Prueba los rechazos con tu propio trabajo. En seguridad o biología, los filtros de seguridad de un modelo pueden bloquear pasos que necesitas. Eso puede pesar más que la capacidad pura.
- Presupuesta por tarea. Con unos 51 a 54 dólares por tarea para Opus 5.5 y GPT-6 Astra, las ejecuciones largas de agentes se encarecen rápido. El menor coste de Carbon puede importar más que su segundo puesto.
- Ten en cuenta la herramienta de agente. Cada puntuación refleja un modelo dentro de su propio arnés, el software que le da herramientas. Tu configuración puede puntuar distinto.
- Espera cifras nuevas pronto. SemiAnalysis llama a GDPx un «benchmark vivo» y prevé nuevas versiones cada 3 a 6 meses.
Fuentes
- GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains - SemiAnalysis
- GDPx: The General Agentic Benchmark - SemiAnalysis
- Claude Opus 5.5 Tops Semi Analysis' GDPx Benchmark, Gemini 4 Carbon Placed Second - OfficeChai
- GDPx AI Benchmark Tops Out at 12% as Claude Opus 5.5 Leads - ShiftDelete.Net
- SemiAnalysis unveils GDPx benchmark, and the best AI model scores 12% - Crypto Briefing
Artículos relacionados
Claude Duet es la app de agente proactivo de Anthropic, en vista previa
Anthropic abrió el 21 de octubre de 2026 una vista previa con lista de espera de Claude Duet: un agente con Opus 5.5 que trabaja desde su propio ordenador en la nube y te escribe primero.
Meta lanza Muse Wonder, su primer modelo de frontera
Meta lanzó Muse Wonder el 12 de octubre a 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida. El modelo mayor, Wonder Full, queda reservado para Muse Code.
Z.ai lanza GLM-Legal, un modelo de IA para el trabajo jurídico
GLM-Legal de Z.ai, basado en GLM-5.3-Flash, obtiene un 19,2 % en Harvey's Legal Agent Benchmark, frente al 6,7 % de su modelo base. El acceso es una beta de API con solicitud previa.