Offene Gewichte von Mistral Large 4 jetzt auf Hugging Face
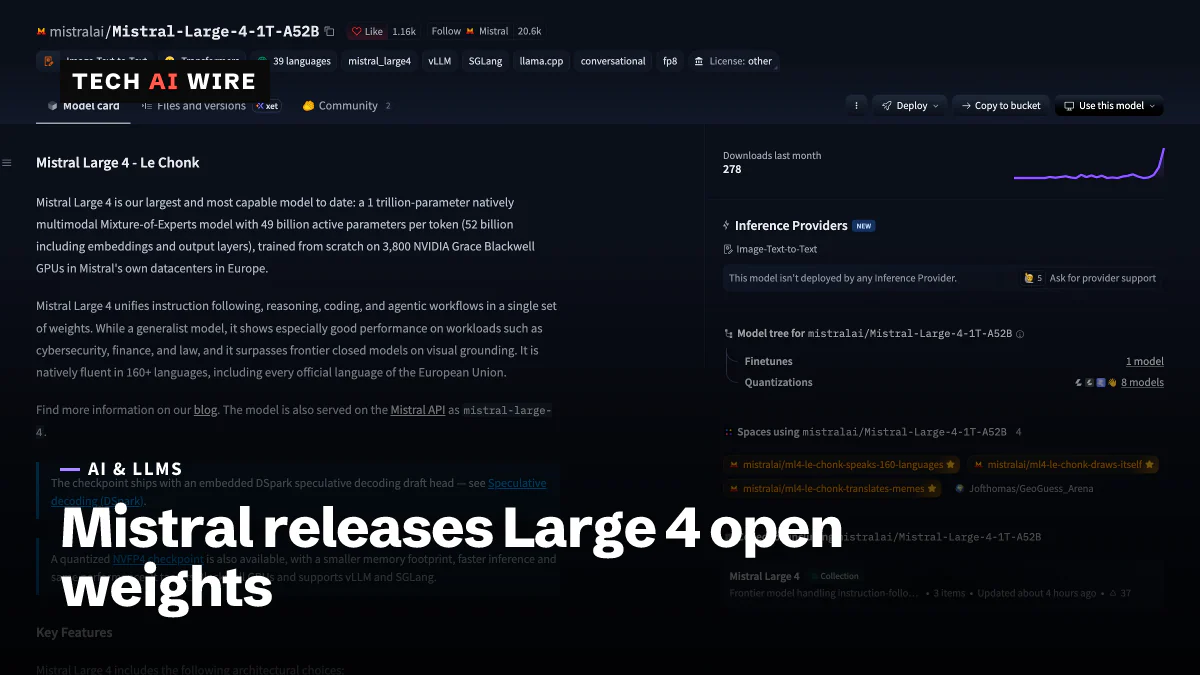
Die Gewichte von Mistral Large 4 sind seit dem 29. Oktober öffentlich: ein Download von 1.060,6 GB unter einer modifizierten MIT-Lizenz. Wer es als Dienst hostet, braucht einen separaten Vertrag.
5 Min. Lesezeit
Die Zahlen
- size of the bf16 weights, per OrcaRouter
- 1,060.6 GB
- Terminal-Bench 4.0 score, up from 28% in preview
- 41%
- token context window, per the model card
- 1M
- Nvidia B200 or B300 GPUs for the quantized build
- 4
- Mistral Large 4
- 41%
- GLM-5.3
- 40%
- DeepSeek V4.1 Flash
- 31%
- Large 4 preview
- 28%
- Kimi K3
- 21%
Mistral AI hat die offenen Gewichte von Mistral Large 4 am 29. Oktober 2026 auf Hugging Face veröffentlicht, rund drei Wochen nach der API-Vorschau des Modells. Jeder kann das Modell mit etwa 1 Billion Parametern jetzt herunterladen und auf eigenen Servern betreiben. Der Haken steckt in der Lizenz: Ein Unternehmen, das den Zugang als gehosteten Dienst verkauft, braucht einen separaten Vertrag mit Mistral.
Die Veröffentlichung folgt auf die öffentliche Vorschau am 6. Oktober, als Mistral ankündigte, die Gewichte würden später im Monat folgen. Sie kamen mit besseren Benchmark-Werten, zwei neuen Reasoning-Modi und einer Lizenz, die MIT nahekommt, aber nicht ganz.
Was Mistral veröffentlicht hat
Mistrals Ankündigung nennt das Modell „Le Chonk“. Es ist ein Mixture-of-Experts-Modell, kurz MoE. Diese Bauweise teilt das Netz in viele kleinere „Experten“-Teile auf und schickt jedes Token nur durch einige wenige davon. Das Modell ist also auf der Festplatte riesig, leistet pro Wort aber weit weniger Arbeit, als seine Größe vermuten lässt.
Die Modellkarte auf Hugging Face nennt die wichtigsten Daten:
| Angabe | Mistral Large 4 |
|---|---|
| Repository | mistralai/Mistral-Large-4-1T-A52B |
| Gesamtparameter | Etwa 1 Billion |
| Aktive Parameter pro Token | 49B, oder 52B mit Embedding- und Ausgabeschichten |
| Experten | 128 geroutete, 4 aktive, plus 1 gemeinsamer |
| Kontextfenster | 1M Token |
| Eingaben | Text und Bilder |
| Sprachen | 160+ |
Die Karte führt außerdem einen eingebauten DSpark-Draft-Head auf. Er ermöglicht spekulatives Decoding, einen Trick, bei dem ein kleiner, schneller Helfer die nächsten Token errät und das große Modell sie prüft. Laut Mistral erhöht das den Durchsatz nach eigenen Messungen um bis zum 1,9-Fachen.
OrcaRouter, ein Unternehmen für KI-Routing, hat das Repository am Tag der Veröffentlichung untersucht. Es zählte 54 Gewichtsdateien mit zusammen 1.060,6 GB in bf16, einem 16-Bit-Zahlenformat, und fand keine Zugangssperre. Ein zweites Repository enthält einen NVFP4-Build, der Nvidias 4-Bit-Format nutzt, mit 610,1 GB.
Was die Lizenz erlaubt
Die Gewichte stehen unter der Mistral Ecosystem Open-Weight License. Mistral beschreibt sie als modifizierte MIT-Lizenz, und MIT ist eine der freizügigsten Lizenzen in der Software. Nutzung, Änderungen, Fine-Tuning und kommerzielle Produkte sind alle erlaubt.
Die Änderung ist eine einzige Klausel. Ein Unternehmen, das „ein Model-as-a-Service-Geschäft betreibt“, muss vorher eine separate kommerzielle Lizenz von Mistral einholen, so OrcaRouters Lesart der Lizenzdatei. Gemeint ist, dass externe Kunden Prompts an das Modell senden und seine Eingaben oder Einstellungen steuern können.
Laut OrcaRouter fallen diese Nutzungen nicht unter die Klausel:
- Produkte, die das Modell in ihre eigenen Funktionen einbauen
- Dienste, die Anfragen nur an Modelle weiterleiten, die andere hosten
- Interne Nutzung ohne Zugang für Dritte
- Nutzung über Mistrals eigene Produkte
Benchmarks nach drei weiteren Wochen Training
Mistral hat die Zeit seit der Vorschau für weiteres Reinforcement Learning genutzt, eine Trainingsphase, die das Modell für gute Antworten belohnt. Laut The Next Web hob das seinen Wert auf Terminal-Bench 4.0 von 28 % auf 41 %. Terminal-Bench misst, wie gut ein Modell Aufgaben auf der Kommandozeile erledigt.
Mistral meldete für das veröffentlichte Modell diese weiteren Ergebnisse:
| Benchmark | Wert | Hinweis |
|---|---|---|
| Artificial Analysis Coding Agent Index | 48 % | 47 % weniger Token pro Aufgabe |
| Artificial Analysis Cyber Index | 51 % | Mistrals Angabe |
| CyberGym-E2E | 79 % | Gleichauf mit MiMo-V2.6-Pro, laut The Next Web |
| BrowseComp | 84,5 % | Mistrals Angabe |
| B3 Agent Security Benchmark | 97,1 % | Gestiegen von 93,3 % in der Vorschau |
Laut The Next Web liegt das Ergebnis beim Coding-Index gleichauf mit GLM-5.3, bei 47 % weniger Token pro Aufgabe. Weniger Token bedeuten niedrigere Rechnungen und schnellere Antworten für dieselbe Aufgabe. Mistral hat außerdem einen niedrigen und einen mittleren Reasoning-Modus ergänzt und sagt, der hohe Standardmodus sei jetzt 50 % effizienter.
Zur Sicherheit sagt Mistral, das Modell habe im Schnitt 96,6 % der bösartigen Cyber-Anfragen abgelehnt. Legitime defensive Sicherheitsarbeit erledige das Modell laut Mistral weiterhin.
Das sind Herstellerzahlen. OrcaRouter merkt an, dass noch kein Dritter die Benchmarks mit den veröffentlichten Dateien wiederholt hatte. Zudem habe Artificial Analysis seinen Intelligence Index am 27. Oktober auf eine neue Basis gestellt. Der neue v5-Wert des Modells von 26 ist daher nicht mit den 38,4 vergleichbar, die es in der Vorschau erreichte.
Preis und Hardware
Die Preise der gehosteten API widersprechen sich. Mistrals Ankündigung nennt 0,70 $ pro Million Eingabetoken, 0,07 $ für zwischengespeicherte Eingaben und 2,10 $ für die Ausgabe. Laut OrcaRouter sind das gerundete Aktionspreise von 0,68 $ und 2,09 $, gegenüber Listenpreisen von 1,36 $ und 4,18 $. The Next Web berichtete, die API-Preise seien noch nicht veröffentlicht.
Wer es selbst betreiben will, braucht einen Server, keine Workstation. Das vLLM-Beispiel der Modellkarte verteilt das Modell auf 8 GPUs. OrcaRouter setzt für den bf16-Build acht Beschleuniger mit je 141 GB Speicher an. Laut The Next Web läuft der quantisierte Build auf vier Nvidia-B200- oder -B300-GPUs.
Mistral trainierte das Modell auf 3.800 Nvidia-Grace-Blackwell-GPUs in Europa. Laut The Next Web zog das zusätzliche Training in Frankreich etwa 10 Megawatt. „Andere Labore haben Hunderte Milliarden eingesammelt, um gleichwertige Fähigkeiten zu entwickeln“, sagte CEO Arthur Mensch dem Medium.
Das Modell wird laut Mistral auch über OpenRouter, Nvidias Endpunkte und Microsoft Foundry angeboten. Zu den früheren offenen Modellen, mit denen es jetzt konkurriert, gehört Xiaomis MiMo-V2.6-Pro, das unter einer einfachen MIT-Lizenz erschien.
Was das für Entwickler bedeutet
- Lesen Sie Klausel 2, bevor Sie ein Produkt darauf aufbauen. Wenn Ihre Kunden eigene Prompts senden und Modelleinstellungen wählen, können Sie als Model-as-a-Service-Geschäft gelten. Fragen Sie Mistral vor dem Start, nicht danach.
- Rechnen Sie damit, dass Ihr Lizenzscanner anschlägt. Hugging Face kennzeichnet die Lizenz als „other“, nicht als MIT. Nehmen Sie sie bewusst in Ihre Freigabeliste auf, nach einer rechtlichen Prüfung.
- Planen Sie den Download wie eine Datenmigration. Mehr als ein Terabyte an Gewichten braucht schnellen Speicher und stundenlange Übertragung. Teams mit Blackwell-GPUs können mit dem NVFP4-Build mit 610,1 GB beginnen.
- Testen Sie zuerst über die gehostete API. Jeder Wert oben stammt vom Hersteller. Lassen Sie Ihre eigenen Coding- und Agent-Aufgaben über die API laufen, bevor Sie acht GPUs kaufen oder mieten.
- Zählen Sie Token ebenso wie Punktwerte. Wenn Sie pro Token zahlen, kann ein um 47 % geringerer Tokenverbrauch pro Aufgabe wichtiger sein als ein Punkt Vorsprung in einem Benchmark.
Laut The Next Web plant Mistral auch kleinere destillierte Versionen des Modells, hat aber noch keine Termine genannt.
Quellen
- Mistral Large 4 (Le Chonk) is now open weight - Mistral AI
- mistralai/Mistral-Large-4-1T-A52B - Hugging Face
- Mistral releases open weights for its 1 trillion-parameter Large 4 model - The Next Web
- Mistral Large 4 Open Weights: 1.06 TB, No Gate, One Catch - OrcaRouter
Ähnliche Artikel
Nvidia Nemotron 3.5 Transcribe: ein einziges offenes Spracherkennungsmodell
Nvidias Nemotron 3.5 Transcribe ist ein Open-Weight-Modell, das 40 Sprachen transkribiert, Sprecher kennzeichnet und übersetzt, trainiert mit 463.062 Stunden Audio.
Offene Gewichte von Reflection Beam erscheinen unter Apache 2.0
Reflection hat die Gewichte von Beam mit 501 Milliarden Parametern am 16. Oktober 2026 unter Apache 2.0 auf Hugging Face gestellt. Die FP8- und 4-Bit-Versionen passen auf einen Server mit 8 GPUs.
StepFun Step 5 Preview: 600B-Agentenmodell mit offenen Gewichten
Step 5 Preview von StepFun, ein Modell mit 600B Parametern, davon 27B aktiv, und 1M Token Kontext, ist auf Hugging Face. Zuvor gab es das Modell einen Monat nur per API, zu 1 $/2,70 $ pro Mio. Tokens.