Les poids ouverts de Mistral Large 4 arrivent sur Hugging Face
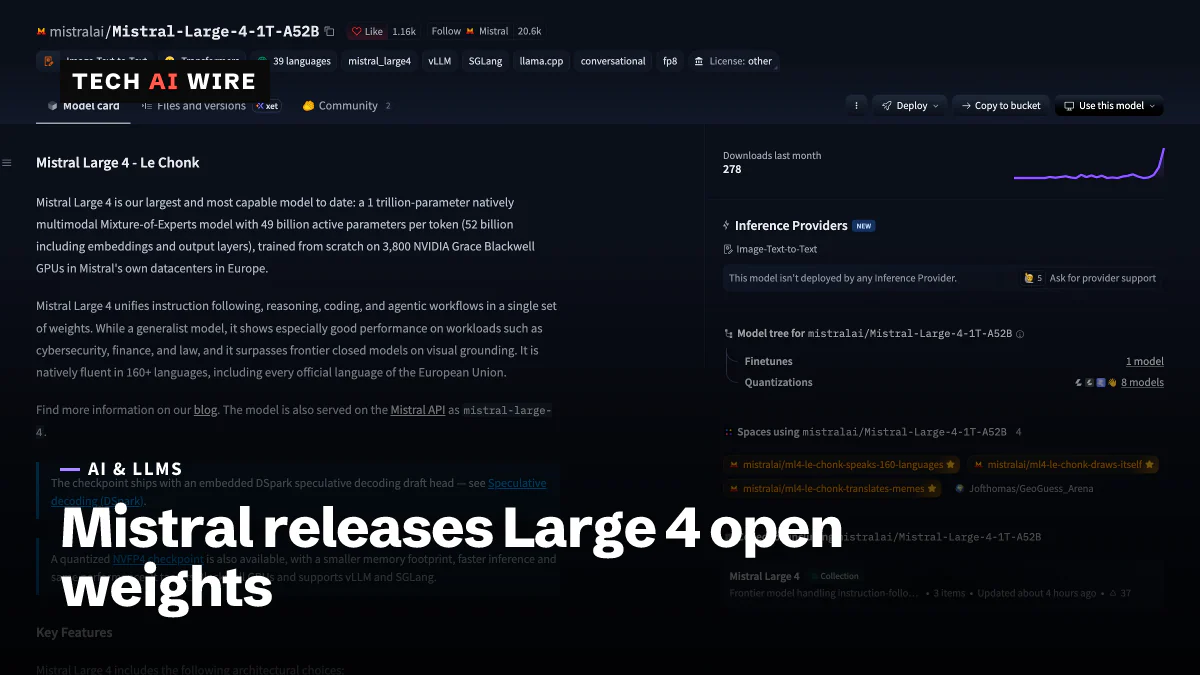
Les poids de Mistral Large 4 sont publics depuis le 29 octobre : un téléchargement de 1 060,6 Go sous une licence MIT modifiée. L'héberger comme service exige un accord séparé.
5 min de lecture
En chiffres
- size of the bf16 weights, per OrcaRouter
- 1,060.6 GB
- Terminal-Bench 4.0 score, up from 28% in preview
- 41%
- token context window, per the model card
- 1M
- Nvidia B200 or B300 GPUs for the quantized build
- 4
- Mistral Large 4
- 41%
- GLM-5.3
- 40%
- DeepSeek V4.1 Flash
- 31%
- Large 4 preview
- 28%
- Kimi K3
- 21%
Mistral AI a publié les poids ouverts de Mistral Large 4 sur Hugging Face le 29 octobre 2026, environ trois semaines après l'aperçu API du modèle. Tout le monde peut désormais télécharger ce modèle d'environ 1 billion de paramètres et l'exécuter sur ses propres serveurs. Le piège se trouve dans la licence : une entreprise qui vend l'accès au modèle sous forme de service hébergé doit conclure un accord séparé avec Mistral.
Cette publication fait suite à l'aperçu public du 6 octobre, quand Mistral avait annoncé que les poids viendraient plus tard dans le mois. Ils sont arrivés avec de meilleurs scores aux benchmarks, deux nouveaux modes de raisonnement et une licence proche de MIT, mais pas tout à fait.
Ce que Mistral a publié
L'annonce de Mistral appelle le modèle « Le Chonk ». C'est un modèle à mélange d'experts, ou MoE. Cette architecture découpe le réseau en de nombreuses petites parties « expertes » et ne fait passer chaque token que par quelques-unes d'entre elles. Le modèle est donc énorme sur disque, mais travaille bien moins par mot que sa taille ne le laisse penser.
La fiche du modèle sur Hugging Face en donne les principales caractéristiques :
| Caractéristique | Mistral Large 4 |
|---|---|
| Dépôt | mistralai/Mistral-Large-4-1T-A52B |
| Paramètres totaux | Environ 1 billion |
| Paramètres actifs par token | 49B, ou 52B avec les couches d'embedding et de sortie |
| Experts | 128 routés, 4 actifs, plus 1 partagé |
| Fenêtre de contexte | 1M de tokens |
| Entrées | Texte et images |
| Langues | 160+ |
La fiche mentionne aussi une tête de brouillon DSpark intégrée. Elle permet le décodage spéculatif, une astuce où un petit assistant rapide devine les prochains tokens et où le grand modèle les vérifie. Selon Mistral, cela augmente le débit jusqu'à 1,9 fois dans ses propres mesures.
OrcaRouter, une entreprise de routage d'IA, a examiné le dépôt le jour de la publication. Elle a compté 54 fichiers de poids totalisant 1 060,6 Go en bf16, un format numérique sur 16 bits, et n'a trouvé aucune restriction d'accès. Un second dépôt contient une version NVFP4, qui utilise le format 4 bits de Nvidia, de 610,1 Go.
Ce que permet la licence
Les poids sont distribués sous la Mistral Ecosystem Open-Weight License. Mistral la décrit comme une licence MIT modifiée, et MIT est l'une des licences les plus permissives du logiciel. L'utilisation, les modifications, le fine-tuning et les produits commerciaux sont tous autorisés.
La modification tient en une clause. Une entreprise qui « exploite une activité de Model as a Service » doit d'abord obtenir une licence commerciale séparée auprès de Mistral, selon la lecture du fichier de licence par OrcaRouter. Cela signifie permettre à des clients externes d'envoyer des prompts au modèle et de contrôler ses entrées ou ses réglages.
Selon OrcaRouter, ces usages ne relèvent pas de cette clause :
- Les produits qui intègrent le modèle dans leurs propres fonctionnalités
- Les services qui ne font que relayer des requêtes vers des modèles hébergés par d'autres
- L'usage interne sans accès pour des tiers
- L'usage via les propres produits de Mistral
Les benchmarks après trois semaines d'entraînement supplémentaires
Mistral a consacré le temps écoulé depuis l'aperçu à davantage d'apprentissage par renforcement, une étape d'entraînement qui récompense le modèle pour ses bonnes réponses. Selon The Next Web, cela a fait passer son score sur Terminal-Bench 4.0 de 28 % à 41 %. Terminal-Bench mesure la capacité d'un modèle à accomplir des tâches en ligne de commande.
Mistral a communiqué ces autres résultats pour le modèle publié :
| Benchmark | Score | Remarque |
|---|---|---|
| Artificial Analysis Coding Agent Index | 48 % | 47 % de tokens en moins par tâche |
| Artificial Analysis Cyber Index | 51 % | Chiffre de Mistral |
| CyberGym-E2E | 79 % | À égalité avec MiMo-V2.6-Pro, selon The Next Web |
| BrowseComp | 84,5 % | Chiffre de Mistral |
| B3 Agent Security Benchmark | 97,1 % | Contre 93,3 % dans l'aperçu |
Selon The Next Web, le résultat à l'indice de code égale celui de GLM-5.3 avec 47 % de tokens en moins par tâche. Moins de tokens, ce sont des factures plus basses et des réponses plus rapides pour le même travail. Mistral a aussi ajouté des modes de raisonnement faible et moyen, et affirme que le mode élevé par défaut est désormais 50 % plus efficace.
Côté sécurité, Mistral indique que le modèle a refusé en moyenne 96,6 % des requêtes cyber malveillantes. L'entreprise affirme que le modèle prend toujours en charge le travail légitime de sécurité défensive.
Ce sont des chiffres du fournisseur. OrcaRouter note qu'aucun tiers n'avait encore relancé les benchmarks sur les fichiers publiés. Il ajoute qu'Artificial Analysis a changé la base de son Intelligence Index le 27 octobre. Le nouveau score v5 du modèle, 26, n'est donc pas comparable au 38,4 obtenu pendant l'aperçu.
Prix et matériel
Les prix de l'API hébergée se contredisent. L'annonce de Mistral indique 0,70 $ par million de tokens d'entrée, 0,07 $ pour l'entrée en cache et 2,10 $ pour la sortie. OrcaRouter affirme qu'il s'agit de prix promotionnels arrondis de 0,68 $ et 2,09 $, face à des prix catalogue de 1,36 $ et 4,18 $. The Next Web a rapporté que les tarifs de l'API n'étaient pas encore publiés.
Pour l'exécuter soi-même, il faut un serveur, pas une station de travail. L'exemple vLLM de la fiche du modèle répartit le modèle sur 8 GPU. OrcaRouter place la version bf16 sur huit accélérateurs dotés chacun de 141 Go de mémoire. Selon The Next Web, la version quantifiée tourne sur quatre GPU Nvidia B200 ou B300.
Mistral a entraîné le modèle sur 3 800 GPU Nvidia Grace Blackwell en Europe. Selon The Next Web, l'entraînement supplémentaire a consommé environ 10 mégawatts en France. « D'autres laboratoires ont levé des centaines de milliards pour développer des capacités équivalentes », a déclaré le PDG Arthur Mensch au média.
Le modèle est aussi proposé via OpenRouter, les endpoints de Nvidia et Microsoft Foundry, selon Mistral. Parmi les modèles ouverts antérieurs avec lesquels il est désormais en concurrence figure MiMo-V2.6-Pro de Xiaomi, publié sous une licence MIT classique.
Ce que cela signifie pour les développeurs
- Lisez la clause 2 avant de bâtir un produit dessus. Si vos clients envoient leurs propres prompts et choisissent les réglages du modèle, vous pouvez être considéré comme une activité de Model as a Service. Interrogez Mistral avant le lancement, pas après.
- Attendez-vous à ce que votre scanner de licences le signale. Hugging Face étiquette la licence comme « other », et non MIT. Ajoutez-la à votre liste approuvée en connaissance de cause, après un examen juridique.
- Planifiez le téléchargement comme une migration de données. Plus d'un téraoctet de poids exige un stockage rapide et des heures de transfert. Les équipes équipées de GPU Blackwell peuvent commencer par la version NVFP4 de 610,1 Go.
- Testez d'abord sur l'API hébergée. Tous les scores ci-dessus sont déclarés par le fournisseur. Faites passer vos propres tâches de code et d'agent par l'API avant d'acheter ou de louer huit GPU.
- Comptez les tokens autant que les scores. Quand vous payez au token, une baisse de 47 % des tokens par tâche peut compter davantage qu'un point d'avance sur un benchmark.
Mistral prévoit aussi des versions distillées plus petites du modèle, selon The Next Web, mais n'a donné aucune date.
Sources
- Mistral Large 4 (Le Chonk) is now open weight - Mistral AI
- mistralai/Mistral-Large-4-1T-A52B - Hugging Face
- Mistral releases open weights for its 1 trillion-parameter Large 4 model - The Next Web
- Mistral Large 4 Open Weights: 1.06 TB, No Gate, One Catch - OrcaRouter
Articles liés
Nvidia Nemotron 3.5 Transcribe : un seul modèle vocal ouvert
Nemotron 3.5 Transcribe de Nvidia est un modèle à poids ouverts qui transcrit 40 langues, identifie les locuteurs et traduit, entraîné sur 463 062 heures d'audio.
Les poids ouverts de Reflection Beam arrivent sous Apache 2.0
Reflection a publié les poids de Beam, un modèle de 501 milliards de paramètres, sur Hugging Face le 16 octobre 2026, sous Apache 2.0. Les versions FP8 et 4 bits tiennent sur un seul serveur à 8 GPU.
StepFun Step 5 Preview : un modèle pour agents de 600B à poids ouverts
Step 5 Preview de StepFun, un modèle de 600B paramètres dont 27B actifs, avec un contexte de 1M de tokens, arrive sur Hugging Face après un mois limité à l'API, à 1 $/2,70 $ par million.