StepFun Step 5 Preview: 600B-Agentenmodell mit offenen Gewichten
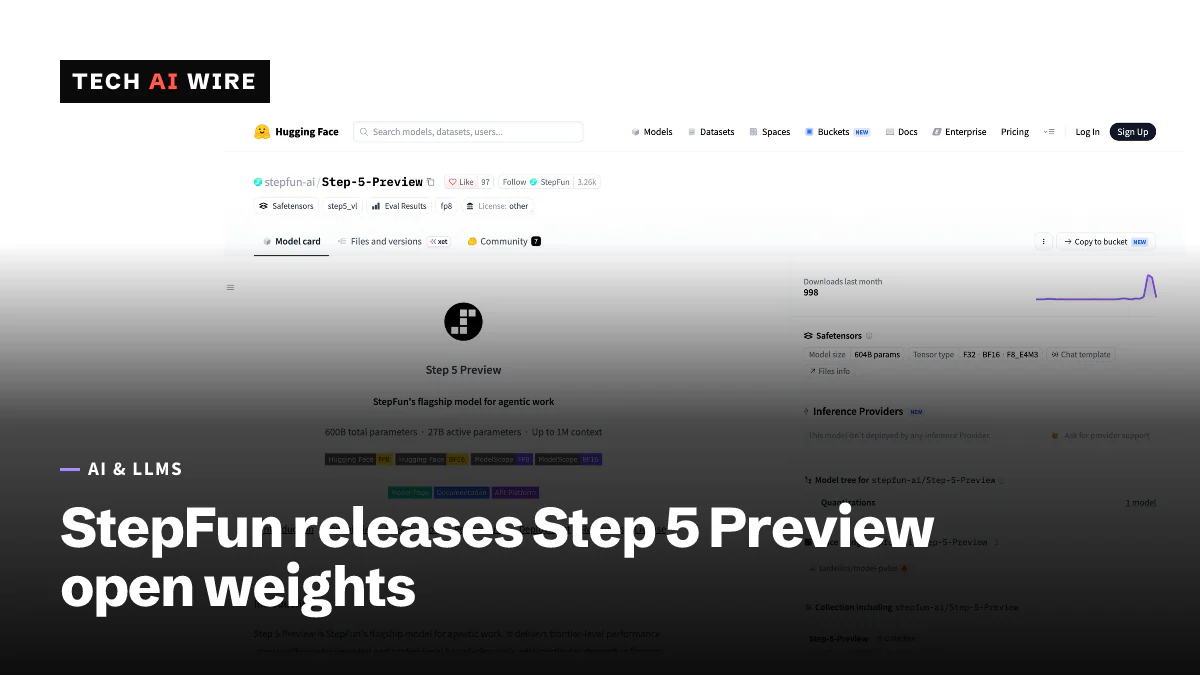
Step 5 Preview von StepFun, ein Modell mit 600B Parametern, davon 27B aktiv, und 1M Token Kontext, ist auf Hugging Face. Zuvor gab es das Modell einen Monat nur per API, zu 1 $/2,70 $ pro Mio. Tokens.
3 Min. Lesezeit
Die Zahlen
- total parameters, about 27B active per token
- 600B
- token context window
- 1M
- per million input tokens on OpenRouter
- $1.00
- H200 GPUs for the FP8 version on one node
- 8
- GPT-6 Astra (Max)
- 74.1%
- Claude Opus 5 (Max)
- 74%
- Step 5 Preview
- 67.7%
- Kimi K3 (Max)
- 67.5%
- GLM-5.3 (Max)
- 66.9%
Step 5 Preview von StepFun, ein Modell mit 600 Milliarden Parametern für KI-Agenten, hat jetzt seine Gewichte auf Hugging Face. StepFun hatte die Dateien für den 15. Oktober 2026 versprochen, nach einem Monat, in dem das Modell nur über seine API verfügbar war. Entwickler können nun ein großes, auf Coding ausgerichtetes Modell herunterladen und selbst betreiben. Allerdings braucht es einen Server voller Rechenzentrums-GPUs.
Gewichte sind die trainierten Zahlen, aus denen ein Modell besteht. „Offene Gewichte“ bedeutet, dass jeder sie herunterladen, das Modell lokal betreiben und feinabstimmen kann, im Rahmen der Lizenzbedingungen.
Was Step 5 Preview ist
Die Modellkarte auf Hugging Face nennt es „StepFuns Flaggschiffmodell für agentische Arbeit“. Es ist ein Sparse-Mixture-of-Experts-Modell (MoE). Ein MoE-Modell teilt seine Parameter auf viele kleinere Expertennetze auf und nutzt für jedes Wort nur wenige davon. Deshalb läuft es schneller, als seine Größe vermuten lässt.
| Merkmal | Step 5 Preview |
|---|---|
| Parameter insgesamt | 600B (604B in den Datei-Metadaten) |
| Aktiv pro Token | Etwa 27B |
| Kontextfenster | Bis zu 1M Tokens |
| Eingabe | Text und Bilder |
| Gewichtsformate | BF16 und FP8 |
| Lizenz | StepFun Model License 1.0 |
| Downloads | 998 im letzten Monat |
Die Karte beschreibt die Lizenz als „eine Lizenz im Stil von Apache 2.0“ mit zusätzlichen Bedingungen zur Namensnennung und zu kommerziellen Lizenzen. Das weicht von früheren Berichten ab. Im Oktober wies Developers Digest darauf hin, dass StepFuns Ankündigung keine Lizenz nannte und das Benchmarking-Unternehmen Artificial Analysis das Modell als proprietär führte.
Vom Platzhalter zum Download
StepFun kündigte das Modell am 20. September an, mit API-Zugang am selben Tag. An diesem Tag enthielt sein Hugging-Face-Repository für die BF16-Gewichte nur eine einzige Datei und keine Gewichte, berichtete OrcaRouter. „Das Repo ist ein Platzhalter, und genau das ist die Geschichte“, schrieb Gideon Frost, der Autor dieses Beitrags.
Das Modell kam am 8. Oktober zu OpenRouter, einem Dienst, der Zugang zu vielen KI-Modellen weiterverkauft. Einen Tag später schrieb Developers Digest, die Gewichte seien „für den 15. Oktober 2026 versprochen“. StepFuns GitHub-Repository für das Modell wurde am 15. Oktober aktualisiert. Die Modellkarte enthält jetzt Metadaten zu den Gewichtsformaten und einen Download-Zähler.
Benchmarks und Preis
StepFuns eigene Zahlen sehen das Modell bei Coding-Aufgaben nah an den besten geschlossenen Modellen, aber dahinter. Das Diagramm zeigt seinen Wert in DeepSWE v1.1 neben Konkurrenten in ihren „Max“-Einstellungen, aus der Tabelle, die Developers Digest wiedergab. StepFuns Ankündigung räumt ein, dass „ein deutlicher Abstand zur Spitze bleibt“.
Die Modellkarte nennt zusätzlich einen Wert von 33,3 in Terminal-Bench 4, einem Test für Kommandozeilenaufgaben. Im unabhängigen Artificial Analysis Intelligence Index erreicht es 44 Punkte. Laut OrcaRouter lag es am 18. September auf Platz 24 von 200 Modellen, laut Developers Digest bis zum 9. Oktober auf Platz 40 von 226.
Bei OpenRouter kostet es 1,00 $ pro Million Eingabe-Tokens und 2,70 $ pro Million Ausgabe-Tokens. Developers Digest nennt für zwischengespeicherte Eingaben 0,05 $. Artificial Analysis fand es außerdem „sehr wortreich“: Es erzeugte im Index 160 Millionen Ausgabe-Tokens, bei einem Median von 81 Millionen.
Was der Betrieb erfordert
Die Modellkarte nennt Beispielkonfigurationen. In FP8, einem komprimierten 8-Bit-Format, betreibt vLLM es auf vier B300-GPUs oder acht H200-GPUs in einem Server. In vollem BF16 braucht es acht B300 oder 16 H200 auf zwei Servern. vLLM und SGLang sind verbreitete Open-Source-Programme, um Modelle bereitzustellen.
Damit ist Self-Hosting für Laptops und einzelne Workstations außer Reichweite. Das Modell erscheint zwischen anderen sehr großen offenen Veröffentlichungen dieser Woche, darunter Metas Muse Spark Open mit 816B.
Was das für Entwickler bedeutet
- Vor der Auslieferung die Lizenz lesen. Die StepFun Model License 1.0 aus der Karte ergänzt eine Apache-artige Basis um Bedingungen zur Namensnennung und zu kommerziellen Lizenzen. Prüfen Sie, ob Ihr Produkt sie auslöst, bevor Sie darauf aufbauen.
- Mit der Ausgabe kalkulieren, nicht nur mit dem Preis. Mit 2,70 $ pro Million Ausgabe-Tokens ist der Tarif niedrig, aber das Modell schreibt viel. Messen Sie die echten Tokens pro Aufgabe in Ihrer eigenen Arbeitslast, nicht den Listenpreis.
- Die API testen, bevor Sie GPUs kaufen. Acht H200 sind die kleinste aufgeführte Serverkonfiguration. Testen Sie das Modell zuerst über OpenRouter und entscheiden Sie dann, ob Self-Hosting Geld spart.
- Herstellerwerte als Ausgangspunkt sehen. Die Zahlen zu DeepSWE und StepCodeBench stammen von StepFun. Lassen Sie es auf Ihren eigenen Repositories und Agentenaufgaben laufen, bevor Sie wechseln.
- Die empfohlenen Einstellungen nutzen. Die Karte empfiehlt temperature 1.0, top_p 0.95 und top_k 0, wobei die Ergebnisse mit der Reasoning-Einstellung „High“ angegeben sind. Andere Einstellungen erreichen die veröffentlichten Werte womöglich nicht.
Quellen
- stepfun-ai/Step-5-Preview model card - Hugging Face
- Step 5 Preview: Pricing, Benchmarks and the October 15 Open Weights - Developers Digest
- Step 5 Preview open weights - OrcaRouter
Ähnliche Artikel
Ling-3.1-flash: Ant Group öffnet 560B-Modell unter MIT-Lizenz
Ant Groups inclusionAI hat die Gewichte von Ling-3.1-flash unter der MIT-Lizenz veröffentlicht: 560B Parameter, davon 25B aktiv pro Token, und 1M Token Kontext.
Jais 3 bringt sechs offene arabische Modelle mit bis zu 375B
MBZUAIs IFM und Inception42 haben Jais 3 am 15. Oktober veröffentlicht: sechs offene arabische Modelle mit 0,9 bis 375 Milliarden Parametern, dazu Jais Speech, unter Apache 2.0.
Meta Muse Spark Open: 816B offene Gewichte veröffentlicht
Meta hat Muse Spark Open veröffentlicht, ein Modell mit offenen Gewichten, 816B Parametern, davon 42B aktiv, und 1M Token Kontext, auf Hugging Face und drei Cloud-Plattformen.