Offene Gewichte von Reflection Beam erscheinen unter Apache 2.0
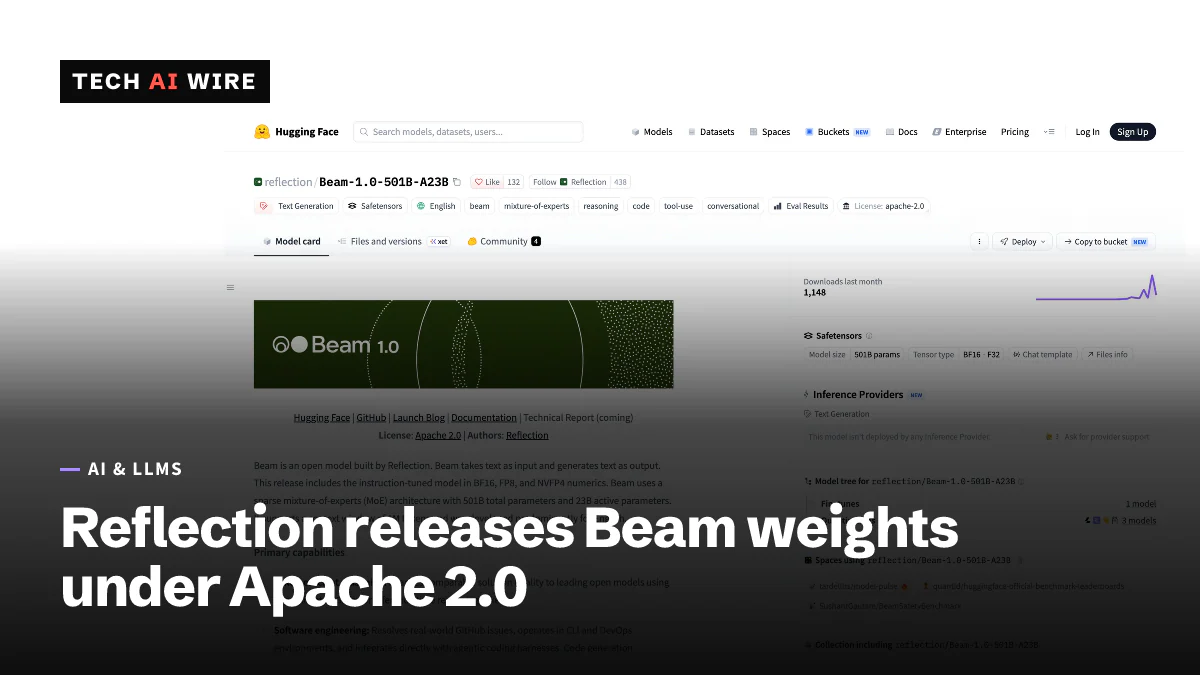
Reflection hat die Gewichte von Beam mit 501 Milliarden Parametern am 16. Oktober 2026 unter Apache 2.0 auf Hugging Face gestellt. Die FP8- und 4-Bit-Versionen passen auf einen Server mit 8 GPUs.
4 Min. Lesezeit
Die Zahlen
- total parameters, 23B active per token
- 501B
- token context window
- 1M
- enough for the FP8 and 4-bit versions
- 8 GPUs
- Terminal-Bench 2.1 score, BF16
- 80.1
- DeepSeek V4.1 Flash
- 90.6%
- Kimi K3
- 85%
- Reflection Beam
- 80.1%
- Muse Spark Open
- 76.4%
Reflection hat die Gewichte von Beam, seinem KI-Modell mit 501 Milliarden Parametern, am 16. Oktober 2026 auf Hugging Face veröffentlicht, unter der Lizenz Apache 2.0. Apache 2.0 erlaubt jedem, das Modell mit wenigen Auflagen zu nutzen, zu verändern und darauf aufbauende Produkte zu verkaufen. Damit ist Beam eines der größten Modelle, die ohne eigene Lizenzbedingungen verfügbar sind. Seine komprimierten Versionen passen auf einen einzigen Server mit acht GPUs.
Mit der Veröffentlichung hält Reflection das Versprechen, das es bei der Ankündigung von Beam am 5. Oktober gegeben hatte. Damals sollten die Gewichte „noch in diesem Monat“ erscheinen. „Beam ist unser erstes Open-Weight-Modell“, schrieb das Unternehmen in seinem Beitrag zur Veröffentlichung.
Was Reflection veröffentlicht hat
Beam ist ein Sparse-Mixture-of-Experts-Modell, kurz MoE. Seine Parameter sind auf viele kleinere Expertennetze aufgeteilt. Für jedes Token laufen nur einige davon. Ein Token ist ein Wort oder ein Teil eines Wortes. Die Model Card auf Hugging Face nennt die Details:
| Merkmal | Beam-1.0-501B-A23B |
|---|---|
| Parameter insgesamt | 501,3 Mrd. |
| Aktiv pro Token | 23,4 Mrd. |
| Experten und Schichten | 256 Experten, 52 Schichten |
| Kontextfenster | 1 Mio. Tokens |
| Eingabe | Nur Text, hauptsächlich Englisch |
| Gewichtsformate | BF16, FP8 und NVFP4 |
| Lizenz | Apache 2.0 |
Die Model Card beschreibt dies als das instruktionsoptimierte Modell, also die Version, die darauf trainiert ist, Anfragen zu befolgen. Reflection lieferte außerdem ein kleineres Draft-Modell für Speculative Decoding mit, einen Kniff, der die Textgenerierung beschleunigt. Dazu kamen Fused Kernels, fertige Einstellungen für mehrere Serving-Programme und ein Beam Safety Technical Report. Ein vollständiger technischer Bericht wird dort weiterhin als noch ausstehend geführt. Rezepte für Self-Distillation folgen „in den kommenden Tagen“, berichtet SiliconANGLE.
Reflection veröffentlichte außerdem Mirror CLI, einen Coding-Agenten, der in einem Terminal läuft, berichtet VentureBeat. Das Unternehmen nennt das gesamte Paket ein „offenes Betriebssystem für Agenten“.
Wie die komprimierten Versionen abschneiden
Quantisierung speichert die Zahlen eines Modells mit weniger Bits. Das senkt den Speicherbedarf, kostet aber etwas Genauigkeit. In Reflections eigenen Tests sind diese Kosten gering:
| Benchmark | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81,6 | 80,2 | 80,7 |
| SWE-Bench Pro v1 | 66,1 | 65,9 | 65,6 |
| Terminal-Bench 2.1 | 80,1 | 78,9 | 78,4 |
| GPQA Diamond | 90,6 | 90,3 | 89,3 |
| LiveCodeBench | 88,3 | 88,1 | 87,4 |
Die 8-Bit- und 4-Bit-Versionen passen auf einen Server mit acht GPUs vom Typ H100, H200 oder GB300, berichtet VentureBeat. Die vollständige 16-Bit-Version braucht „Dutzende GPUs“.
Im Vergleich mit der Konkurrenz liegt Beam nicht vorn. Das Diagramm zeigt die Werte für Terminal-Bench 2.1, die VentureBeat zusammengestellt hat. DeepSeeks V4.1 Flash führt mit 90,6, vor Beams 80,1. Beam schlägt Metas Muse Spark Open, das 76,4 erreichte.
Das Argument: weniger Tokens
Reflection setzt auf Effizienz, nicht auf reine Punktzahlen. Das Unternehmen behauptet, Beam erreiche beim anspruchsvollen logischen Schließen das Niveau von GLM-5.2. Dabei brauche es drei- bis viermal weniger Rechenleistung für die Inferenz, die Verarbeitung des Prompts nicht mitgerechnet. Das Modell ist darauf trainiert, mit weniger Reasoning-Tokens zu Antworten zu kommen.
„Man gibt nichts auf. Man bestraft es nur dafür, wie viele Tokens es verwenden kann“, sagte Ioannis Antonoglou, Mitgründer und CTO von Reflection, gegenüber VentureBeat. VentureBeat schätzt, dass Muse Spark Open pro Token etwa das 1,8-Fache der Rechenleistung von Beam braucht.
Reflection hat noch keinen Preis festgelegt. Die Beta seiner Plattform ist „zum Einstieg kostenlos“, sagt das Unternehmen. Es nennt mehr als 40 Launch-Partner. Dell und HPE werden Beam auf der eigenen Hardware von Kunden installieren.
Die Veröffentlichung folgt auf einen Bericht der Financial Times vom 10. Oktober, wonach Nvidia in frühen Gesprächen über eine Übernahme von Reflection oder eine weitere Investition steht. Antonoglou nannte das „haltlose Gerüchte“, ohne Gespräche zu bestätigen oder zu dementieren, berichtet VentureBeat. Er beschrieb Nvidia als „engen Partner und Investor“.
Was das für Entwickler bedeutet
- Mit FP8 oder NVFP4 beginnen. Reflections Zahlen zeigen die komprimierten Versionen innerhalb von etwa zwei Punkten der vollen Präzision. Sie passen auf einen Server mit acht GPUs statt auf einen Cluster aus mehreren Servern.
- Tokens pro Aufgabe zählen, nicht den Preis pro Token. Reflection behauptet, Beam komme mit weniger Tokens zu Antworten. Messen Sie die gesamten Tokens und die Zeit bei Ihren eigenen Aufgaben, um das zu prüfen. Denn genau dort zeigt sich eine Ersparnis, wenn es sie gibt.
- Die Lizenz ist der einfache Teil. Apache 2.0 enthält keine Umsatzgrenzen und keine eigenen Bedingungen. Die rechtliche Prüfung sollte kürzer ausfallen als bei Modellen unter eigenen Lizenzen, etwa der von Muse Spark Open.
- Die Werte als Herstellerangaben behandeln. Jeder Benchmark hier stammt von Reflection oder aus einer Model Card. Unabhängige Tests können jetzt beginnen, weil die Gewichte öffentlich sind.
- Auf die nächsten Schritte achten. Der vollständige technische Bericht und die Rezepte für Self-Distillation stehen noch aus. Das gilt auch für den Ausgang der berichteten Gespräche mit Nvidia. Sie könnten ändern, wer über die Roadmap des Modells bestimmt.
Quellen
- Beam is now available - Reflection
- reflection/Beam-1.0-501B-A23B model card - Hugging Face
- Reflection's Beam aims to undercut Chinese open models with fewer tokens, not cheaper tokens - VentureBeat
- Reflection AI open-sources Beam's weights, post-training recipes - SiliconANGLE
Ähnliche Artikel
StepFun Step 5 Preview: 600B-Agentenmodell mit offenen Gewichten
Step 5 Preview von StepFun, ein Modell mit 600B Parametern, davon 27B aktiv, und 1M Token Kontext, ist auf Hugging Face. Zuvor gab es das Modell einen Monat nur per API, zu 1 $/2,70 $ pro Mio. Tokens.
Reflection AI stellt Beam vor, ein Open-Weight-Modell mit 501 Milliarden Parametern
Beam von Reflection AI hat 501 Milliarden Parameter, nutzt aber 23 Milliarden pro Token, erreicht 80,9 bei SWE-Bench Verified, und die Gewichte erscheinen später im Oktober unter Apache 2.0.
Ling-3.1-flash: Ant Group öffnet 560B-Modell unter MIT-Lizenz
Ant Groups inclusionAI hat die Gewichte von Ling-3.1-flash unter der MIT-Lizenz veröffentlicht: 560B Parameter, davon 25B aktiv pro Token, und 1M Token Kontext.