Pesos abertos do Mistral Large 4 chegam ao Hugging Face
Os pesos do Mistral Large 4 ficaram públicos em 29 de outubro: um download de 1.060,6 GB sob uma licença MIT modificada. Hospedá-lo como serviço exige um acordo separado.
5 min de leitura
Em números
- size of the bf16 weights, per OrcaRouter
- 1,060.6 GB
- Terminal-Bench 4.0 score, up from 28% in preview
- 41%
- token context window, per the model card
- 1M
- Nvidia B200 or B300 GPUs for the quantized build
- 4
- Mistral Large 4
- 41%
- GLM-5.3
- 40%
- DeepSeek V4.1 Flash
- 31%
- Large 4 preview
- 28%
- Kimi K3
- 21%
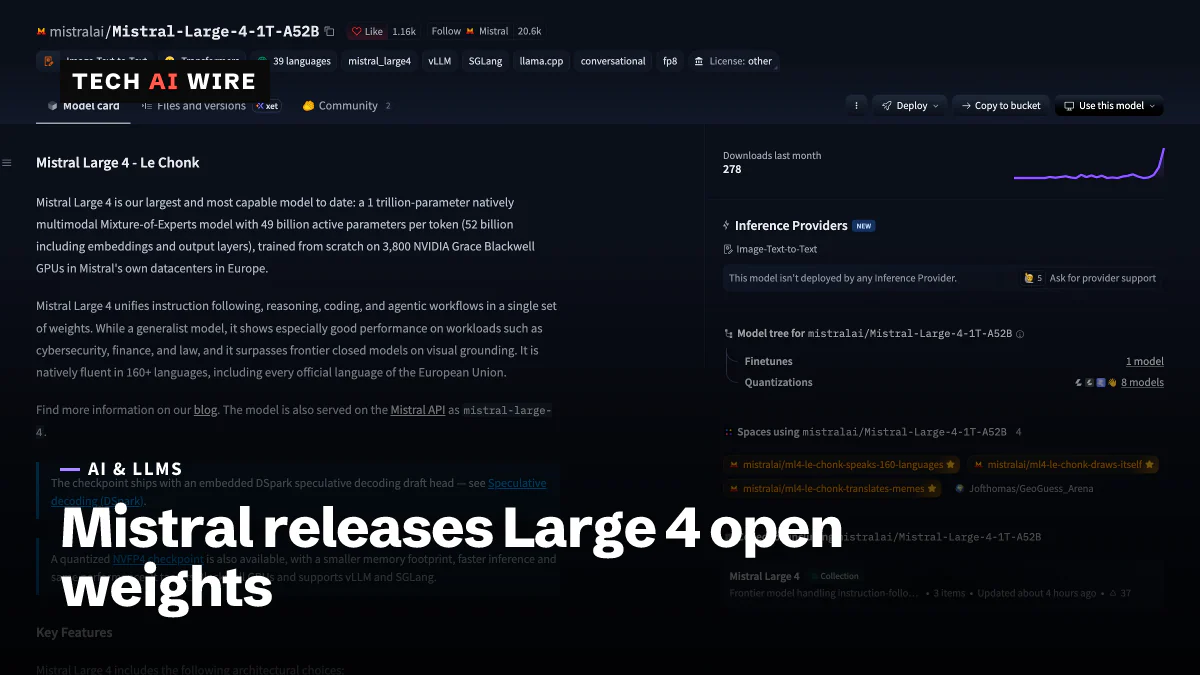
A Mistral AI publicou os pesos abertos do Mistral Large 4 no Hugging Face em 29 de outubro de 2026, cerca de três semanas após a prévia da API do modelo. Agora qualquer pessoa pode baixar o modelo de cerca de 1 trilhão de parâmetros e rodá-lo nos próprios servidores. O porém está na licença: uma empresa que vende acesso a ele como serviço hospedado precisa de um acordo separado com a Mistral.
O lançamento vem depois da prévia pública de 6 de outubro, quando a Mistral disse que os pesos chegariam mais tarde no mês. Eles chegaram com pontuações melhores em benchmarks, dois novos modos de raciocínio e uma licença próxima da MIT, mas não exatamente igual.
O que a Mistral lançou
O anúncio da Mistral chama o modelo de "Le Chonk". É um modelo de mistura de especialistas, ou MoE. Esse design divide a rede em muitas partes "especialistas" menores e envia cada token por apenas algumas delas. Assim, o modelo é enorme em disco, mas faz muito menos trabalho por palavra do que o tamanho sugere.
A ficha do modelo no Hugging Face lista as principais especificações:
| Especificação | Mistral Large 4 |
|---|---|
| Repositório | mistralai/Mistral-Large-4-1T-A52B |
| Parâmetros totais | Cerca de 1 trilhão |
| Parâmetros ativos por token | 49B, ou 52B com as camadas de embedding e de saída |
| Especialistas | 128 roteados, 4 ativos, mais 1 compartilhado |
| Janela de contexto | 1M de tokens |
| Entradas | Texto e imagens |
| Idiomas | 160+ |
A ficha também lista uma cabeça de rascunho DSpark embutida. Ela viabiliza a decodificação especulativa, um truque em que um ajudante pequeno e rápido adivinha os próximos tokens e o modelo grande os confere. A Mistral diz que isso aumenta a vazão em até 1,9 vez em suas próprias medições.
A OrcaRouter, uma empresa de roteamento de IA, inspecionou o repositório no dia do lançamento. Ela contou 54 arquivos de pesos que somam 1.060,6 GB em bf16, um formato numérico de 16 bits, e não encontrou nenhuma barreira de acesso. Um segundo repositório traz uma versão NVFP4, que usa o formato de 4 bits da Nvidia, com 610,1 GB.
O que a licença permite
Os pesos são distribuídos sob a Mistral Ecosystem Open-Weight License. A Mistral a descreve como uma licença MIT modificada, e a MIT é uma das licenças mais permissivas do software. Uso, alterações, fine-tuning e produtos comerciais são todos permitidos.
A mudança é uma única cláusula. Uma empresa que "opera um negócio de Model as a Service" precisa antes obter uma licença comercial separada da Mistral, segundo a leitura que a OrcaRouter fez do arquivo de licença. Isso significa deixar clientes externos enviarem prompts ao modelo e controlarem suas entradas ou configurações.
Segundo a OrcaRouter, estes usos ficam fora dessa cláusula:
- Produtos que incorporam o modelo aos próprios recursos
- Serviços que apenas repassam solicitações a modelos hospedados por terceiros
- Uso interno sem acesso de terceiros
- Uso por meio dos próprios produtos da Mistral
Benchmarks após mais três semanas de treinamento
A Mistral usou o tempo desde a prévia para mais aprendizado por reforço, uma etapa de treinamento que recompensa o modelo por boas respostas. O The Next Web informa que isso elevou sua pontuação no Terminal-Bench 4.0 de 28% para 41%. O Terminal-Bench mede quão bem um modelo conclui tarefas na linha de comando.
A Mistral divulgou estes outros resultados para o modelo lançado:
| Benchmark | Pontuação | Observação |
|---|---|---|
| Artificial Analysis Coding Agent Index | 48% | 47% menos tokens por tarefa |
| Artificial Analysis Cyber Index | 51% | Número da Mistral |
| CyberGym-E2E | 79% | Igual ao MiMo-V2.6-Pro, segundo o The Next Web |
| BrowseComp | 84,5% | Número da Mistral |
| B3 Agent Security Benchmark | 97,1% | Acima dos 93,3% da prévia |
Segundo o The Next Web, o resultado no índice de programação empata com o GLM-5.3 usando 47% menos tokens por tarefa. Menos tokens significam contas menores e respostas mais rápidas para o mesmo trabalho. A Mistral também adicionou modos de raciocínio baixo e médio, e diz que o modo alto padrão agora é 50% mais eficiente.
Em segurança, a Mistral diz que o modelo recusou em média 96,6% das solicitações cibernéticas maliciosas. Ela diz que o modelo continua dando conta de trabalhos legítimos de segurança defensiva.
Esses são números do fornecedor. A OrcaRouter observa que nenhum terceiro havia refeito os benchmarks com os arquivos lançados. Ela acrescenta que a Artificial Analysis mudou a base do seu Intelligence Index em 27 de outubro. Por isso, a nova pontuação v5 do modelo, 26, não é comparável aos 38,4 que ele registrou na prévia.
Preço e hardware
Os preços da API hospedada são conflitantes. O anúncio da Mistral lista US$ 0,70 por milhão de tokens de entrada, US$ 0,07 para entrada em cache e US$ 2,10 para saída. A OrcaRouter diz que esses são preços promocionais arredondados de US$ 0,68 e US$ 2,09, contra preços de tabela de US$ 1,36 e US$ 4,18. O The Next Web informou que os preços da API ainda não tinham sido publicados.
Rodar o modelo por conta própria exige um servidor, não uma estação de trabalho. O exemplo de vLLM da ficha do modelo divide o modelo entre 8 GPUs. A OrcaRouter coloca a versão bf16 em oito aceleradores com 141 GB de memória cada. O The Next Web informa que a versão quantizada roda em quatro GPUs Nvidia B200 ou B300.
A Mistral treinou o modelo com 3.800 GPUs Nvidia Grace Blackwell na Europa. Segundo o The Next Web, o treinamento extra consumiu cerca de 10 megawatts na França. "Outros laboratórios levantaram centenas de bilhões para desenvolver capacidades equivalentes", disse o CEO Arthur Mensch ao veículo.
O modelo também é oferecido pelo OpenRouter, pelos endpoints da Nvidia e pelo Microsoft Foundry, segundo a Mistral. Entre os modelos abertos anteriores com que ele agora compete está o MiMo-V2.6-Pro da Xiaomi, lançado sob uma licença MIT simples.
O que isso significa para desenvolvedores
- Leia a cláusula 2 antes de construir um produto sobre ele. Se seus clientes enviam os próprios prompts e escolhem as configurações do modelo, você pode ser considerado um negócio de Model as a Service. Consulte a Mistral antes do lançamento, não depois.
- Espere que seu scanner de licenças o sinalize. O Hugging Face marca a licença como "other", não como MIT. Adicione-a à sua lista aprovada de propósito, após uma revisão jurídica.
- Planeje o download como uma migração de dados. Mais de um terabyte de pesos exige armazenamento rápido e horas de transferência. Equipes com GPUs Blackwell podem começar pela versão NVFP4 de 610,1 GB.
- Teste primeiro na API hospedada. Todas as pontuações acima foram informadas pelo fornecedor. Rode suas próprias tarefas de programação e de agentes pela API antes de comprar ou alugar oito GPUs.
- Conte tokens, além das pontuações. Quando você paga por token, um corte de 47% nos tokens por tarefa pode pesar mais que um ponto de vantagem em um benchmark.
A Mistral também planeja versões destiladas menores do modelo, informa o The Next Web, mas não deu datas.
Fontes
- Mistral Large 4 (Le Chonk) is now open weight - Mistral AI
- mistralai/Mistral-Large-4-1T-A52B - Hugging Face
- Mistral releases open weights for its 1 trillion-parameter Large 4 model - The Next Web
- Mistral Large 4 Open Weights: 1.06 TB, No Gate, One Catch - OrcaRouter
Artigos relacionados
Nvidia Nemotron 3.5 Transcribe: um único modelo de voz aberto
O Nemotron 3.5 Transcribe da Nvidia é um modelo de pesos abertos que transcreve 40 idiomas, identifica falantes e traduz, treinado com 463.062 horas de áudio.
Pesos abertos do Reflection Beam chegam sob Apache 2.0
A Reflection publicou os pesos do Beam, com 501 bilhões de parâmetros, no Hugging Face em 16 de outubro de 2026, sob Apache 2.0. As versões FP8 e de 4 bits cabem em um servidor com 8 GPUs.
StepFun Step 5 Preview: modelo de 600B para agentes, com pesos abertos
O Step 5 Preview da StepFun, um modelo de 600B parâmetros com 27B ativos e contexto de 1M de tokens, chegou ao Hugging Face após um mês só na API, a US$ 1/US$ 2,70 por milhão.