Los pesos abiertos de Mistral Large 4 llegan a Hugging Face
Los pesos de Mistral Large 4 se hicieron públicos el 29 de octubre: una descarga de 1060,6 GB bajo una licencia MIT modificada. Ofrecerlo como servicio alojado exige un acuerdo aparte.
5 min de lectura
En cifras
- size of the bf16 weights, per OrcaRouter
- 1,060.6 GB
- Terminal-Bench 4.0 score, up from 28% in preview
- 41%
- token context window, per the model card
- 1M
- Nvidia B200 or B300 GPUs for the quantized build
- 4
- Mistral Large 4
- 41%
- GLM-5.3
- 40%
- DeepSeek V4.1 Flash
- 31%
- Large 4 preview
- 28%
- Kimi K3
- 21%
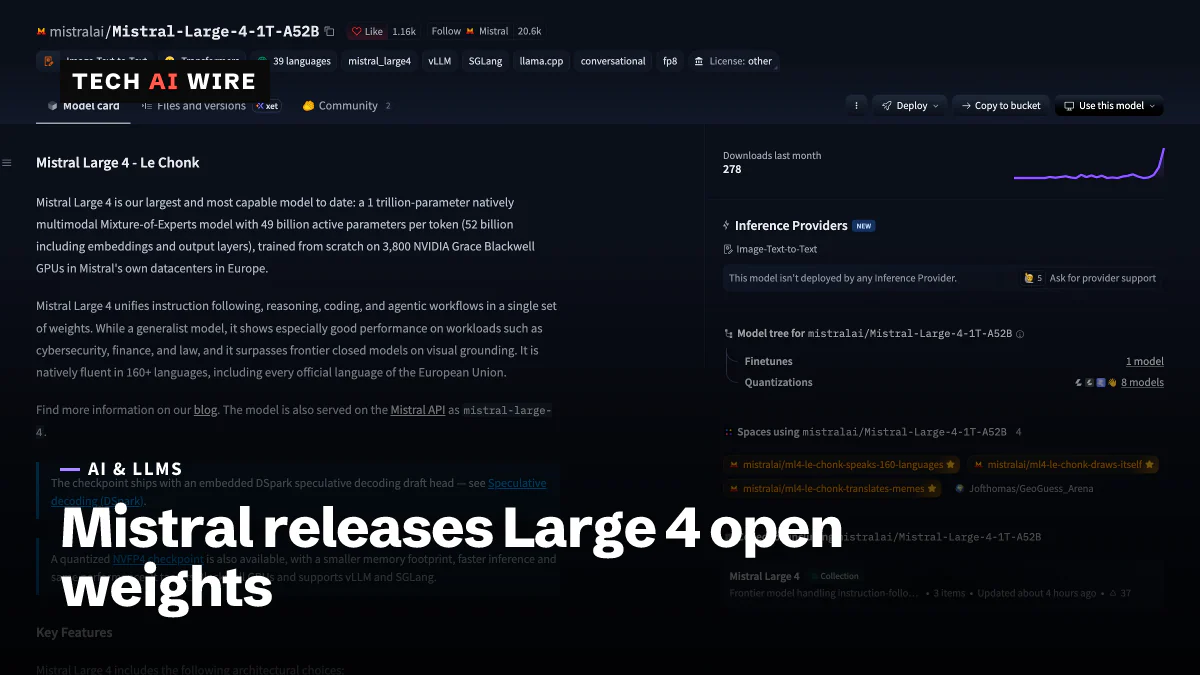
Mistral AI publicó los pesos abiertos de Mistral Large 4 en Hugging Face el 29 de octubre de 2026, unas tres semanas después de la vista previa de la API del modelo. Ahora cualquiera puede descargar este modelo de alrededor de 1 billón de parámetros y ejecutarlo en sus propios servidores. La trampa está en la licencia: una empresa que venda el acceso como servicio alojado necesita un acuerdo aparte con Mistral.
El lanzamiento llega tras la vista previa pública del 6 de octubre, cuando Mistral dijo que los pesos llegarían más adelante en el mes. Llegaron con mejores resultados en benchmarks, dos nuevos modos de razonamiento y una licencia parecida a la MIT, pero no del todo.
Qué ha lanzado Mistral
El anuncio de Mistral llama al modelo «Le Chonk». Es un modelo de mezcla de expertos, o MoE. Este diseño divide la red en muchas partes «expertas» más pequeñas y envía cada token solo a través de unas pocas. Así, el modelo es enorme en disco, pero trabaja mucho menos por palabra de lo que sugiere su tamaño.
La ficha del modelo en Hugging Face recoge las especificaciones principales:
| Especificación | Mistral Large 4 |
|---|---|
| Repositorio | mistralai/Mistral-Large-4-1T-A52B |
| Parámetros totales | Alrededor de 1 billón |
| Parámetros activos por token | 49B, o 52B con las capas de embedding y de salida |
| Expertos | 128 enrutados, 4 activos, más 1 compartido |
| Ventana de contexto | 1M de tokens |
| Entradas | Texto e imágenes |
| Idiomas | 160+ |
La ficha también menciona un cabezal de borrador DSpark integrado. Permite la decodificación especulativa, un truco en el que un ayudante pequeño y rápido adivina los siguientes tokens y el modelo grande los comprueba. Mistral dice que esto aumenta el rendimiento hasta 1,9 veces en sus propias mediciones.
OrcaRouter, una empresa de enrutamiento de IA, examinó el repositorio el día del lanzamiento. Contó 54 archivos de pesos que suman 1060,6 GB en bf16, un formato numérico de 16 bits, y no encontró ninguna barrera de acceso. Un segundo repositorio contiene una versión NVFP4, que usa el formato de 4 bits de Nvidia, de 610,1 GB.
Qué permite la licencia
Los pesos se distribuyen bajo la Mistral Ecosystem Open-Weight License. Mistral la describe como una licencia MIT modificada, y la MIT es una de las licencias más permisivas del software. Se permiten el uso, los cambios, el ajuste fino y los productos comerciales.
El cambio es una sola cláusula. Una empresa que «opere un negocio de Model as a Service» debe obtener antes una licencia comercial aparte de Mistral, según la lectura que OrcaRouter hace del archivo de licencia. Eso significa permitir que clientes externos envíen prompts al modelo y controlen sus entradas o su configuración.
Según OrcaRouter, estos usos quedan fuera de esa cláusula:
- Productos que integran el modelo en sus propias funciones
- Servicios que solo retransmiten solicitudes a modelos alojados por otros
- Uso interno sin acceso para terceros
- Uso a través de los propios productos de Mistral
Benchmarks tras tres semanas más de entrenamiento
Mistral dedicó el tiempo transcurrido desde la vista previa a más aprendizaje por refuerzo, una fase de entrenamiento que premia al modelo por las buenas respuestas. The Next Web informa de que esto elevó su puntuación en Terminal-Bench 4.0 del 28 % al 41 %. Terminal-Bench mide lo bien que un modelo completa tareas en la línea de comandos.
Mistral comunicó estos otros resultados para el modelo publicado:
| Benchmark | Puntuación | Nota |
|---|---|---|
| Artificial Analysis Coding Agent Index | 48 % | 47 % menos tokens por tarea |
| Artificial Analysis Cyber Index | 51 % | Cifra de Mistral |
| CyberGym-E2E | 79 % | Igual que MiMo-V2.6-Pro, según The Next Web |
| BrowseComp | 84,5 % | Cifra de Mistral |
| B3 Agent Security Benchmark | 97,1 % | Frente al 93,3 % de la vista previa |
The Next Web dice que el resultado en el índice de programación empata con GLM-5.3 usando un 47 % menos de tokens por tarea. Menos tokens significa facturas más pequeñas y respuestas más rápidas para el mismo trabajo. Mistral también añadió modos de razonamiento bajo y medio, y dice que el modo alto predeterminado es ahora un 50 % más eficiente.
En seguridad, Mistral dice que el modelo rechazó de media el 96,6 % de las solicitudes cibernéticas maliciosas. Afirma que el modelo sigue atendiendo el trabajo legítimo de seguridad defensiva.
Son cifras del fabricante. OrcaRouter señala que ningún tercero había vuelto a ejecutar los benchmarks con los archivos publicados. Añade que Artificial Analysis cambió la base de su Intelligence Index el 27 de octubre. Por eso, la nueva puntuación v5 del modelo, 26, no es comparable con el 38,4 que obtuvo en la vista previa.
Precio y hardware
Los precios de la API alojada no coinciden. El anuncio de Mistral indica 0,70 $ por millón de tokens de entrada, 0,07 $ por la entrada en caché y 2,10 $ por la salida. OrcaRouter dice que son precios promocionales redondeados de 0,68 $ y 2,09 $, frente a precios de lista de 1,36 $ y 4,18 $. The Next Web informó de que los precios de la API aún no se habían publicado.
Ejecutarlo por cuenta propia requiere un servidor, no una estación de trabajo. El ejemplo de vLLM de la ficha del modelo reparte el modelo entre 8 GPU. OrcaRouter sitúa la versión bf16 en ocho aceleradores con 141 GB de memoria cada uno. The Next Web informa de que la versión cuantizada funciona en cuatro GPU Nvidia B200 o B300.
Mistral entrenó el modelo con 3800 GPU Nvidia Grace Blackwell en Europa. The Next Web dice que el entrenamiento adicional consumió unos 10 megavatios en Francia. «Otros laboratorios han recaudado cientos de miles de millones para desarrollar capacidades equivalentes», dijo el CEO Arthur Mensch al medio.
El modelo también se ofrece a través de OpenRouter, los endpoints de Nvidia y Microsoft Foundry, según Mistral. Entre los modelos abiertos anteriores con los que ahora compite está MiMo-V2.6-Pro de Xiaomi, que salió con una licencia MIT sin modificar.
Qué significa para los desarrolladores
- Lea la cláusula 2 antes de construir un producto sobre él. Si sus clientes envían sus propios prompts y eligen la configuración del modelo, usted puede contar como un negocio de Model as a Service. Pregunte a Mistral antes del lanzamiento, no después.
- Cuente con que su escáner de licencias lo marque. Hugging Face etiqueta la licencia como «other», no como MIT. Añádala a su lista aprobada a propósito, tras una revisión legal.
- Planifique la descarga como una migración de datos. Más de un terabyte de pesos necesita almacenamiento rápido y horas de transferencia. Los equipos con GPU Blackwell pueden empezar por la versión NVFP4 de 610,1 GB.
- Pruebe primero en la API alojada. Todas las puntuaciones anteriores las aporta el fabricante. Ejecute sus propias tareas de programación y de agentes a través de la API antes de comprar o alquilar ocho GPU.
- Cuente los tokens además de las puntuaciones. Cuando se paga por token, un recorte del 47 % en tokens por tarea puede importar más que un punto de ventaja en un benchmark.
Mistral también planea versiones destiladas más pequeñas del modelo, según The Next Web, pero no ha dado fechas.
Fuentes
- Mistral Large 4 (Le Chonk) is now open weight - Mistral AI
- mistralai/Mistral-Large-4-1T-A52B - Hugging Face
- Mistral releases open weights for its 1 trillion-parameter Large 4 model - The Next Web
- Mistral Large 4 Open Weights: 1.06 TB, No Gate, One Catch - OrcaRouter
Artículos relacionados
Nvidia Nemotron 3.5 Transcribe: un solo modelo de voz abierto
Nemotron 3.5 Transcribe de Nvidia es un modelo de pesos abiertos que transcribe 40 idiomas, identifica a los hablantes y traduce, entrenado con 463.062 horas de audio.
Los pesos abiertos de Reflection Beam llegan bajo Apache 2.0
Reflection publicó en Hugging Face los pesos de Beam, con 501.000 millones de parámetros, el 16 de octubre de 2026 bajo Apache 2.0. Las versiones FP8 y de 4 bits caben en un servidor de 8 GPU.
StepFun Step 5 Preview: modelo para agentes de 600B con pesos abiertos
Step 5 Preview de StepFun, un modelo de 600B parámetros con 27B activos y un contexto de 1M de tokens, está en Hugging Face tras un mes solo por API a 1 y 2,70 dólares por millón.