Microsofts Chip Maia 300 soll 40 % mehr Tokens pro Watt liefern
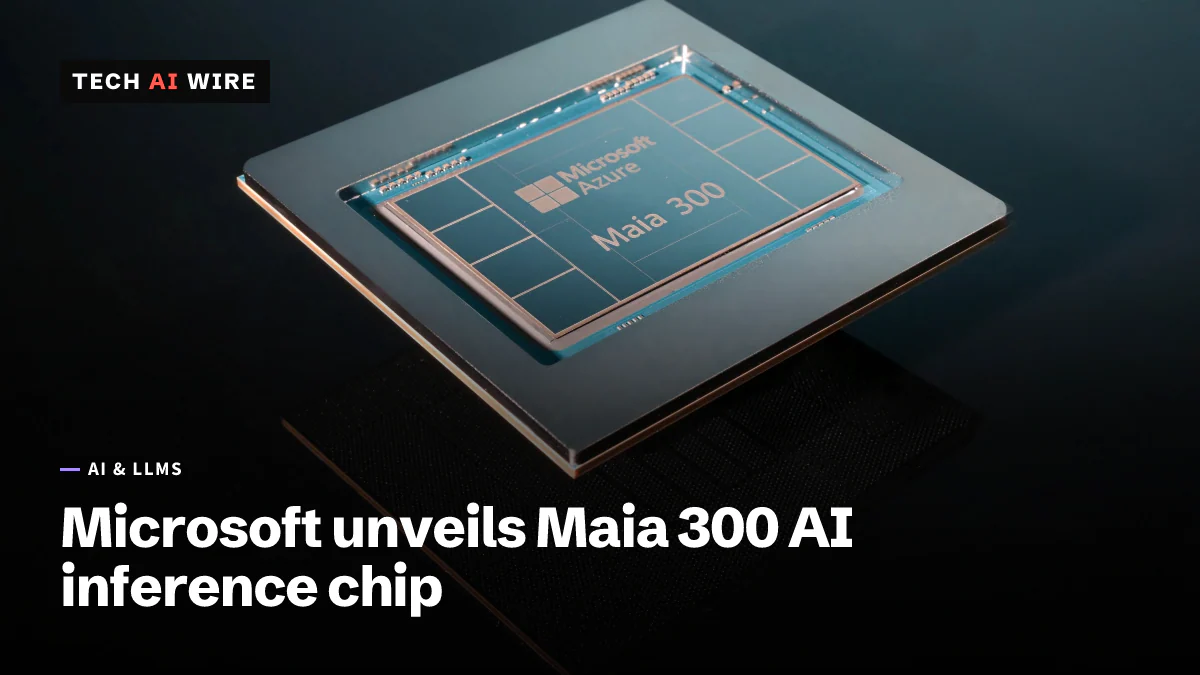
Microsoft hat Maia 300 vorgestellt, die dritte Generation seines KI-Chips. Microsoft erwartet 40 % mehr Tokens pro Watt als führende GPU-basierte Systeme. Der Einsatz ist für 2027 geplant.
3 Min. Lesezeit
Die Zahlen
- more tokens per watt than leading GPU-based systems, Microsoft expects
- 40%
- of HBM4 memory per chip
- 288 GB
- rack-scale token throughput of Maia 200, at most
- 7x
- planned production deployment, per Data Center Knowledge
- 2027
Microsoft hat Maia 300 vorgestellt, die dritte Generation seines eigenen KI-Chips. Der Chip ist dafür gebaut, KI-Modelle auszuführen, nicht sie zu trainieren. Microsoft erwartet, dass er 40 % mehr Tokens pro Watt liefert als führende GPU-basierte Systeme. Ein Token ist ein kleines Stück Text, das ein Modell liest oder schreibt. Die Zahl misst also, wie viel KI-Ausgabe der Chip für den verbrauchten Strom liefert. Der Chip zielt auf die Dienste, die Microsoft bereits betreibt, darunter Copilot und GitHub Copilot.
Was Microsoft angekündigt hat
Microsoft beschrieb den Chip in zwei Azure-Blogbeiträgen vom 12. und 13. Oktober 2026. Laut der technischen Detailanalyse ist Maia 300 für Inferenz gebaut. Inferenz ist die Arbeit, ein trainiertes Modell auszuführen, um Anfragen zu beantworten. Der Chip zielt auf Long-Context-, Reasoning- und agentische Workloads, bei denen ein Modell lange Antworten Schritt für Schritt schreibt.
Das steckt laut Microsoft im Chip:
| Bauteil | Detail |
|---|---|
| Compute-Dies | Gefertigt im N2P-Prozess von TSMC |
| Speicher und I/O | Auf separaten Dies |
| Speicher | Acht HBM4-Stacks, insgesamt 288 GB |
| Speicherbandbreite | 18 TB/s |
| Rack | 96 Chips in 24 Trays zu je vier, mit einer Leistungsaufnahme von 167 kW |
| Kühlung | Flüssigkühlung führt mehr als 80 % der Wärme des Racks ab |
| Größter Cluster | Bis zu 12.288 Chips in bis zu 128 Racks |
| Netzwerk | Ein eigens entwickelter KI-Transport auf Basis von Ethernet |
HBM4 ist eine Art schneller Speicher, der direkt neben dem Chip gestapelt wird. Viel Speicher ist für Inferenz wichtig. Das Modell und seine langen Unterhaltungen müssen nah an der Rechenleistung liegen.
Der Vergleich mit Maia 200
Maia 200, der Vorgängerchip, ist bereits in Produktion und treibt Copilot an, berichtet Data Center Knowledge. Laut Microsoft wird Maia 200 in den USA, in Europa und in Australien eingesetzt.
Gegenüber Maia 200 nennt Microsoft für Maia 300 diese Verbesserungen:
- Speicherbandbreite: 2,5-mal höher.
- Speicherkapazität: 33 % mehr.
- Rechenleistung: 36 % mehr FLOPs, ein Maß für die reine Rechengeschwindigkeit.
- Chip-zu-Chip-Bandbreite: 14 % mehr.
- Rack-Leistung: bis zum 7-fachen Token-Durchsatz in einem vollen Rack mit 96 Chips.
- Dichte: doppelt so viele Chips pro Rack.
Die Effizienzangabe
„Wir erwarten, dass Maia 300 40 % mehr Tokens pro Watt liefert als führende GPU-basierte Systeme“, heißt es in Microsofts Beitrag vom 13. Oktober. Es handelt sich um eine Prognose. Die Beiträge nennen nicht, mit welchen GPU-Systemen Microsoft verglichen hat.
Microsoft macht eine ähnliche Angabe für den älteren Chip. Demnach liefert Maia 200 bis zu 1,7-mal mehr Tokens pro Watt als führende GPU-Infrastruktur für KI-Funktionen in Teams, Copilot und Cowork.
Microsoft ist weiterhin stark auf GPUs von Nvidia und AMD angewiesen, merkt Data Center Knowledge an. Auch Amazon und Google bauen eigene KI-Chips. Im August erklärte OpenAI, sein Chip Jalapeño schlage Nvidias GB300 pro Watt, ebenfalls auf Basis eigener Zahlen.
Wann der Chip kommt
Microsoft will Maia 300 im Jahr 2027 in den Produktionseinsatz bringen, mit Installationen im Multi-Gigawatt-Maßstab, berichtet Data Center Knowledge. Microsoft nennt Microsoft Copilot, GitHub Copilot und Microsoft Foundry unter den Workloads, für die der Chip ausgelegt ist. Mehr will Microsoft auf seiner Konferenz Ignite vom 17. bis 20. November 2026 mitteilen.
Für eigene Workloads von Kunden auf Azure-Instanzen stehen Maia-Chips nicht zur Verfügung, schreibt das Fachmedium. Microsofts Beiträge ließen offen, ob sich das ändern wird.
„Maia 100 war ein Proof of Concept“, sagte Matt Kimball gegenüber Data Center Knowledge. Kimball ist im Bereich Analyse bei Moor Insights & Strategy tätig. Über den neuen Chip sagte Kimball: „Er wird sehr breit eingesetzt werden, um ihre Workloads auf der ganzen Welt zu unterstützen.“
Was das für Entwickler bedeutet
Für Teams, die auf Azure oder Microsofts KI-Diensten aufbauen:
- Direkt mieten lässt sich der Chip nicht. Maia betreibt Microsofts eigene Dienste, nicht Ihre virtuellen Maschinen. Planen Sie GPU-Kapazität auf Azure wie bisher.
- Die Dienste im Blick behalten, die er antreiben wird. Copilot, GitHub Copilot und Foundry sind die genannten Ziele. Falls Maia Microsofts Kosten pro Token senkt, achten Sie 2027 auf Änderungen bei deren Preisen und Ratenlimits.
- Der Schwerpunkt liegt auf langem Kontext. Mit 288 GB Speicher pro Chip begünstigt das Design lange Prompts und Agenten, die viele Schritte ausführen. Bei diesen Aufgaben wachsen die Inferenzkosten am schnellsten.
- Die 40 % als Herstellerangabe behandeln. Ein Vergleichssystem wird nicht genannt. Wenn Dienste auf Maia-Basis starten, testen Sie sie mit Ihren eigenen Workloads, bevor Sie Traffic verlagern.
- Die Ignite im November verfolgen. Microsoft hat dort mehr Details versprochen, auch zu einer möglichen Änderung, wer den Chip nutzen kann.
Quellen
- Deep dive into Azure Maia 300 architecture - Microsoft Azure Blog
- Infrastructure for the frontier era: Scaling intelligence through open industry collaboration - Microsoft Azure Blog
- Microsoft Pushes Custom AI Chips with Azure Maia 300 - Data Center Knowledge
Ähnliche Artikel
Microsoft-Decision-1 bewertet Auswahloptionen, statt Text zu schreiben
Microsoft-Decision-1 gibt für jede feste Option eine Wahrscheinlichkeit aus, statt Text zu schreiben. In Microsoft Foundry kostet es 0,042 US-Dollar pro Million Input-Tokens.
OpenAI sagt, sein Jalapeño-Chip schlägt Nvidias GB300 pro Watt
OpenAIs erste veröffentlichte Jalapeño-Benchmarks beanspruchen 1,5- bis 1,9-mal mehr Arbeit pro Kilowatt als Nvidias GB300, bei halber Leistungsaufnahme. Die Zahlen stammen von OpenAI selbst.
Nvidias Inferenz-Chip Groq 3 LPX geht in die Serienproduktion
Nvidia hat seinen dedizierten Inferenz-Beschleuniger in die Serienproduktion gebracht: GPUs übernehmen den Kontext, die neuen Chips die Token-Erzeugung.