La puce Microsoft Maia 300 vise 40 % de tokens par watt en plus
Microsoft a dévoilé Maia 300, sa puce d'IA de troisième génération. Microsoft prévoit 40 % de tokens par watt en plus que les principaux systèmes à base de GPU, avec des déploiements en 2027.
3 min de lecture
En chiffres
- more tokens per watt than leading GPU-based systems, Microsoft expects
- 40%
- of HBM4 memory per chip
- 288 GB
- rack-scale token throughput of Maia 200, at most
- 7x
- planned production deployment, per Data Center Knowledge
- 2027
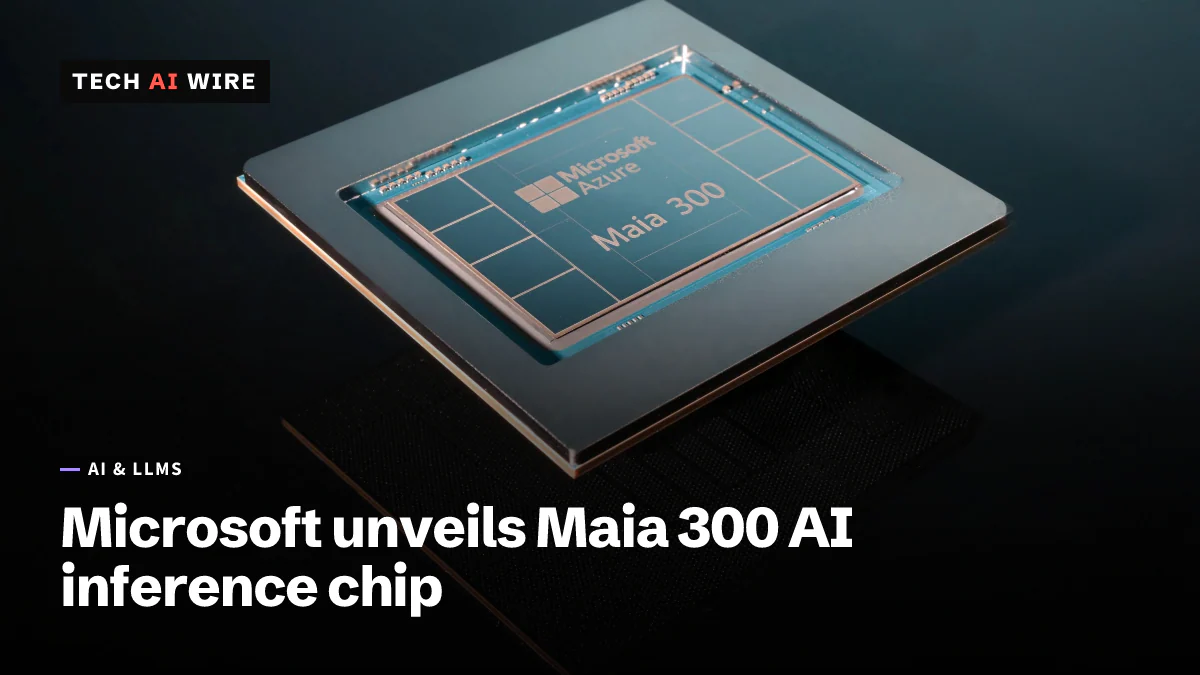
Microsoft a dévoilé Maia 300, la troisième génération de sa propre puce d'IA. Elle est conçue pour exécuter des modèles d'IA plutôt que pour les entraîner. Microsoft prévoit qu'elle fournira 40 % de tokens par watt en plus que les principaux systèmes à base de GPU. Un token est un petit morceau de texte qu'un modèle lit ou écrit. Ce chiffre mesure donc la quantité de résultats d'IA que la puce produit pour l'énergie qu'elle consomme. La puce vise les services que Microsoft exploite déjà, dont Copilot et GitHub Copilot.
Ce que Microsoft a annoncé
Microsoft a décrit la puce dans deux billets du blog Azure datés des 12 et 13 octobre 2026. Son analyse technique détaillée indique que Maia 300 est conçue pour l'inférence, c'est-à-dire l'exécution d'un modèle entraîné pour répondre à des requêtes. Elle cible les charges de travail à long contexte, de raisonnement et agentiques, où un modèle rédige de longues réponses une étape à la fois.
Voici ce que la puce contient, selon Microsoft :
| Élément | Détail |
|---|---|
| Dies de calcul | Fabriqués avec le procédé N2P de TSMC |
| Mémoire et E/S | Sur des dies séparés |
| Mémoire | Huit piles HBM4, 288 Go au total |
| Bande passante mémoire | 18 To/s |
| Rack | 96 puces réparties en 24 plateaux de quatre, pour une consommation de 167 kW |
| Refroidissement | Le refroidissement liquide évacue plus de 80 % de la chaleur du rack |
| Plus grand cluster | Jusqu'à 12 288 puces, sur 128 racks au maximum |
| Réseau | Un transport d'IA sur mesure, construit sur Ethernet |
HBM4 est un type de mémoire rapide empilée à côté de la puce. Une grande mémoire compte pour l'inférence, car le modèle et ses longues conversations doivent se trouver près des unités de calcul.
Comment elle se compare à Maia 200
Maia 200, la puce précédente, est déjà en production et fait tourner Copilot, rapporte Data Center Knowledge. Selon Microsoft, Maia 200 est en cours de déploiement aux États-Unis, en Europe et en Australie.
Par rapport à Maia 200, Microsoft annonce ces gains pour Maia 300 :
- Bande passante mémoire : 2,5 fois plus élevée.
- Capacité mémoire : 33 % de plus.
- Calcul : 36 % de FLOPs en plus, une mesure de la vitesse de calcul brute.
- Bande passante entre puces : 14 % de plus.
- Production du rack : jusqu'à 7 fois le débit de tokens dans un rack complet de 96 puces.
- Densité : deux fois plus de puces par rack.
L'argument de l'efficacité
« Nous prévoyons que Maia 300 offrira 40 % de tokens par watt en plus par rapport aux principaux systèmes à base de GPU », indique le billet de Microsoft du 13 octobre. Il s'agit d'une projection. Les billets ne précisent pas à quels systèmes GPU Microsoft s'est comparé.
Microsoft avance une affirmation similaire pour l'ancienne puce. Selon Microsoft, Maia 200 offre jusqu'à 1,7 fois plus de tokens par watt que les principales infrastructures GPU pour les fonctions d'IA de Teams, Copilot et Cowork.
Microsoft dépend encore fortement des GPU de Nvidia et d'AMD, note Data Center Knowledge. Amazon et Google conçoivent aussi leurs propres puces d'IA. En août, OpenAI a affirmé que sa puce Jalapeño bat la GB300 de Nvidia par watt, là encore selon ses propres chiffres.
Quand elle arrivera
Microsoft prévoit de mettre Maia 300 en production en 2027, avec des déploiements à l'échelle de plusieurs gigawatts, rapporte Data Center Knowledge. Microsoft cite Microsoft Copilot, GitHub Copilot et Microsoft Foundry parmi les charges de travail pour lesquelles la puce est conçue. Selon Microsoft, d'autres détails seront partagés lors de sa conférence Ignite, du 17 au 20 novembre 2026.
Les puces Maia ne sont pas disponibles pour les charges de travail propres des clients sur les instances Azure, note le média. Les billets de Microsoft ne disent pas si cela va changer.
« Maia 100 était une preuve de concept », a déclaré Matt Kimball, analyste chez Moor Insights & Strategy, à Data Center Knowledge. À propos de la nouvelle puce, Kimball a déclaré : « Elle va être utilisée très largement pour soutenir leurs charges de travail dans le monde entier. »
Ce que cela signifie pour les développeurs
Pour les équipes qui s'appuient sur Azure ou sur les services d'IA de Microsoft :
- Vous ne pouvez pas la louer directement. Maia fait tourner les propres services de Microsoft, pas vos machines virtuelles. Planifiez vos capacités GPU sur Azure comme avant.
- Surveillez les services qu'elle alimentera. Copilot, GitHub Copilot et Foundry sont les cibles citées. Si Maia réduit le coût par token de Microsoft, guettez des changements de tarifs et de limites de débit pour ces services en 2027.
- L'accent est mis sur le long contexte. Avec 288 Go de mémoire par puce, la conception favorise les longs prompts et les agents qui enchaînent de nombreuses étapes. Ce sont les tâches où les coûts d'inférence augmentent le plus vite.
- Considérez les 40 % comme un chiffre du fournisseur. Aucun système de comparaison n'est nommé. Quand les services fondés sur Maia seront lancés, testez-les sur vos propres charges de travail avant d'y basculer du trafic.
- Suivez Ignite en novembre. Microsoft a promis plus de détails à cette occasion, y compris sur tout changement concernant qui peut utiliser la puce.
Sources
- Deep dive into Azure Maia 300 architecture - Microsoft Azure Blog
- Infrastructure for the frontier era: Scaling intelligence through open industry collaboration - Microsoft Azure Blog
- Microsoft Pushes Custom AI Chips with Azure Maia 300 - Data Center Knowledge
Articles liés
Microsoft-Decision-1 note des choix au lieu d'écrire du texte
Microsoft-Decision-1 renvoie une probabilité pour chaque option fixe au lieu d'écrire du texte. Il coûte 0,042 dollar par million de tokens en entrée dans Microsoft Foundry.
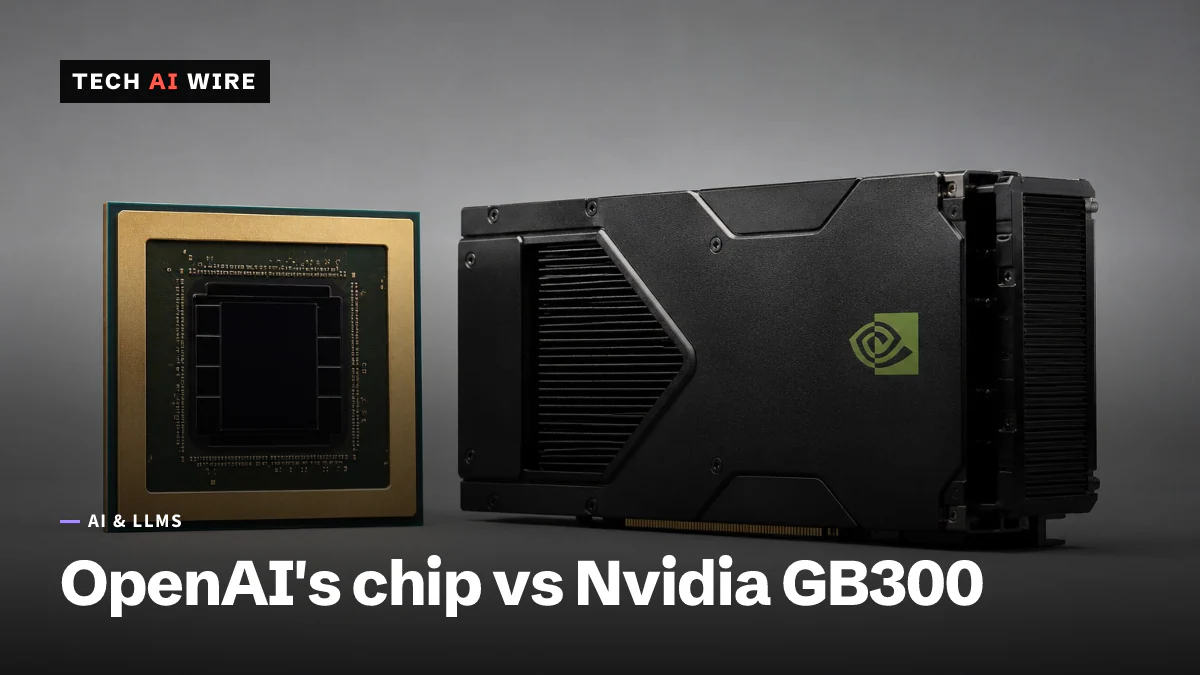
OpenAI affirme que sa puce Jalapeño bat la GB300 de Nvidia par watt
Les premiers benchmarks publiés par OpenAI pour Jalapeño revendiquent 1,5 à 1,9 fois plus de travail par kilowatt que la GB300 de Nvidia, pour moitié moins de puissance. Les chiffres sont ceux d'OpenAI.
La puce d'inférence Groq 3 LPX de Nvidia entre en production
Nvidia met son accélérateur d'inférence dédié en pleine production : les GPU traitent le contexte, les nouvelles puces s'occupent de la génération de jetons.