MicrosoftのMaia 300チップ、ワット当たりのトークン数40%増を目指す
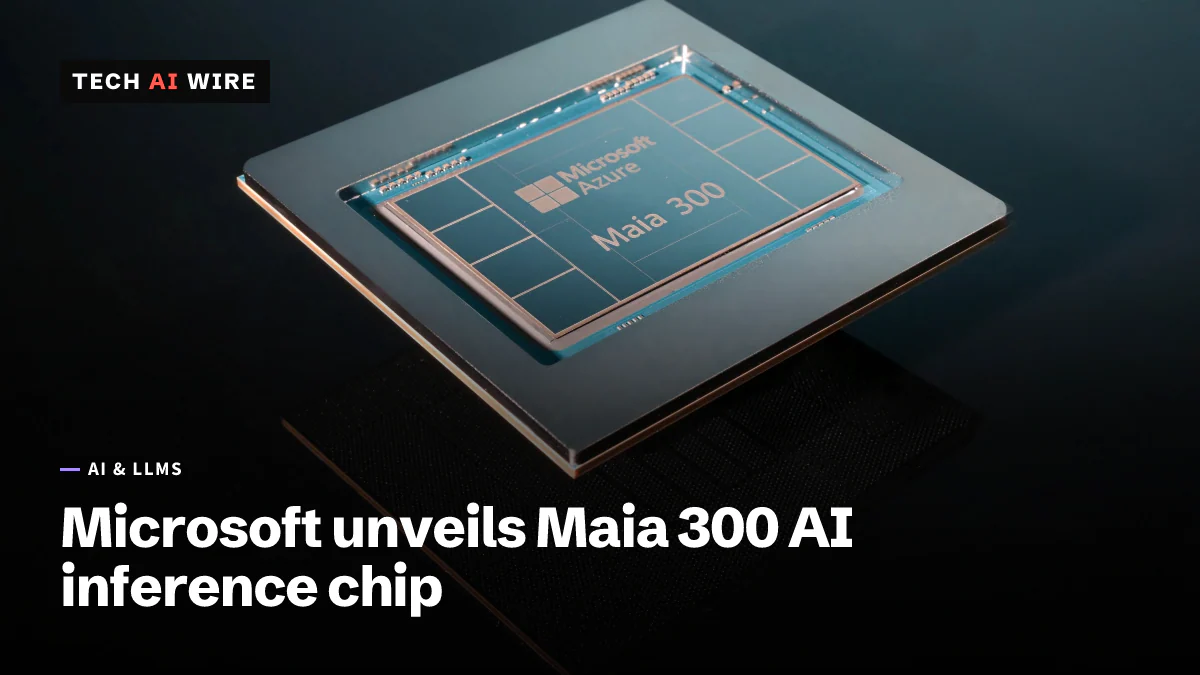
Microsoft(マイクロソフト)は、第3世代のAIチップMaia 300を発表しました。主要なGPUベースのシステムと比べて、ワット当たりのトークン数が40%多くなると見込んでいます。導入は2027年の予定です。
3 分で読めます
数字で見る
- more tokens per watt than leading GPU-based systems, Microsoft expects
- 40%
- of HBM4 memory per chip
- 288 GB
- rack-scale token throughput of Maia 200, at most
- 7x
- planned production deployment, per Data Center Knowledge
- 2027
Microsoftは、自社製AIチップの第3世代となるMaia 300を発表しました。AIモデルを訓練するためではなく、動かすためのチップです。Microsoftは、主要なGPUベースのシステムと比べて、ワット当たりのトークン数が40%多くなると見込んでいます。トークンとは、モデルが読み書きするテキストの小さなかたまりです。つまりこの数字は、チップが使う電力に対して、どれだけのAIの出力を生むかを表します。このチップは、CopilotやGitHub Copilotなど、Microsoftがすでに運営しているサービスを対象にしています。
Microsoftの発表内容
Microsoftは、2026年10月12日付と10月13日付の2本のAzureブログ記事で、このチップを説明しました。技術的な詳細解説によると、Maia 300は推論のために作られています。推論とは、訓練済みのモデルを動かして、リクエストに答える処理のことです。対象は、ロングコンテキスト、リーズニング、エージェント型のワークロードです。こうした処理では、モデルが長い回答を1ステップずつ書いていきます。
Microsoftによると、チップの中身は次のとおりです。
| 部分 | 詳細 |
|---|---|
| 演算ダイ | TSMCのN2Pプロセスで製造 |
| メモリとI/O | 別々のダイに配置 |
| メモリ | HBM4スタック8個、合計288GB |
| メモリ帯域幅 | 18TB/s |
| ラック | 4個入りのトレイ24枚に96チップ、消費電力は167kW |
| 冷却 | 液冷でラックの熱の80%超を取り除く |
| 最大クラスター | 最大128ラックにわたり、最大1万2,288チップ |
| ネットワーク | Ethernet上に構築した独自のAI向けトランスポート |
HBM4は、チップのすぐ隣に積み重ねて置く高速メモリの一種です。推論では、大容量のメモリが重要です。モデルと長い会話のデータを、演算部の近くに置いておく必要があるためです。
Maia 200との比較
Data Center Knowledgeによると、前世代のMaia 200はすでに本番稼働しており、Copilotを動かしています。Microsoftは、Maia 200を米国、欧州、オーストラリアで導入中だとしています。
Microsoftは、Maia 200と比べたMaia 300の向上点を次のように挙げています。
- メモリ帯域幅: 2.5倍。
- メモリ容量: 33%増。
- 演算性能: FLOPsが36%増。FLOPsは、純粋な計算速度を示す指標です。
- チップ間帯域幅: 14%増。
- ラックの出力: 96チップを積んだフル構成のラックで、トークンのスループットが最大7倍。
- 密度: ラック当たりのチップ数が2倍。
効率についての主張
Microsoftは10月13日の記事で、「Maia 300は、主要なGPUベースのシステムと比べて、ワット当たりのトークン数が40%多くなると見込んでいます」と述べています。これは見通しです。どちらの記事も、Microsoftが比較したGPUシステムの名前を挙げていません。
Microsoftは、旧世代のチップについても同様の主張をしています。Teams、Copilot、CoworkのAI機能では、Maia 200のワット当たりのトークン数が、主要なGPUインフラの最大1.7倍だとしています。
Data Center Knowledgeによると、Microsoftは今もNvidiaとAMDのGPUに大きく頼っています。AmazonとGoogleも、自社のAIチップを作っています。8月には、OpenAIが、自社のJalapeñoチップはワット当たりでNvidiaのGB300を上回ると発表しました。これも自社の数字に基づくものです。
登場の時期
Data Center Knowledgeによると、Microsoftは2027年にMaia 300を本番投入する計画です。導入の規模は数ギガワットに及びます。Microsoftは、このチップが想定するワークロードとして、Microsoft Copilot、GitHub Copilot、Microsoft Foundryなどを挙げています。Microsoftは、2026年11月17日から20日に開くIgniteカンファレンスで、さらに詳しい情報を明らかにするとしています。
同メディアによると、Maiaチップは、顧客が自社のワークロードをAzureのインスタンスで動かす用途には提供されていません。これが変わるかどうかについて、Microsoftの記事は触れていません。
Moor Insights & StrategyのアナリストであるMatt Kimball氏は、Data Center Knowledgeに「Maia 100は概念実証でした」と語りました。Kimball氏は新しいチップについて、「世界中で同社のワークロードを支えるために、非常に幅広く使われるでしょう」と述べました。
開発者にとっての意味
AzureやMicrosoftのAIサービスで開発するチームにとっての意味は次のとおりです。
- 直接借りることはできません。 Maiaが動かすのはMicrosoft自身のサービスで、あなたの仮想マシンではありません。Azure上のGPU容量は、これまでどおりに計画しましょう。
- Maiaが動かすサービスに注目しましょう。 名前が挙がっているのは、Copilot、GitHub Copilot、Foundryです。MaiaでMicrosoftのトークン当たりのコストが下がるなら、2027年のこれらのサービスの料金やレート制限の変化に注目しましょう。
- 重点はロングコンテキストの処理です。 チップ1個当たり288GBのメモリを積むこの設計は、長いプロンプトや、多くのステップを実行するエージェントに向いています。推論のコストが最も速く増えるのは、こうした処理です。
- 40%はベンダーの数字として扱いましょう。 比較対象のシステムは明らかにされていません。Maiaを使うサービスが始まったら、トラフィックを移す前に、自分たちのワークロードで試しましょう。
- 11月のIgniteを確認しましょう。 Microsoftはそこで、さらに詳しい情報を出すと約束しています。チップを使える対象に変更があれば、その点も含まれます。
出典
- Deep dive into Azure Maia 300 architecture - Microsoft Azure Blog
- Infrastructure for the frontier era: Scaling intelligence through open industry collaboration - Microsoft Azure Blog
- Microsoft Pushes Custom AI Chips with Azure Maia 300 - Data Center Knowledge
関連記事
Microsoft-Decision-1、テキストを書かずに選択肢を採点するモデル
Microsoft(マイクロソフト)のMicrosoft-Decision-1は、テキストを書く代わりに、決められた選択肢ごとに確率を返します。Microsoft Foundryでの料金は、入力100万トークン当たり0.042ドルです。
OpenAI、自社チップJalapeñoはワット当たりでNvidiaのGB300を上回ると主張
OpenAIが初めて公開したJalapeñoのベンチマークは、NvidiaのGB300に対してキロワット当たり1.5倍から1.9倍の処理を半分の電力で行うと主張する。数字はOpenAI自身のものだ。