Chip Maia 300 da Microsoft mira 40% mais tokens por watt
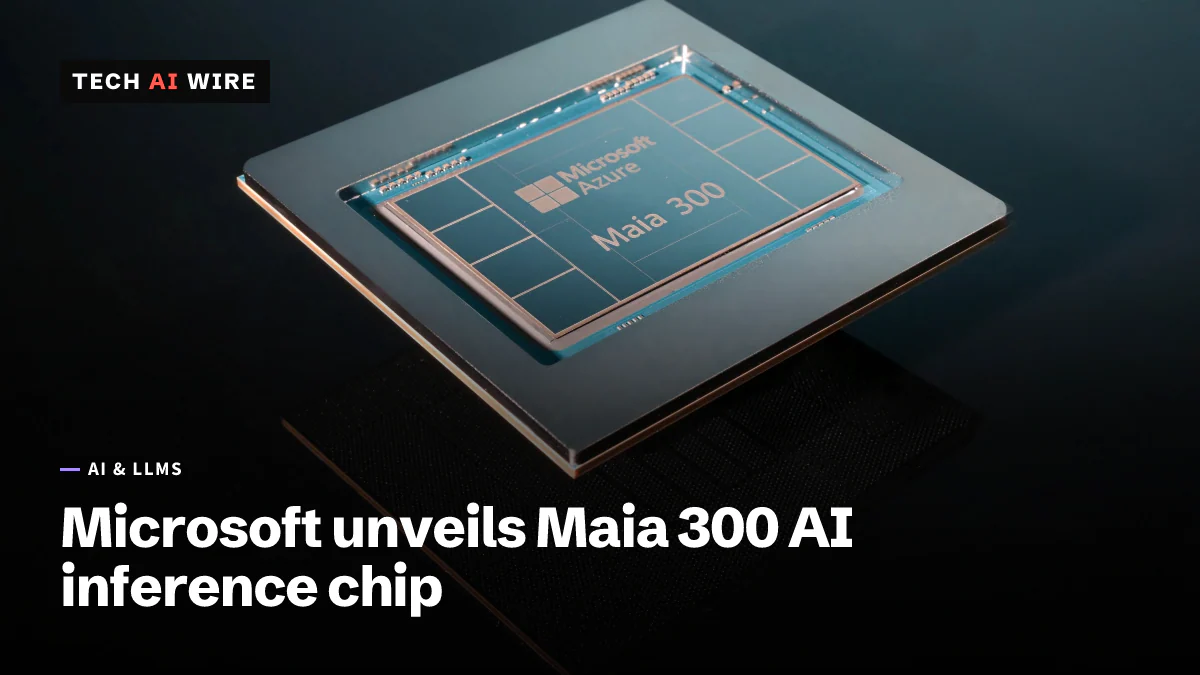
A Microsoft apresentou o Maia 300, seu chip de IA de terceira geração. A empresa espera 40% mais tokens por watt que os principais sistemas baseados em GPU, com implantações em 2027.
3 min de leitura
Em números
- more tokens per watt than leading GPU-based systems, Microsoft expects
- 40%
- of HBM4 memory per chip
- 288 GB
- rack-scale token throughput of Maia 200, at most
- 7x
- planned production deployment, per Data Center Knowledge
- 2027
A Microsoft apresentou o Maia 300, a terceira geração do seu próprio chip de IA, feito para rodar modelos de IA, e não para treiná-los. A Microsoft espera que o chip entregue 40% mais tokens por watt que os principais sistemas baseados em GPU. Um token é um pequeno pedaço de texto que um modelo lê ou escreve. Por isso, o número mede quanta saída de IA o chip gera para a energia que consome. O chip é voltado para os serviços que a Microsoft já opera, incluindo o Copilot e o GitHub Copilot.
O que a Microsoft anunciou
A Microsoft descreveu o chip em dois posts no blog do Azure, datados de 12 e 13 de outubro de 2026. A análise técnica detalhada da empresa diz que o Maia 300 foi feito para inferência, o trabalho de rodar um modelo treinado para responder a pedidos. O chip mira cargas de trabalho de contexto longo, de raciocínio e agênticas, em que um modelo escreve respostas longas um passo de cada vez.
Isto é o que a Microsoft diz que há dentro do chip:
| Parte | Detalhe |
|---|---|
| Dies de computação | Fabricados no processo N2P da TSMC |
| Memória e I/O | Em dies separados |
| Memória | Oito pilhas de HBM4, 288 GB no total |
| Largura de banda da memória | 18 TB/s |
| Rack | 96 chips em 24 bandejas de quatro, com consumo de 167 kW |
| Refrigeração | A refrigeração líquida remove mais de 80% do calor do rack |
| Maior cluster | Até 12.288 chips em até 128 racks |
| Rede | Um transporte de IA personalizado construído sobre Ethernet |
HBM4 é um tipo de memória rápida empilhada ao lado do chip. Muita memória é importante para a inferência porque o modelo e suas conversas longas precisam ficar perto da computação.
Como se compara ao Maia 200
O Maia 200, o chip anterior, já está em produção e roda o Copilot, informa a Data Center Knowledge. A Microsoft diz que o Maia 200 está sendo implantado nos EUA, na Europa e na Austrália.
Em relação ao Maia 200, a Microsoft lista estes ganhos para o Maia 300:
- Largura de banda da memória: 2,5 vezes maior.
- Capacidade de memória: 33% a mais.
- Computação: 36% mais FLOPs, uma medida da velocidade bruta de cálculo.
- Largura de banda entre chips: 14% a mais.
- Produção do rack: até 7 vezes a vazão de tokens em um rack completo de 96 chips.
- Densidade: o dobro de chips por rack.
A promessa de eficiência
“Esperamos que o Maia 300 entregue 40% mais tokens por watt em comparação com os principais sistemas baseados em GPU”, diz o post da Microsoft de 13 de outubro. É uma projeção. Os posts não dizem com quais sistemas de GPU a Microsoft fez a comparação.
A Microsoft faz uma afirmação parecida sobre o chip mais antigo. A empresa diz que o Maia 200 entrega até 1,7 vez mais tokens por watt que a principal infraestrutura de GPU nos recursos de IA do Teams, do Copilot e do Cowork.
A Microsoft ainda depende muito das GPUs da Nvidia e da AMD, observa a Data Center Knowledge. A Amazon e o Google também fazem seus próprios chips de IA. Em agosto, a OpenAI disse que seu chip Jalapeño supera o GB300 da Nvidia por watt, também com base nos próprios números.
Quando chega
A Microsoft planeja colocar o Maia 300 em produção em 2027, com implantações em escala de vários gigawatts, informa a Data Center Knowledge. A Microsoft cita o Microsoft Copilot, o GitHub Copilot e o Microsoft Foundry entre as cargas de trabalho para as quais o chip foi projetado. A Microsoft diz que vai divulgar mais detalhes na sua conferência Ignite, de 17 a 20 de novembro de 2026.
Os chips Maia não estão disponíveis para as cargas de trabalho dos próprios clientes em instâncias do Azure, observa o veículo. Os posts da Microsoft não disseram se isso vai mudar.
“O Maia 100 foi uma prova de conceito”, disse Matt Kimball, analista da Moor Insights & Strategy, à Data Center Knowledge. Sobre o novo chip, Kimball disse: “Vai ser usado de forma muito ampla para dar suporte às suas cargas de trabalho no mundo todo.”
O que isso significa para desenvolvedores
Para equipes que desenvolvem no Azure ou nos serviços de IA da Microsoft:
- Você não pode alugar o chip diretamente. O Maia roda os serviços da própria Microsoft, não as suas máquinas virtuais. Planeje a capacidade de GPU no Azure como antes.
- Fique de olho nos serviços que o chip vai alimentar. O Copilot, o GitHub Copilot e o Foundry são os alvos citados. Se o Maia reduzir o custo por token da Microsoft, observe mudanças nos preços e nos limites de requisições desses serviços em 2027.
- O foco é o trabalho com contexto longo. Com 288 GB de memória por chip, o projeto favorece prompts longos e agentes que executam muitos passos. São essas as tarefas em que os custos de inferência crescem mais rápido.
- Trate os 40% como um número do fabricante. Nenhum sistema de comparação é citado. Quando os serviços com Maia forem lançados, teste-os nas suas próprias cargas de trabalho antes de migrar o tráfego.
- Acompanhe o Ignite em novembro. A Microsoft prometeu mais detalhes lá, incluindo qualquer mudança sobre quem pode usar o chip.
Fontes
- Deep dive into Azure Maia 300 architecture - Microsoft Azure Blog
- Infrastructure for the frontier era: Scaling intelligence through open industry collaboration - Microsoft Azure Blog
- Microsoft Pushes Custom AI Chips with Azure Maia 300 - Data Center Knowledge
Artigos relacionados
Microsoft-Decision-1 pontua opções em vez de escrever texto
O Microsoft-Decision-1 retorna uma probabilidade para cada opção fixa em vez de escrever texto. Custa US$ 0,042 por milhão de tokens de entrada no Microsoft Foundry.
OpenAI diz que seu chip Jalapeño supera o GB300 da Nvidia por watt
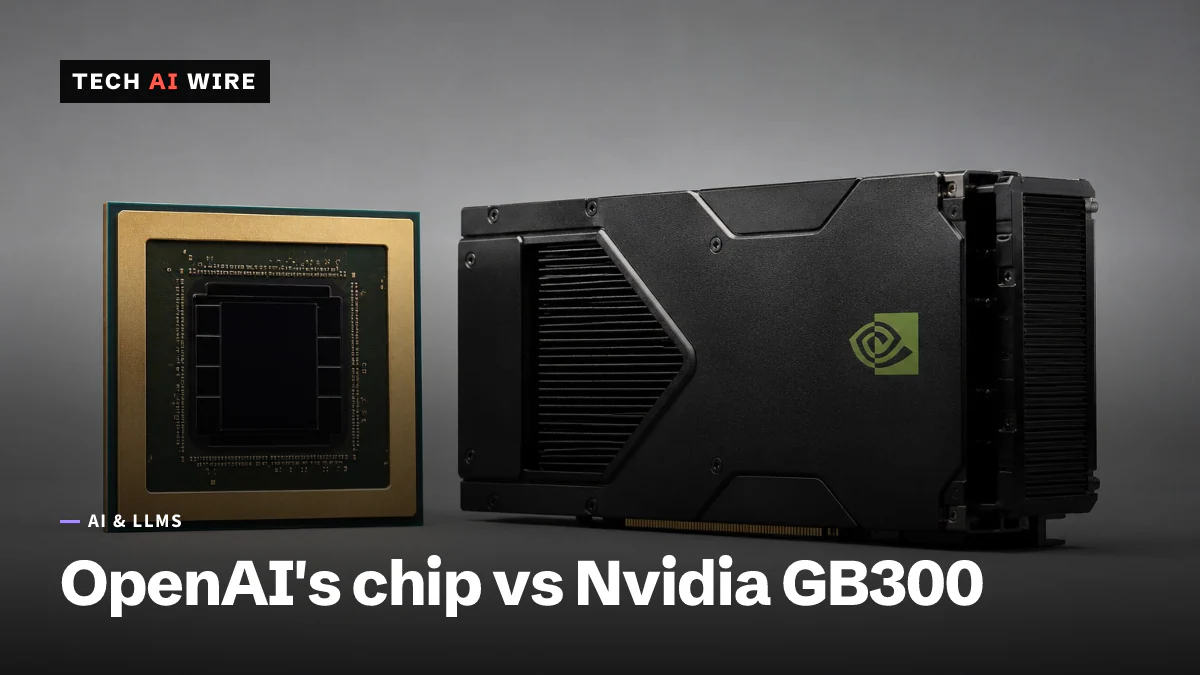
Os primeiros benchmarks publicados do Jalapeño, da OpenAI, alegam 1,5 a 1,9 vezes mais trabalho por quilowatt que o GB300 da Nvidia, com metade da energia. Os números são da própria OpenAI.
O chip de inferência Groq 3 LPX da Nvidia entra em produção plena
A Nvidia colocou seu acelerador de inferência dedicado em produção plena: as GPUs cuidam do contexto e os chips novos, da geração de tokens.