OpenAI sagt, sein Jalapeño-Chip schlägt Nvidias GB300 pro Watt
OpenAIs erste veröffentlichte Jalapeño-Benchmarks beanspruchen 1,5- bis 1,9-mal mehr Arbeit pro Kilowatt als Nvidias GB300, bei halber Leistungsaufnahme. Die Zahlen stammen von OpenAI selbst.
4 Min. Lesezeit
Die Zahlen
- more throughput per kilowatt, per OpenAI
- 1.5-1.9x
- lower end-to-end latency at the top of the range
- 3.6x
- HBM4 memory on each chip
- 216 GB
- from first design to tape-out
- 9 months
- OpenAI Jalapeño
- 700W
- Nvidia GB300
- 1400W
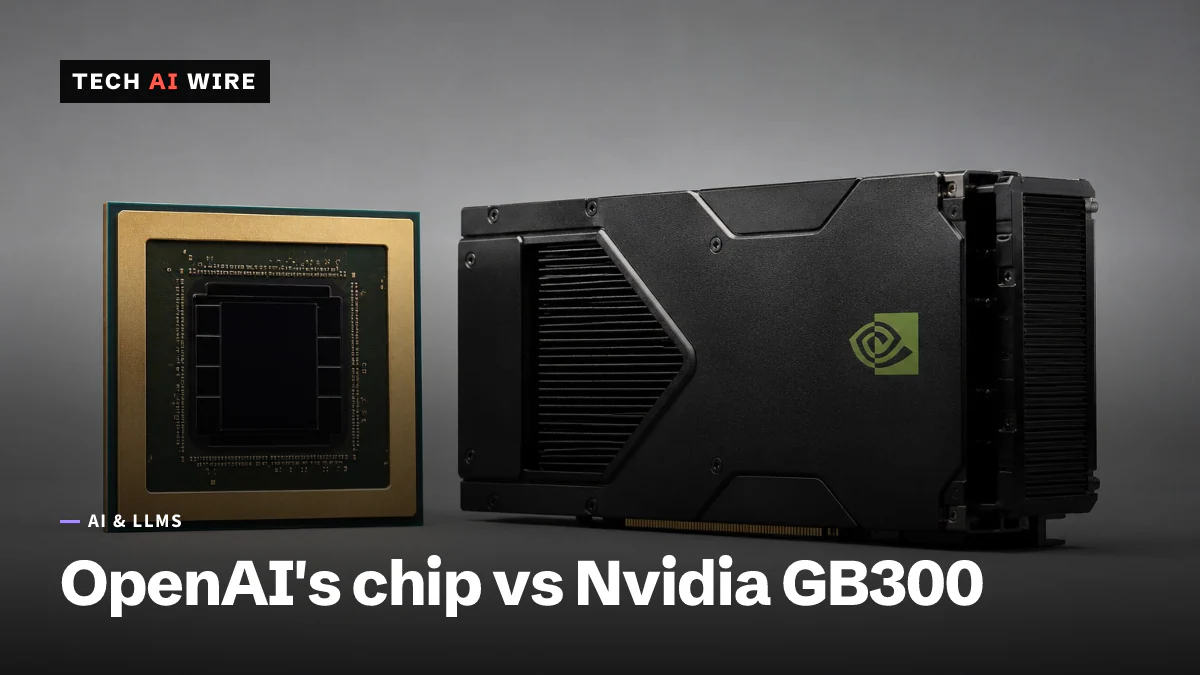
OpenAI hat die ersten Benchmarks für Jalapeño veröffentlicht, den Inferenz-Chip, den es mit Broadcom gebaut hat, und sagt, er schlage Nvidias Flaggschiff. The Register und TechCrunch berichteten die Zahlen am 25. August 2026. OpenAI beansprucht 1,5- bis 1,9-mal mehr KI-Arbeit pro Kilowatt als konkurrierende Systeme und 1,7- bis 3,6-mal geringere Latenz. Der Chip ist für die halbe Leistungsaufnahme von Nvidias GB300 ausgelegt. Wenn die Zahlen außerhalb von OpenAIs eigenen Tests halten, haben die Kosten für das Bereitstellen eines Modells gerade einen zweiten Lieferanten bekommen.
Inferenz ist die Arbeit, ein trainiertes Modell auszuführen, um Anfragen zu beantworten, im Gegensatz zum Training. Dort geht der größte Teil des Stroms in einem KI-Produkt hin, sobald das Produkt Nutzer hat. Ein Chip, der mehr Inferenz pro Watt leistet, kürzt den größten Posten auf der Rechnung.
Die Zahlen, die OpenAI veröffentlicht hat
Tom's Hardware berichtet, Jalapeño sei mit 700 Watt spezifiziert, gegenüber 1.400 Watt für Nvidias GB300. Auf dieser Basis beansprucht OpenAI bis zu 1,9-mal den Durchsatz pro Kilowatt. The Register ergänzt, für Arbeit mit extrem niedriger Latenz steige der Vorteil auf 2,1- bis 4,1-mal, und schätzt den Stromverbrauch des Chips auf 40 % bis 60 % konkurrierender GPU-Systeme.
Die Spezifikationen des einzelnen Chips, laut The Register:
| Kennzahl | Jalapeño |
|---|---|
| Rechenleistung bei MXFP4 | 13,4 PetaFLOPS |
| Speicher | 216 GB HBM4 |
| Speicherbandbreite | 15,4 TB/s |
| Nennleistung | 700 W |
MXFP4 ist ein 4-Bit-Zahlenformat, das Gewichte dicht packt, sodass mehr vom Modell in den schnellen Speicher passt. HBM4 ist High-Bandwidth-Speicher, der gestapelte Speicher, der neben dem Chip sitzt. Ein volles Rack mit 128 Chips erreicht 1,7 ExaFLOPS an 4-Bit-Rechenleistung, 27,5 TB Speicher und fast 2 Petabyte pro Sekunde Bandbreite.
Wie er die Geschwindigkeit erreicht
Die Designwette lautet: weniger Daten bewegen. Richard Ho, OpenAIs Hardware-Chef, sagte TechCrunch: „Wir haben Jalapeño entworfen, um Datenbewegung und Kommunikationsverzögerungen zu minimieren." The Register berichtet von einem großen SRAM-Cache auf dem Chip und sorgfältiger Platzierung des KV cache, des Speichers vergangener Tokens, den ein Modell bei jedem Schritt konsultiert.
Das ist wichtig, weil Inferenz zwei Phasen hat. Prefill liest den ganzen Prompt auf einmal, und Decode erzeugt die Antwort Token für Token. Decode ist der langsame Teil, und er ist dadurch begrenzt, wie schnell der Chip abrufen kann, was er schon weiß. Diese Daten nah zu halten, ist das, was die Latenzzahlen widerspiegeln.
Der Chip wurde auch ungewöhnlich schnell gebaut. The Register berichtet von 9 Monaten vom ersten Entwurf bis zum Tape-out, dem Punkt, an dem ein Design für die Fertigung eingefroren wird. Das Blatt beschreibt ihn als „(teilweise) von KI entworfen, für KI". TechCrunch bestätigt, dass OpenAIs eigene Modelle beim Design geholfen haben.
Wann Sie ihn tatsächlich nutzen könnten
Nicht bald. TechCrunch berichtet, OpenAI erwarte, Jalapeño Ende 2026 in „sehr kleinen Stückzahlen" einzusetzen, mit breiterem Einsatz 2027. Das Projekt wurde erstmals im Oktober 2025 angekündigt, und TechCrunch beschreibt es als Plattform über mehrere Generationen, dies ist also der erste Chip einer Reihe.
Ho war direkt dabei, was die Ergebnisse seiner Ansicht nach bedeuten. „Unterm Strich zeigen die Ergebnisse einen sehr, sehr bedeutenden Leistungsfortschritt gegenüber dem Stand der Technik", sagte er TechCrunch. Er fügte hinzu, Jalapeño „kann mehr KI-Arbeit pro Energieeinheit leisten und gleichzeitig Antworten schneller zurückgeben".
Was das für Entwickler bedeutet
Lesen Sie jede Zahl mit einem Fakt vor Augen: Die Zahlen stammen von OpenAI. Kein unabhängiges Labor hat sie bisher reproduziert, und der Vergleich erfolgt gegen Nvidias veröffentlichte Nennleistung. Der erste Benchmark eines Anbieters für seinen eigenen Chip ist eine Behauptung, keine Messung. Behandeln Sie ihn als Grund zum Beobachten, nicht als Grund zum Umplanen.
Wenn Sie Inferenz in großem Maßstab betreiben, ist die Kennzahl zum Übernehmen Arbeit pro Kilowatt. Die meisten Teams budgetieren noch nach GPU-Anzahl. Strom ist die Beschränkung, die ein Rechenzentrum tatsächlich begrenzt, und es ist die Achse, auf der OpenAI kämpfen will. Beginnen Sie jetzt, Tokens pro Kilowattstunde für Ihre eigene Arbeitslast zu erfassen, damit Sie jeden Chip bewerten können, auch diesen, wenn er ausgeliefert wird.
Sie werden keinen Jalapeño kaufen. Die Berichte beschreiben einen Chip für OpenAIs eigene Flotte, zunächst in kleinen Stückzahlen. Er erreicht Sie über OpenAIs API-Preise und -Latenz, frühestens 2027. Wenn Ihr Produkt von schnellem Decode abhängt, beobachten Sie nächstes Jahr OpenAIs Latenzzahlen pro Token für das erste echte Signal.
Das Tape-out nach neun Monaten ist der Teil, den man sich merken sollte. Ein Frontier-Labor hat in unter einem Jahr einen konkurrenzfähigen Inferenz-Chip entworfen, mit Hilfe seiner eigenen Modelle. Wenn das hält, ist kundenspezifisches Silizium keine Fünfjahreswette mehr, die nur die größten Unternehmen eingehen können. Die verteidigungsfähige Position für Nvidia wird Software und Lieferfähigkeit, nicht rohe Effizienz.
Quellen
Ähnliche Artikel
Nvidias Inferenz-Chip Groq 3 LPX geht in die Serienproduktion
Nvidia hat seinen dedizierten Inferenz-Beschleuniger in die Serienproduktion gebracht: GPUs übernehmen den Kontext, die neuen Chips die Token-Erzeugung.
Fujitsu MONAKA bringt 144 Armv9-Kerne im November
Fujitsus 144-Kern-MONAKA kommt im November in den Verkauf, mit 2nm-Kernen über 5nm-Cache und Unterstützung, die in GCC 15 schon upstream ist.
OpenAI Agents API bekommt Computer Use in einem gehosteten Browser
OpenAIs Agents API, seit dem 10. September in der öffentlichen Beta, erhielt auf dem DevDay am 29. September 2026 Computer Use: Agenten steuern jetzt einen von OpenAI gehosteten Browser.