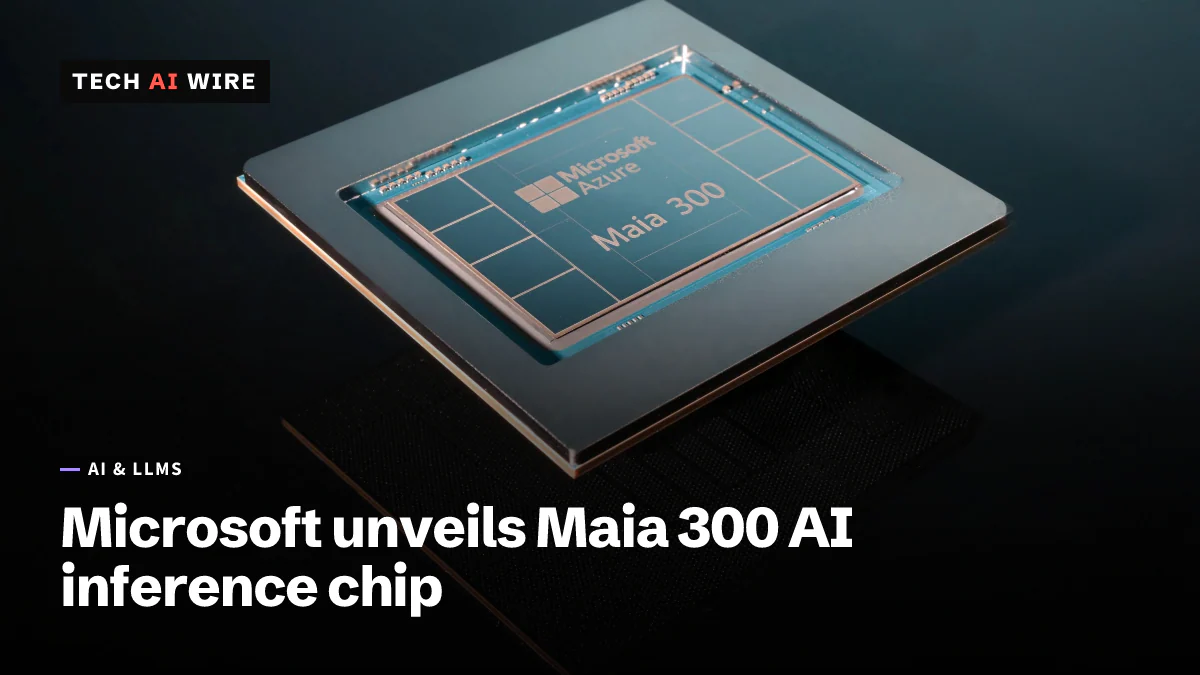
El chip Maia 300 de Microsoft apunta a un 40 % más de tokens por vatio
Microsoft presentó Maia 300, su chip de IA de tercera generación. Prevé un 40 % más de tokens por vatio que los principales sistemas basados en GPU, con despliegues en 2027.
3 min de lectura
En cifras
- more tokens per watt than leading GPU-based systems, Microsoft expects
- 40%
- of HBM4 memory per chip
- 288 GB
- rack-scale token throughput of Maia 200, at most
- 7x
- planned production deployment, per Data Center Knowledge
- 2027
Microsoft ha presentado Maia 300, la tercera generación de su propio chip de IA, diseñado para ejecutar modelos de IA y no para entrenarlos. Microsoft prevé que ofrezca un 40 % más de tokens por vatio que los principales sistemas basados en GPU. Un token es un pequeño fragmento de texto que un modelo lee o escribe. Así, la cifra mide cuánta salida de IA da el chip por la energía que consume. El chip está pensado para los servicios que Microsoft ya gestiona, entre ellos Copilot y GitHub Copilot.
Lo que anunció Microsoft
Microsoft describió el chip en dos entradas del blog de Azure fechadas el 12 y el 13 de octubre de 2026. Su análisis técnico en profundidad indica que Maia 300 está diseñado para la inferencia. Es el trabajo de ejecutar un modelo ya entrenado para responder a peticiones. Se dirige a cargas de trabajo de contexto largo, de razonamiento y agénticas, en las que un modelo escribe respuestas largas paso a paso.
Esto es lo que, según Microsoft, hay dentro:
| Parte | Detalle |
|---|---|
| Dies de cómputo | Fabricados con el proceso N2P de TSMC |
| Memoria y E/S | En dies separados |
| Memoria | Ocho pilas HBM4, 288 GB en total |
| Ancho de banda de memoria | 18 TB/s |
| Rack | 96 chips en 24 bandejas de cuatro, con un consumo de 167 kW |
| Refrigeración | La refrigeración líquida elimina más del 80 % del calor del rack |
| Clúster más grande | Hasta 12.288 chips en hasta 128 racks |
| Red | Un transporte de IA a medida basado en Ethernet |
HBM4 es un tipo de memoria rápida apilada junto al chip. Una memoria grande importa en la inferencia, porque el modelo y sus largas conversaciones deben estar cerca del cómputo.
Cómo se compara con Maia 200
Maia 200, el chip anterior, ya está en producción e impulsa Copilot, informa Data Center Knowledge. Microsoft afirma que Maia 200 se está desplegando en Estados Unidos, Europa y Australia.
Frente a Maia 200, Microsoft enumera estas mejoras de Maia 300:
- Ancho de banda de memoria: 2,5 veces mayor.
- Capacidad de memoria: un 33 % más.
- Cómputo: un 36 % más de FLOPs, una medida de la velocidad de cálculo bruta.
- Ancho de banda entre chips: un 14 % más.
- Rendimiento por rack: hasta 7 veces el rendimiento en tokens en un rack completo de 96 chips.
- Densidad: el doble de chips por rack.
La afirmación sobre la eficiencia
«Esperamos que Maia 300 ofrezca un 40 % más de tokens por vatio frente a los principales sistemas basados en GPU», dice la entrada de Microsoft del 13 de octubre. Es una previsión. Las entradas no indican con qué sistemas de GPU se comparó Microsoft.
Microsoft hace una afirmación similar sobre el chip anterior. Asegura que Maia 200 ofrece hasta 1,7 veces más tokens por vatio que las principales infraestructuras de GPU para las funciones de IA de Teams, Copilot y Cowork.
Microsoft sigue dependiendo en gran medida de las GPU de Nvidia y AMD, señala Data Center Knowledge. Amazon y Google también desarrollan sus propios chips de IA. En agosto, OpenAI afirmó que su chip Jalapeño supera al GB300 de Nvidia por vatio, también según sus propias cifras.
Cuándo llega
Microsoft prevé poner Maia 300 en producción en 2027, con despliegues a escala de varios gigavatios, informa Data Center Knowledge. Microsoft cita Microsoft Copilot, GitHub Copilot y Microsoft Foundry entre las cargas de trabajo para las que está diseñado. Microsoft dice que dará más detalles en su conferencia Ignite, del 17 al 20 de noviembre de 2026.
Los chips Maia no están disponibles para las cargas de trabajo propias de los clientes en instancias de Azure, señala el medio. Las entradas de Microsoft no aclararon si eso cambiará.
«Maia 100 fue una prueba de concepto», dijo a Data Center Knowledge Matt Kimball, analista de Moor Insights & Strategy. Sobre el nuevo chip, Kimball afirmó: «Se va a usar de forma muy amplia para dar soporte a sus cargas de trabajo en todo el mundo».
Qué significa esto para los desarrolladores
Para los equipos que desarrollan sobre Azure o sobre los servicios de IA de Microsoft:
- No puede alquilarlo directamente. Maia ejecuta los servicios propios de Microsoft, no sus máquinas virtuales. Planifique la capacidad de GPU en Azure como hasta ahora.
- Vigile los servicios a los que dará soporte. Copilot, GitHub Copilot y Foundry son los destinos citados. Si Maia reduce el coste por token de Microsoft, esté atento a cambios en sus precios y límites de uso en 2027.
- El foco es el trabajo de contexto largo. Con 288 GB de memoria por chip, el diseño favorece los prompts largos y los agentes que ejecutan muchos pasos. Son las tareas en las que los costes de inferencia crecen más rápido.
- Trate el 40 % como una cifra del proveedor. No se nombra ningún sistema de comparación. Cuando lleguen los servicios basados en Maia, pruébelos con sus propias cargas de trabajo antes de trasladar tráfico.
- Siga Ignite en noviembre. Microsoft ha prometido más detalles allí, incluido cualquier cambio sobre quién puede usar el chip.
Fuentes
- Deep dive into Azure Maia 300 architecture - Microsoft Azure Blog
- Infrastructure for the frontier era: Scaling intelligence through open industry collaboration - Microsoft Azure Blog
- Microsoft Pushes Custom AI Chips with Azure Maia 300 - Data Center Knowledge
Artículos relacionados
Microsoft-Decision-1 puntúa opciones en lugar de escribir texto
Microsoft-Decision-1 devuelve una probabilidad para cada opción fija en lugar de escribir texto. Cuesta 0,042 dólares por millón de tokens de entrada en Microsoft Foundry.
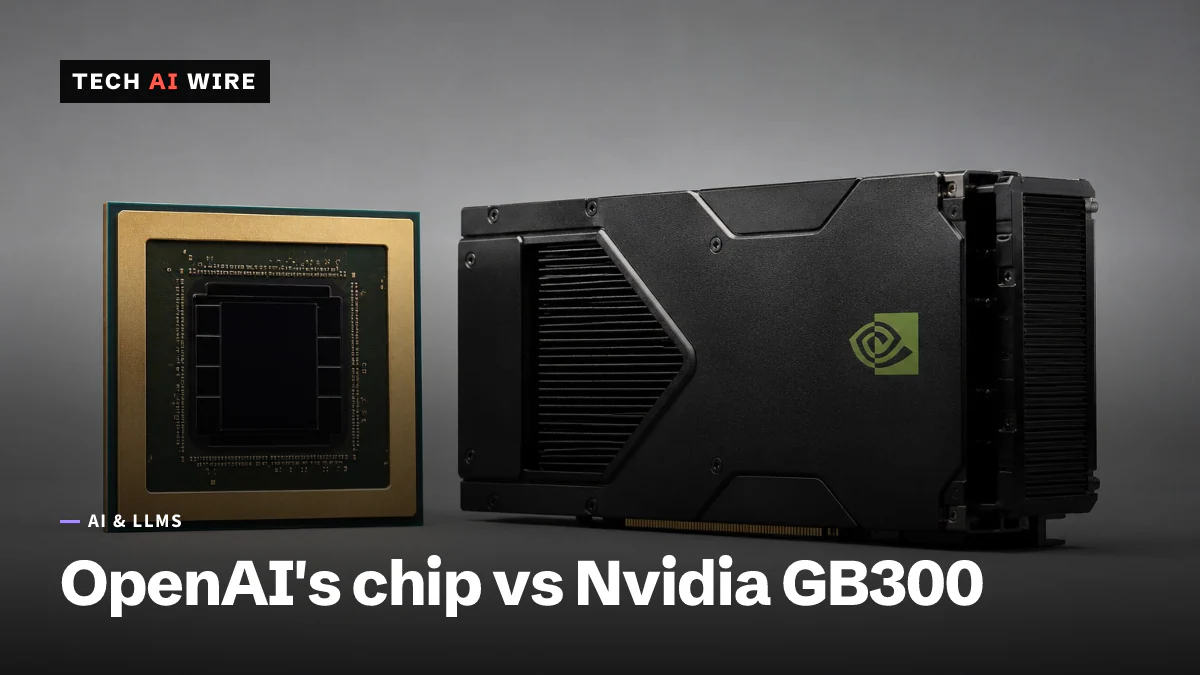
OpenAI dice que su chip Jalapeño supera al GB300 de Nvidia por vatio
Los primeros benchmarks de Jalapeño publicados por OpenAI afirman entre 1,5 y 1,9 veces más trabajo por kilovatio que el GB300 de Nvidia, con la mitad de potencia. Las cifras son de la propia OpenAI.
El chip de inferencia Groq 3 LPX de Nvidia entra en producción
Nvidia pone su acelerador de inferencia dedicado en plena producción: las GPU se ocupan del contexto y los chips nuevos, de generar los tokens.