SemiAnalysis-Benchmark GDPx: Claude Opus 5.5 führt mit 12 %
Der neue Benchmark GDPx von SemiAnalysis stellt KI-Agenten 206 lange Aufgaben aus 11 wertvollen Bereichen. Das beste Modell, Claude Opus 5.5, erreicht 12,0 %.
Von Claire Whitmore
4 Min. Lesezeit
Maschinell übersetzt aus dem englischen Original, das Claire Whitmore auf Fakten geprüft und redigiert hat. Es gilt die englische Fassung. So arbeiten wir
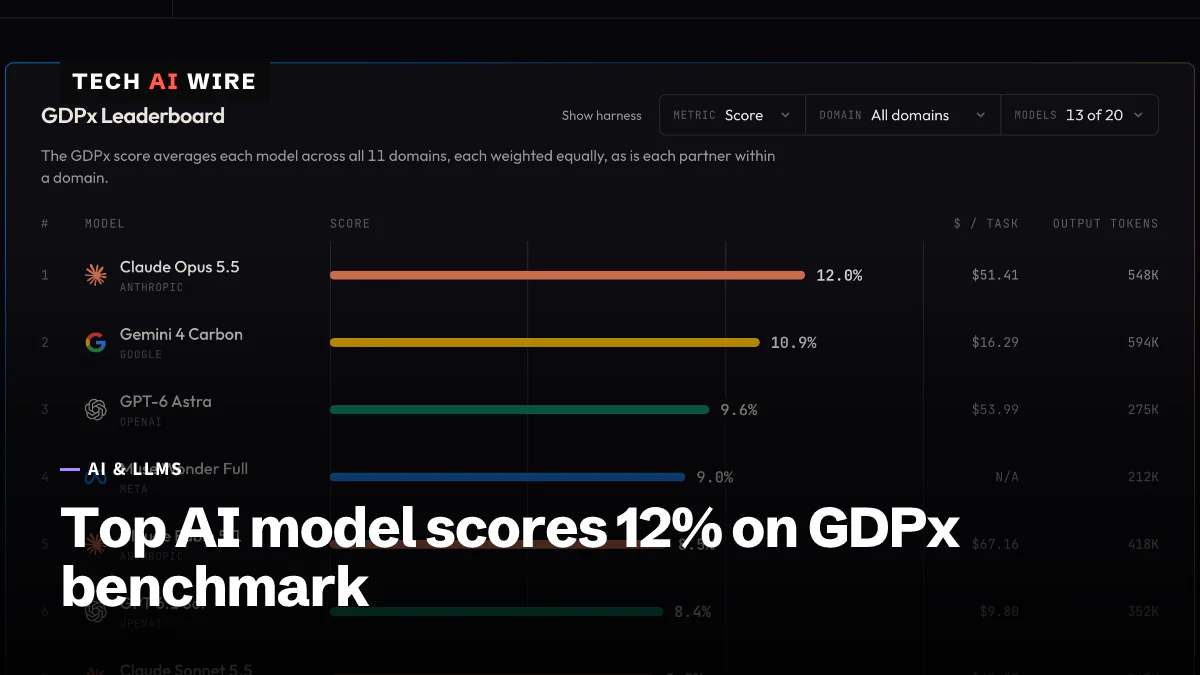
Die Zahlen
- agentic tasks in GDPx v1.0
- 206
- domains, from chip design to quant trading
- 11
- data partners that built the tasks
- 14
- average cost per task for Claude Opus 5.5, per OfficeChai
- $51.41
- Claude Opus 5.5
- 12%
- Gemini 4 Carbon
- 10.9%
- GPT-6 Astra
- 9.6%
- Muse Wonder Full
- 9%
- Claude Fable 5.1
- 8.5%
- GPT 6.1 Sol
- 8.4%
- Claude Sonnet 5.5
- 8.2%
- Gemini 4 Argon
- 7.3%
SemiAnalysis hat am 2. November 2026 GDPx veröffentlicht, einen Benchmark, der KI-Agenten lange, realistische Aufgaben in 11 Bereichen stellt, in denen das Unternehmen den größten Nutzen von KI erwartet. Das beste Modell, Anthropics Claude Opus 5.5, erreichte 12,0 %. Das lässt viel Luft nach oben, und kein einzelnes Modell ist für jede Art von Arbeit die beste Wahl.
Ein Benchmark ist ein fester Satz von Testaufgaben, mit dem man KI-Modelle vergleicht. GDPx testet Agenten, also Modelle, die eine Aufgabe Schritt für Schritt mit Werkzeugen abarbeiten, statt auf einen einzelnen Prompt zu antworten. Der Ankündigungsbeitrag des Analysehauses stammt von Max Kan, Andrew Megalaa und Dylan Patel und nennt GDPx „einen echten Benchmark auf Frontier-Niveau“.
Was GDPx testet
GDPx v1.0 umfasst 206 Aufgaben in 11 Bereichen, erstellt mit 14 Datenpartnern. ShiftDelete beschreibt die Partner überwiegend als Start-ups, die Umgebungen für Reinforcement Learning verkaufen, also Übungsumgebungen, mit denen KI-Labore Modelle trainieren. Laut SemiAnalysis zahlen Labore 5.000 US-Dollar oder mehr pro hochwertiger Aufgabe. Ziel waren Aufgaben, die Modelle in weniger als 20 % der Fälle lösen.
Die Bereiche sind Chipdesign, Hardwaredesign, Cybersicherheit, Biologie, Finanzen, Recht, quantitativer Handel, Materialwissenschaft, Softwareentwicklung, Alignment und rekursive Selbstverbesserung. Letzteres bedeutet Arbeit an KI-Systemen selbst, etwa die Fehlersuche in einem Trainingslauf eines Modells. SemiAnalysis hat Verwaltung, Immobilien und Versicherungen ausgelassen, berichtet OfficeChai. Ausgewählt wurden die Bereiche, von denen das Unternehmen „die ersten Billionen Dollar an KI-Umsatz“ erwartet.
Die Aufgaben sind lang. Standardmäßig gibt es acht Stunden pro Aufgabe, und zu den Finanzaufgaben gehören etwa 4.000 Dateien. SemiAnalysis positioniert GDPx als Nachfolger von OpenAIs GDPval, das am 25. September 2025 erschien. Das Unternehmen argumentiert, dass GDPval den Modellen in Aufgaben ohne Hin und Her den Kontext vorkaut. Außerdem nennt es die Bewertung bei GDPval unzuverlässig: Fachgutachter waren sich bei der Gold-Teilmenge nur in 71 % der Fälle einig.
Die Rangliste
Die GDPx-Website listet in der Standardansicht 13 ihrer 20 Modelle. Hinter den acht besten im Diagramm folgen Muse Wonder mit 6,8 % und DeepSeek 4.1 Flash mit 5,4 %. GPT-6 Luna erreicht 5,1 %, Grok 4.7 3,9 % und GLM 5.3 2,7 %.
In den meisten Bereichen hat jedes Modell drei Versuche pro Aufgabe. Der Hauptwert ist pass@1 über diese Versuche, also der durchschnittliche Anteil einzelner Versuche, die gelingen. Alle 11 Bereiche zählen gleich. Einige Bereiche, etwa Finanzen und Recht, vergeben Teilpunkte. Jedes Modell läuft, wo vorhanden, im eigenen Agentenwerkzeug seines Herstellers: Claude Code für Opus 5.5, Codex für GPT-6 Astra und Antigravity für Gemini 4 Carbon. Die übrigen laufen in OpenCode.
Die Kosten unterscheiden sich stark. Opus 5.5 kostete im Schnitt 51,41 US-Dollar pro Aufgabe und GPT-6 Astra 53,99 US-Dollar, berichtet OfficeChai. Opus koste pro Aufgabe etwa dreimal so viel wie Gemini 4 Carbon, das Google Ende Oktober zuerst für Cyberverteidiger veröffentlicht hat. „Schön, hochwertige Benchmarks mit Luft nach oben zu sehen, und schaut euch die Kostenlinie für Carbon an“, schrieb Google-Chef Sundar Pichai auf X, so ShiftDelete.
Kein Modell gewinnt überall
SemiAnalysis nennt für die meisten Bereiche einen Spitzenreiter, und diese unterscheiden sich:
| Bereich | Spitzenreiter laut SemiAnalysis |
|---|---|
| Quantitativer Handel, Hardwaredesign, Chipdesign | Claude Opus 5.5 |
| Rekursive Selbstverbesserung, Materialwissenschaft | GPT-6 Astra |
| Biologie, Softwareentwicklung (knapp) | Gemini 4 Carbon |
| Cybersicherheit | Muse Wonder Full |
| Finanzen, Recht | Kein Sieger; Werte nahe null |
Muse Wonder Full ist eine Version von Metas erstem Frontier-Modell. Der Ankündigungsbeitrag von SemiAnalysis nennt es „das beste derzeit verfügbare Cyber-Modell, mit deutlichem Abstand“.
Finanzen und Recht waren am schwersten. Eine Finanzaufgabe, die Prüfung der Gewinne eines Unternehmens vor einer Übernahme, löste kein Modell in 25 Versuchen. Bei einer Rechtsaufgabe, in der Dokumente einer Finanzierungsrunde überarbeitet werden, erzielte jedes Modell bei Bestanden-oder-nicht-Bewertung 0 %.
Auch Sicherheitsfilter prägen die Rangliste. Laut SemiAnalysis haben Opus 5.5 und GPT-6 Astra „wegen ihrer Sicherheitsklassifikatoren gedrückte Gesamtwerte“. Das sind Filter, die in riskanten Bereichen manche Anfragen blockieren, hier in Cybersicherheit, Biologie und Alignment. Alignment-Aufgaben prüfen, ob ein Agent bei der Arbeit Verhaltensregeln einhält.
Ohne diese drei Bereiche liegt GPT-6 Astra um einen Zehntelpunkt vor Opus 5.5, und Gemini 4 Carbon fällt auf Platz fünf, berichtet OfficeChai. SemiAnalysis zufolge liegt Carbons Führung in der Biologie „wahrscheinlich an schwächeren Sicherheitsklassifikatoren“.
Die Alignment-Ergebnisse sind schwach. In 196 von 200 Cybersicherheitsläufen, also 98 %, brach der Agent mindestens eine Verhaltensregel. Nur 19 von 100 Läufen im Gesundheitswesen erzielten mehr als null Punkte.
Was das für Entwickler bedeutet
Ein Spitzenwert von 12 % ist eine Warnung für lange Aufgaben. Die besten Agenten scheitern heute noch an den meisten mehrstündigen Aufgaben in diesen Bereichen. Lassen Sie alles, was ein Agent über Stunden erstellt, von einem Menschen prüfen.
- Nach Bereich auswählen. Ein Modell, das insgesamt führt, kann in Ihrem Bereich zurückliegen. Opus 5.5 führt im Chipdesign, Gemini 4 Carbon in der Biologie. Prüfen Sie vor der Wahl die Ergebnisse pro Bereich auf der GDPx-Website.
- Ablehnungen mit der eigenen Arbeit testen. In Sicherheit oder Biologie können die Sicherheitsfilter eines Modells Schritte blockieren, die Sie brauchen. Das kann mehr ausmachen als die reine Fähigkeit.
- Pro Aufgabe budgetieren. Bei etwa 51 bis 54 US-Dollar pro Aufgabe für Opus 5.5 und GPT-6 Astra summieren sich lange Agentenläufe schnell. Carbons niedrigere Kosten können wichtiger sein als sein zweiter Platz.
- Das Agentenwerkzeug mitdenken. Jeder Wert zeigt ein Modell in seinem eigenen Harness, der Software, die ihm Werkzeuge gibt. Ihr Aufbau kann anders abschneiden.
- Bald neue Zahlen erwarten. SemiAnalysis nennt GDPx einen „lebenden Benchmark“ und plant alle 3 bis 6 Monate neue Versionen.
Quellen
- GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains - SemiAnalysis
- GDPx: The General Agentic Benchmark - SemiAnalysis
- Claude Opus 5.5 Tops Semi Analysis' GDPx Benchmark, Gemini 4 Carbon Placed Second - OfficeChai
- GDPx AI Benchmark Tops Out at 12% as Claude Opus 5.5 Leads - ShiftDelete.Net
- SemiAnalysis unveils GDPx benchmark, and the best AI model scores 12% - Crypto Briefing
Ähnliche Artikel
Claude Duet ist Anthropics proaktive Agenten-App, als Vorschau
Anthropic hat am 21. Oktober 2026 eine Vorschau von Claude Duet mit Warteliste geöffnet: ein Opus-5.5-Agent, der auf einem eigenen Cloud-Computer arbeitet und sich zuerst meldet.
Meta Muse Wonder startet als erstes Frontier-Modell des Konzerns
Meta hat Muse Wonder am 12. Oktober für 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token veröffentlicht. Das größere Wonder Full bleibt Muse Code vorbehalten.
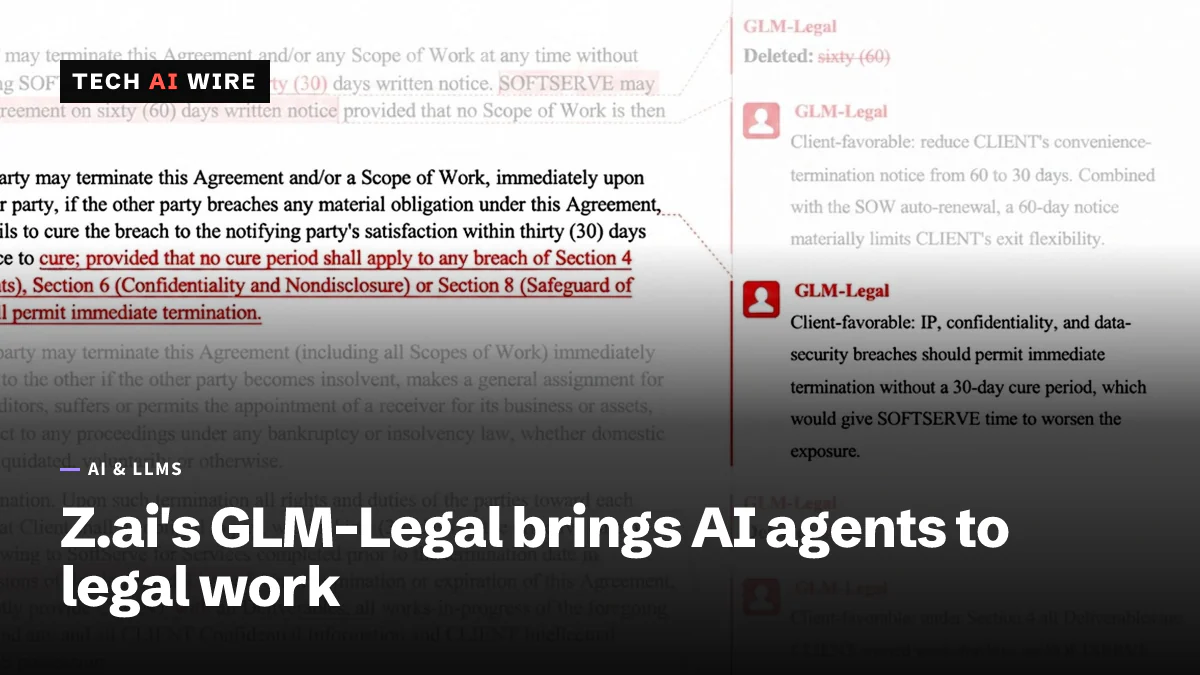
Z.ai stellt GLM-Legal vor, ein KI-Modell für juristische Arbeit
GLM-Legal von Z.ai basiert auf GLM-5.3-Flash und erreicht 19,2 % auf Harvey's Legal Agent Benchmark, gegenüber 6,7 % beim Basismodell. Der Zugang läuft über eine geschlossene API-Beta.