OpenAI Decisions API chega à disponibilidade geral com 400 perguntas por requisição
A Decisions API da OpenAI saiu da beta em 22 de outubro de 2026. Ela continua custando US$ 0,10 por 1 milhão de tokens de entrada e agora aceita até 400 perguntas por requisição.
3 min de leitura
Em números
- per 1M input tokens, with no output charge
- $0.10
- questions per request, double the beta limit
- 400
- response times OpenAI reports, down from 1-3 seconds
- 100-180 ms
- OpenAI's rank on the Artificial Analysis Decision Index
- 14th
A Decisions API da OpenAI chegou à disponibilidade geral em 22 de outubro de 2026, segundo o Unite.AI. A API responde a uma pergunta fixa com uma probabilidade, uma escolha de uma lista ou uma pontuação, em vez de escrever texto. Disponibilidade geral significa que ela saiu da beta, então as equipes podem planejar o uso em produção com base nela. O preço não mudou, mas os limites aumentaram.
O TechCrunch informa que a OpenAI abriu a API para todos os clientes no mesmo dia. A OpenAI a mostrou pela primeira vez em seu dia do desenvolvedor, em 29 de setembro. Antes, ainda em outubro, ela havia chegado à beta pública.
O que mudou desde a beta
O Unite.AI lista quatro novidades desde a beta:
- Mais perguntas por chamada. Uma requisição agora pode levar de 1 a 400 perguntas, o dobro do limite anterior.
- Cache de prompts. Requisições que compartilham um prefixo de pelo menos 1.024 tokens podem reutilizá-lo.
- Residência de dados. O processamento pode ficar nos EUA ou na Europa, ou seja, na EEA mais a Suíça.
- Integração com o GPT-Live. A API agora se conecta ao GPT-Live da OpenAI, segundo o Unite.AI.
Perguntas de pontuação usam uma rubrica com 2 a 10 níveis. O Zero Data Retention e o uso sob a HIPAA continuam disponíveis para clientes elegíveis.
As duas reportagens divergem sobre as entradas. O TechCrunch diz que a versão pública ganhou suporte a voz e imagens. O Unite.AI lista áudio, arquivos, referências a itens e file_id como entradas não suportadas.
Preço e modelo
O preço continua em US$ 0,10 por milhão de tokens de entrada, sem cobrança pela saída, segundo o Unite.AI. Tokens são os pequenos pedaços de texto que um modelo lê. O Unite.AI lista a entrada em cache a US$ 0,01 por milhão de tokens. A documentação da beta não listava cobrança por leituras de cache. Processamento regional e entradas muito longas ainda custam a mais.
A API roda no GPT-6 Luna e, segundo o Unite.AI, ele é o único modelo suportado. O TechCrunch informa que a OpenAI não treinou um modelo de decisão separado. Em vez disso, ela reconfigurou o Luna. Nikunj Handa, líder de produto das APIs da OpenAI, disse ao TechCrunch que a velocidade foi o maior ganho.
Quão rápida ela é, pelos números das próprias empresas
Todos os números de velocidade aqui vêm da OpenAI ou de seus clientes. Nenhum foi medido de forma independente.
| Quem | Afirmação | Informado por |
|---|---|---|
| OpenAI | Tempos de resposta caíram de 1-3 segundos para 100-180 ms | TechCrunch |
| OpenAI | Até 10x mais rápida que o GPT-6 Luna pela Responses API | Unite.AI |
| Speak | O tempo entre ações caiu de 1,4 segundo para 0,13 segundo | Ambos |
| Box | Seleção de rotas cerca de 5x mais rápida, com a mesma precisão | Unite.AI |
| Ramp | 4x mais rápida e 30% mais barata que o GPT-6 Luna | Unite.AI |
| Sierra | Menos de 280 ms no p95, cerca de 3x mais rápida, custo por chamada 90% menor | Unite.AI |
| Datadog | Latência p95 40x mais rápida que a de modelos de fronteira comparáveis | Unite.AI |
P95 significa que 95% das requisições terminaram dentro desse tempo.
Onde ela fica em relação ao Jev
Os modelos de decisão já formam um campo lotado, como mostra nosso explicador sobre modelos de decisão de IA. A OpenAI não está no topo. No AIM System One Index, o Jev, da TypeSafe, ocupa o 7º lugar e o modelo da OpenAI, o 8º, informa o TechCrunch. No Artificial Analysis Decision Index, o Jev fica em 3º e o modelo da OpenAI, em 14º. O TechCrunch não divulga pontuações brutas. A reportagem também cita o D1 Ultra, da Liquid, e o Elephant-1, da Base Lab, como rivais.
O que isso significa para os desenvolvedores
A Decisions API agora é um produto com suporte, e não um teste. Isso muda a forma de tratá-la, mas não se ela é a melhor escolha.
- Agrupe suas perguntas. Com 400 perguntas por requisição, uma única chamada pode classificar uma página inteira de itens. Menos chamadas significam menos sobrecarga por decisão.
- Estruture os prompts para o cache. Coloque suas instruções compartilhadas primeiro e mantenha-as com 1.024 tokens ou mais, para que chamadas repetidas aproveitem o cache.
- Verifique suas entradas. Áudio e arquivos aparecem como não suportados. Teste qualquer fluxo de trabalho com voz ou arquivos antes de construir sobre ele, já que as duas reportagens discordam.
- Faça seu próprio benchmark. O modelo da OpenAI fica abaixo do Jev nos dois índices públicos. Teste a precisão e o custo com seus próprios dados antes de escolher um fornecedor.
- Escolha a região de propósito. Se seus dados precisam ficar na Europa, a opção EEA e Suíça agora existe. O processamento regional custa a mais, então inclua isso no orçamento.
Fontes
Artigos relacionados
Decisions API da OpenAI abre a todos os desenvolvedores em beta
A Decisions API da OpenAI agora está em beta pública. Ela devolve uma probabilidade, uma escolha ou uma pontuação em vez de texto, roda no GPT-6 Luna e custa US$ 0,10 por 1 milhão de tokens de entrada.
Mistral Voxtral 3 traz agentes de voz a partir de US$ 0,0035 por minuto
O Voxtral 3 da Mistral traz voz para texto a partir de US$ 0,0035 por minuto, um modelo de voz a US$ 13 por milhão de caracteres e uma API de agentes de voz a partir de US$ 0,04 por minuto.
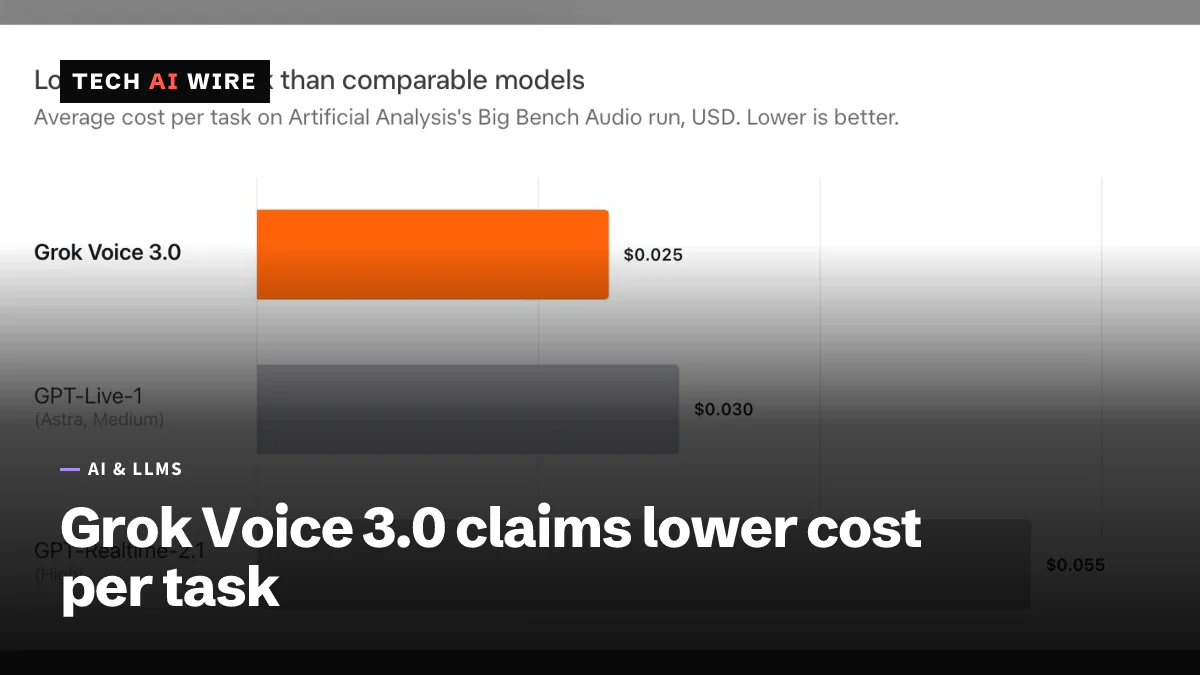
xAI lança o Grok Voice 3.0 a US$ 0,08 por minuto
O modelo de voz Grok Voice 3.0 da xAI custa US$ 0,08 por minuto na Voice Agent API, o mesmo que a versão 2.0, e marca 86,9 no Speech-to-Speech Index da Artificial Analysis.