OpenAI Decisions API passe en disponibilité générale avec 400 questions par requête
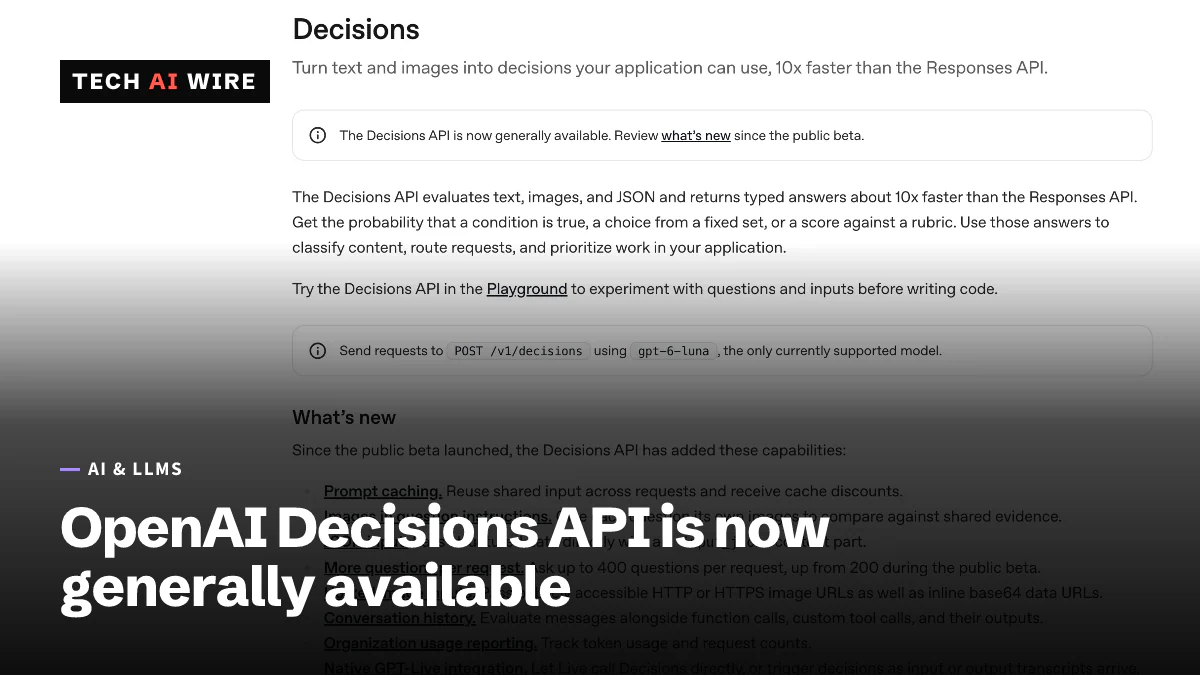
La Decisions API d'OpenAI est sortie de bêta le 22 octobre 2026. Elle coûte toujours 0,10 dollar par million de tokens d'entrée et accepte désormais jusqu'à 400 questions par requête.
3 min de lecture
En chiffres
- per 1M input tokens, with no output charge
- $0.10
- questions per request, double the beta limit
- 400
- response times OpenAI reports, down from 1-3 seconds
- 100-180 ms
- OpenAI's rank on the Artificial Analysis Decision Index
- 14th
La Decisions API d'OpenAI est passée en disponibilité générale le 22 octobre 2026, selon Unite.AI. L'API répond à une question fixe par une probabilité, un choix dans une liste ou un score, au lieu d'écrire du texte. La disponibilité générale signifie qu'elle a quitté la bêta, ce qui permet aux équipes de planifier un usage en production autour d'elle. Le prix n'a pas changé, mais les limites ont augmenté.
TechCrunch rapporte qu'OpenAI a ouvert l'API à tous ses clients le même jour. OpenAI l'avait présentée pour la première fois lors de sa journée développeurs du 29 septembre. Elle était passée en bêta publique plus tôt en octobre.
Ce qui a changé depuis la bêta
Unite.AI liste quatre ajouts depuis la bêta :
- Plus de questions par appel. Une requête peut désormais contenir de 1 à 400 questions, soit le double de la limite précédente.
- Mise en cache des prompts. Les requêtes qui partagent un préfixe d'au moins 1 024 tokens peuvent le réutiliser.
- Résidence des données. Le traitement peut rester aux États-Unis ou en Europe, c'est-à-dire l'EEA plus la Suisse.
- Intégration de GPT-Live. L'API se connecte désormais à GPT-Live d'OpenAI, rapporte Unite.AI.
Les questions de score utilisent une grille d'évaluation de 2 à 10 niveaux. Zero Data Retention et l'usage dans le cadre de HIPAA restent disponibles pour les clients éligibles.
Les deux articles divergent sur les entrées. TechCrunch indique que la version publique a ajouté la prise en charge de la voix et des images. Unite.AI classe l'audio, les fichiers, les références d'éléments et file_id parmi les entrées non prises en charge.
Prix et modèle
Le prix reste de 0,10 dollar par million de tokens d'entrée, sans frais pour la sortie, selon Unite.AI. Les tokens sont les petits morceaux de texte qu'un modèle lit. Unite.AI indique 0,01 dollar par million de tokens pour l'entrée mise en cache. La documentation de la bêta n'indiquait aucun frais pour les lectures en cache. Le traitement régional et les entrées très longues coûtent toujours plus cher.
L'API tourne sur GPT-6 Luna, et selon Unite.AI, c'est le seul modèle pris en charge. TechCrunch rapporte qu'OpenAI n'a pas entraîné de modèle de décision distinct. L'entreprise a plutôt reconfiguré Luna. Nikunj Handa, responsable produit des API d'OpenAI, a déclaré à TechCrunch que la vitesse avait été le plus grand gain.
Sa vitesse, selon les propres chiffres des entreprises
Chaque chiffre de vitesse cité ici provient d'OpenAI ou de ses clients. Aucun n'a été mesuré de façon indépendante.
| Qui | Affirmation | Rapporté par |
|---|---|---|
| OpenAI | Temps de réponse passés de 1-3 secondes à 100-180 ms | TechCrunch |
| OpenAI | Jusqu'à 10 fois plus rapide que GPT-6 Luna via la Responses API | Unite.AI |
| Speak | Temps entre deux actions passé de 1,4 seconde à 0,13 seconde | Les deux |
| Box | Sélection de route environ 5 fois plus rapide, à précision égale | Unite.AI |
| Ramp | 4 fois plus rapide et 30 % moins cher que GPT-6 Luna | Unite.AI |
| Sierra | Moins de 280 ms au p95, environ 3 fois plus rapide, coût par appel inférieur de 90 % | Unite.AI |
| Datadog | Latence p95 40 fois plus rapide que celle de modèles de pointe comparables | Unite.AI |
Le p95 signifie que 95 % des requêtes se sont terminées dans ce délai.
Son classement face à Jev
Les modèles de décision forment désormais un domaine encombré, comme le montre notre explication des modèles de décision d'IA. OpenAI n'est pas en tête. Sur l'AIM System One Index, Jev de TypeSafe se classe 7e et le modèle d'OpenAI 8e, rapporte TechCrunch. Sur l'Artificial Analysis Decision Index, Jev se classe 3e et le modèle d'OpenAI 14e. TechCrunch ne donne aucun score brut. L'article cite aussi D1 Ultra de Liquid et Elephant-1 de Base Lab comme concurrents.
Ce que cela signifie pour les développeurs
La Decisions API est désormais un produit pris en charge, et non plus un test. Cela change la façon de la traiter, mais pas la question de savoir si c'est le meilleur choix.
- Regroupez vos questions. Avec 400 questions par requête, un seul appel peut classer toute une page d'éléments. Moins d'appels signifie moins de surcoût par décision.
- Structurez vos prompts pour le cache. Placez vos instructions communes en premier et gardez-les à 1 024 tokens ou plus, afin que les appels répétés puissent profiter du cache.
- Vérifiez vos entrées. L'audio et les fichiers sont indiqués comme non pris en charge. Testez tout flux de travail vocal ou basé sur des fichiers avant de bâtir dessus, car les deux articles se contredisent.
- Lancez votre propre benchmark. Le modèle d'OpenAI se classe derrière Jev dans les deux index publics. Testez la précision et le coût sur vos propres données avant de choisir un fournisseur.
- Choisissez une région en connaissance de cause. Si vos données doivent rester en Europe, l'option EEA et Suisse existe désormais. Le traitement régional coûte plus cher, prévoyez-le donc dans votre budget.
Sources
Articles liés
La Decisions API d'OpenAI s'ouvre à tous les développeurs en bêta
La Decisions API d'OpenAI est en bêta publique. Elle renvoie une probabilité, un choix ou un score au lieu de texte, tourne sur GPT-6 Luna et coûte 0,10 dollar par million de tokens d'entrée.
Mistral Voxtral 3 ajoute des agents vocaux dès 0,0035 dollar par minute
Voxtral 3 de Mistral ajoute la reconnaissance vocale dès 0,0035 dollar par minute, un modèle de voix à 13 dollars par million de caractères et une API d'agents vocaux dès 0,04 dollar par minute.
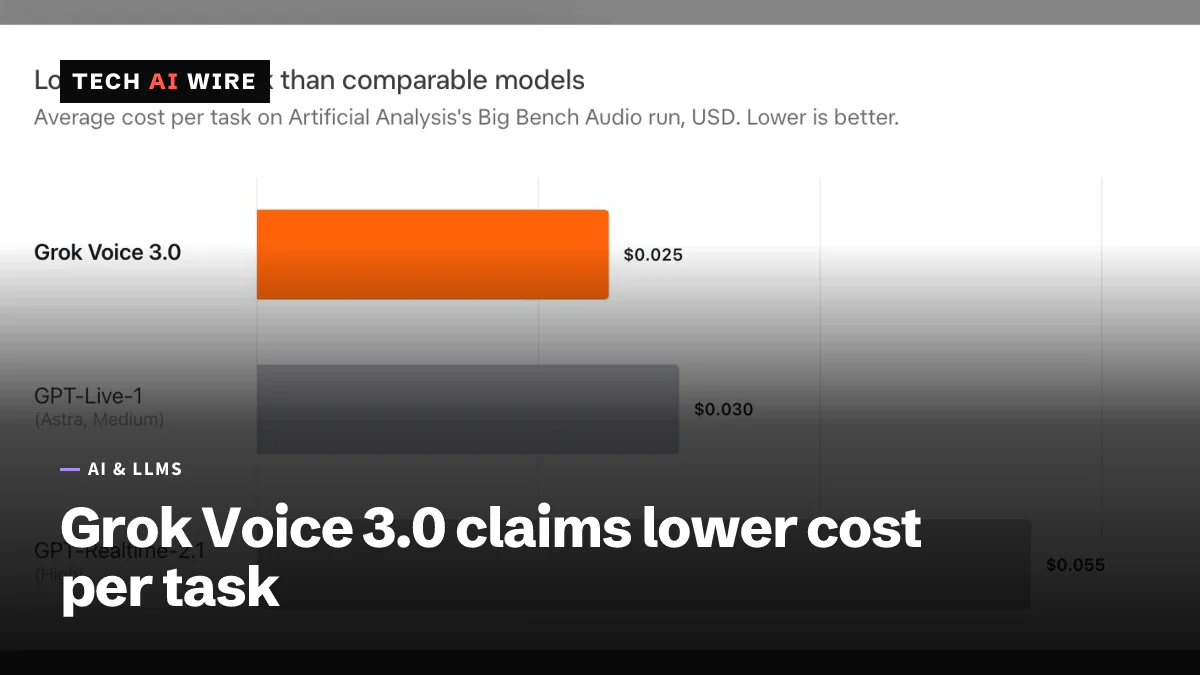
xAI lance Grok Voice 3.0 à 0,08 $ la minute
Le modèle vocal Grok Voice 3.0 de xAI coûte 0,08 $ la minute dans la Voice Agent API, comme la version 2.0. Il obtient 86,9 au Speech-to-Speech Index d'Artificial Analysis.