Decisions API da OpenAI abre a todos os desenvolvedores em beta
A Decisions API da OpenAI agora está em beta pública. Ela devolve uma probabilidade, uma escolha ou uma pontuação em vez de texto, roda no GPT-6 Luna e custa US$ 0,10 por 1 milhão de tokens de entrada.
3 min de leitura
Em números
- per 1M input tokens, with no output charge
- $0.10
- per request in OpenAI's demo, vs 1.6 s via the Responses API
- ~150 ms
- answer types: predicate, choice and score
- 3
- steps right in Every's preview test, vs 73 for Jev
- 76 of 78
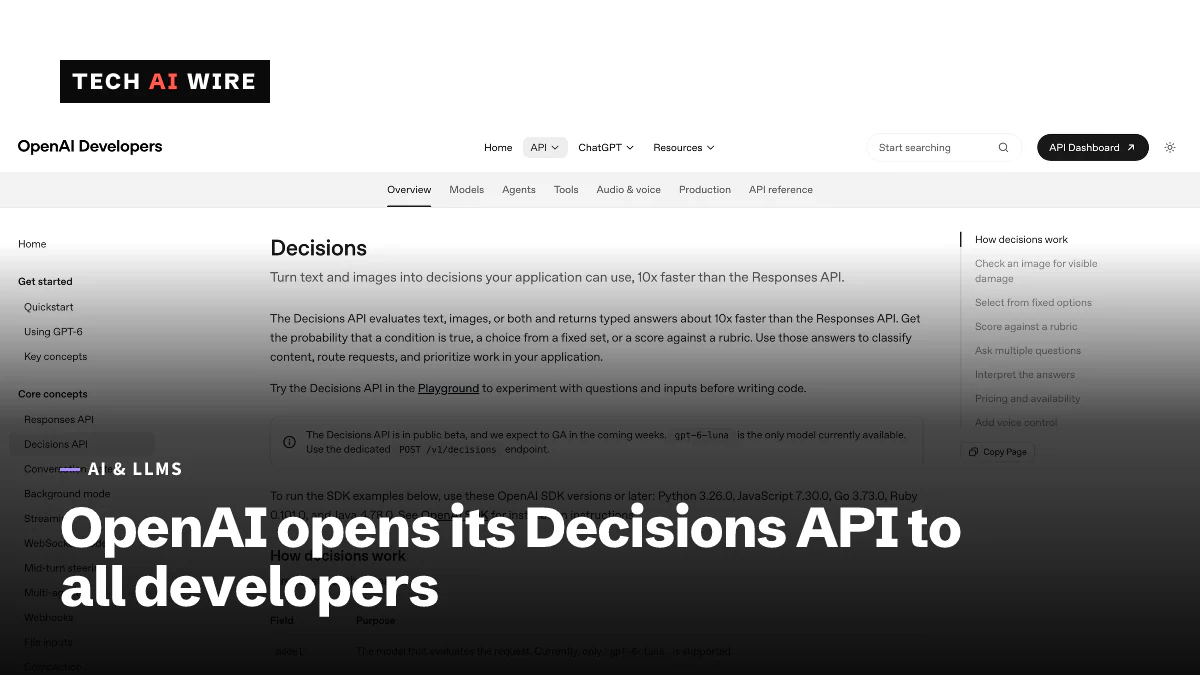
A OpenAI abriu sua Decisions API a todos os desenvolvedores como beta pública em 6 de outubro de 2026, segundo o AlphaSignal. A API não escreve texto. Ela responde a uma pergunta fixa com uma probabilidade, uma escolha em uma lista ou uma pontuação. A OpenAI diz que isso a torna cerca de 10 vezes mais rápida do que fazer a mesma pergunta pela sua Responses API. Para apps que fazem milhares de pequenas escolhas, como direcionar tickets de suporte, velocidade e preço são o ponto central.
O que a Decisions API faz
A maioria dos apps de IA pede a um modelo de linguagem grande, ou LLM, que faça pequenas escolhas o dia todo. Esta mensagem é spam? Qual equipe deve receber este ticket? O modelo escreve a resposta como texto, palavra por palavra, e depois o app a lê de volta.
A Decisions API pula a escrita. Você envia evidências, que podem ser texto, imagens ou ambos, junto com uma pergunta. Ela devolve uma resposta tipada em vez de prosa. A documentação da OpenAI lista três tipos de resposta:
| Tipo de resposta | O que você recebe |
|---|---|
| Predicate (predicado) | Uma probabilidade entre 0 e 1, para perguntas de sim ou não |
| Choice (escolha) | Uma das opções que você forneceu, com probabilidades e um valor de confiança |
| Score (pontuação) | Uma pontuação ponderada por probabilidade ao longo de níveis ordenados, com confiança |
As chamadas vão para um novo endpoint, POST /v1/decisions. O único modelo em que ela roda hoje é o GPT-6 Luna, diz a documentação.
Preço, limites e disponibilidade
A documentação lista um preço de US$ 0,10 por 1 milhão de tokens de entrada. Tokens são os pequenos pedaços de texto que um modelo lê. Não há cobrança por saída, leituras de cache ou gravações de cache. Processamento regional e entradas muito longas custam mais, embora a página não informe esses valores. O AlphaSignal informou, no dia do lançamento, que ainda não havia preços específicos da Decisions publicados. Por isso, o valor pode ter sido acrescentado depois.
Outros detalhes da documentação:
- Status: beta pública, com disponibilidade geral prevista «nas próximas semanas»
- Imagens: precisam ser enviadas inline como data URLs em base64; links para imagens hospedadas e IDs de arquivo não funcionam
- Dados: residência de dados nos EUA e na Europa, além de Zero Data Retention e suporte a HIPAA para clientes elegíveis
- SDKs: Python 3.26.0, JavaScript 7.30.0, Go 3.73.0, Ruby 0.101.0 e Java 4.78.0
Limites de taxa, o tamanho máximo de entrada e o número máximo de opções não são informados.
Quão rápida ela é?
A afirmação sobre velocidade vem de uma demonstração da própria OpenAI. Ela direcionou 10.000 solicitações de clientes entre as equipes de Faturamento, Técnica e Vendas. Cada decisão levou cerca de 150 milissegundos, contra 1,6 segundo pela Responses API, informa o AlphaSignal. A OpenAI não publicou nenhum método para esse teste.
A publicação Every fez verificações iniciais durante a prévia. Em uma reprodução offline de uma tarefa de uso de computador, a Decisions API acertou 76 de 78 etapas, informa o AlphaSignal. O Jev, da TypeSafe, um serviço de decisão concorrente, acertou 73. Na classificação de conversas de mensagens, os dois empataram em precisão e o Jev foi mais rápido. As duas amostras eram pequenas.
Uma nova categoria lotada
A OpenAI mostrou a API pela primeira vez como prévia limitada em 29 de setembro, informa o XenoSpectrum. Ela chega a um campo movimentado. O Jev, da TypeSafe, foi lançado em setembro e afirma levar de 70 a 500 milissegundos por resposta. A Cloudflare veio em seguida com o Clef, modelos de pesos abertos para decisões, e a AWS lançou o Strands Decider 2B.
O XenoSpectrum argumenta que a ideia é menos nova do que parece. O Structured Outputs já consegue forçar um modelo a escolher entre opções fixas. O que muda é uma API separada, feita para muitas chamadas rápidas e repetidas.
O que isso significa para os desenvolvedores
- Migre primeiro suas chamadas de escolha fixa. Roteamento, verificação de spam, guardrails e escolha de ferramentas se encaixam nos três tipos de resposta. Deixe a escrita e o raciocínio para um modelo comum.
- Use a probabilidade como filtro. Aja com base nas respostas de alta confiança e envie as de baixa confiança a um modelo maior ou a uma pessoa.
- Faça seu próprio teste de latência. O número de 150 ms é da OpenAI, sem método publicado. Meça com seu tráfego real antes de redesenhar qualquer coisa em torno dele.
- Orce apenas pela entrada. A US$ 0,10 por milhão de tokens de entrada, sem cobrança de saída, o custo depende de quanta evidência você envia. Encurte prompts longos e redimensione imagens.
- Codifique as imagens antes. URLs de imagens hospedadas são rejeitadas, então converta-as para base64 antes da chamada.
- Trate-a como beta. Fixe a versão do seu SDK e mantenha um caminho alternativo até a disponibilidade geral.
Comece reproduzindo pela API um dia de decisões registradas. Depois, compare as respostas dela com o que seu modelo atual escolheu e verifique com que frequência elas coincidem.
Fontes
- Decisions API guide - OpenAI
- OpenAI's Decisions API Promises Routing Answers 10x Faster for Developers - AlphaSignal
- OpenAI Decisions API preview on GPT-6 Luna - XenoSpectrum
Artigos relacionados
Agents API da OpenAI ganha uso do computador em um navegador hospedado
A Agents API da OpenAI, em beta pública desde 10 de setembro, ganhou uso do computador no DevDay de 29 de setembro de 2026: os agentes operam um navegador hospedado pela OpenAI.

GPT-6 Astra entra em disponibilidade geral no Bedrock e no Copilot
O GPT-6 Astra está em disponibilidade geral no Amazon Bedrock a US$ 10 por milhão de tokens de entrada, e no GitHub Copilot para os planos Pro+, Max, Business e Enterprise.
Amazon Bedrock Managed Agents para OpenAI entra em prévia
A AWS abriu em 29 de setembro de 2026 uma prévia pública do Bedrock Managed Agents: agentes com modelos da OpenAI que rodam dentro da sua própria conta AWS, em três regiões dos EUA.