OpenAI diz que seu chip Jalapeño supera o GB300 da Nvidia por watt
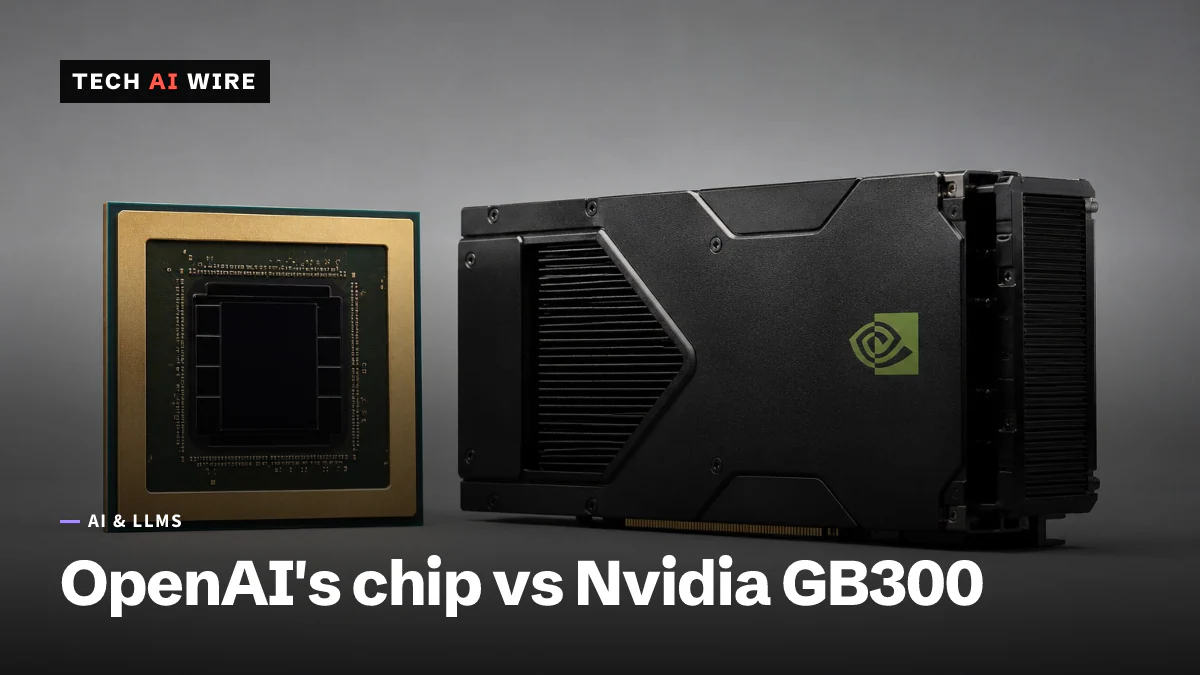
Os primeiros benchmarks publicados do Jalapeño, da OpenAI, alegam 1,5 a 1,9 vezes mais trabalho por quilowatt que o GB300 da Nvidia, com metade da energia. Os números são da própria OpenAI.
4 min de leitura
Em números
- more throughput per kilowatt, per OpenAI
- 1.5-1.9x
- lower end-to-end latency at the top of the range
- 3.6x
- HBM4 memory on each chip
- 216 GB
- from first design to tape-out
- 9 months
- OpenAI Jalapeño
- 700W
- Nvidia GB300
- 1400W
A OpenAI publicou os primeiros benchmarks do Jalapeño, o chip de inferência que construiu com a Broadcom, e diz que ele supera o carro-chefe da Nvidia. O The Register e o TechCrunch relataram os números em 25 de agosto de 2026. A OpenAI alega 1,5 a 1,9 vezes mais trabalho de IA por quilowatt do que sistemas concorrentes, e latência 1,7 a 3,6 vezes menor. O chip tem potência nominal de metade da do GB300 da Nvidia. Se os números se sustentarem fora dos testes da própria OpenAI, o custo de servir um modelo acabou de ganhar um segundo fornecedor.
Inferência é o trabalho de rodar um modelo treinado para responder a requisições, em oposição a treiná-lo. É para onde vai a maior parte da eletricidade de um produto de IA depois que o produto tem usuários. Um chip que faz mais inferência por watt corta a maior linha da conta.
Os números que a OpenAI publicou
O Tom's Hardware relata que o Jalapeño tem potência nominal de 700 watts, contra 1.400 watts do GB300 da Nvidia. Com base nisso, a OpenAI alega até 1,9 vezes a vazão por quilowatt. O The Register acrescenta que, para trabalho de latência ultrabaixa, a vantagem sobe para 2,1 a 4,1 vezes. Ele também estima o consumo de energia do chip em 40% a 60% dos sistemas de GPU concorrentes.
As especificações de um único chip, segundo o The Register:
| Medida | Jalapeño |
|---|---|
| Computação em MXFP4 | 13,4 petaFLOPS |
| Memória | 216 GB HBM4 |
| Largura de banda de memória | 15,4 TB/s |
| Potência nominal | 700 W |
MXFP4 é um formato numérico de 4 bits, que compacta os pesos para que mais do modelo caiba na memória rápida. HBM4 é memória de alta largura de banda, a memória empilhada que fica ao lado do chip. Um rack completo de 128 chips chega a 1,7 exaFLOPS de computação em 4 bits, 27,5 TB de memória e quase 2 petabytes por segundo de largura de banda.
Como ele consegue a velocidade
A aposta do projeto é mover menos dados. Richard Ho, chefe de hardware da OpenAI, disse ao TechCrunch: "Projetamos o Jalapeño para minimizar a movimentação de dados e os atrasos de comunicação." O The Register relata um grande cache SRAM no chip e um posicionamento cuidadoso do KV cache, o armazenamento de tokens passados que um modelo consulta a cada passo.
Isso importa porque a inferência tem duas fases. O prefill lê o prompt inteiro de uma vez, e o decode produz a resposta um token por vez. O decode é a parte lenta, e ele é limitado pela rapidez com que o chip consegue buscar o que já sabe. Manter esses dados perto é o que os números de latência refletem.
O chip também foi construído em um prazo incomum. O The Register relata 9 meses do primeiro projeto até o tape-out, o ponto em que um projeto é congelado para fabricação. Ele o descreve como "projetado (em parte) por IA, para IA". O TechCrunch confirma que os próprios modelos da OpenAI ajudaram no projeto.
Quando você poderia de fato usá-lo
Não tão cedo. O TechCrunch relata que a OpenAI espera implantar o Jalapeño em "volumes muito pequenos" no fim de 2026, com implantação mais ampla em 2027. O projeto foi anunciado pela primeira vez em outubro de 2025, e o TechCrunch o descreve como uma plataforma multigeracional, então este é o primeiro chip de uma linha.
Ho foi direto sobre o que acha que os resultados significam. "O resumo é que os resultados mostram um avanço de desempenho muito, muito significativo sobre o estado da arte", disse ele ao TechCrunch. Ele acrescentou que o Jalapeño "pode servir mais trabalho de IA por unidade de energia, e ao mesmo tempo devolver respostas mais rápido".
O que isso significa para desenvolvedores
Leia cada número com um fato à sua frente: os números vêm da OpenAI. Nenhum laboratório independente os reproduziu ainda, e a comparação é contra a potência nominal publicada pela Nvidia. O primeiro benchmark de um fornecedor sobre o próprio chip é uma alegação, não uma medição. Trate-o como uma razão para observar, não como uma razão para replanejar.
Se você roda inferência em escala, a métrica a roubar é trabalho por quilowatt. A maioria dos times ainda faz orçamento por contagem de GPUs. Energia é a restrição que de fato limita um data center, e é o eixo que a OpenAI escolheu para brigar. Comece a acompanhar tokens por quilowatt-hora da sua própria carga de trabalho agora, para poder avaliar qualquer chip, incluindo este, quando ele for lançado.
Você não vai comprar um Jalapeño. Os relatos descrevem um chip construído para a própria frota da OpenAI, em volumes pequenos no começo. A forma como ele chega até você é pelos preços e pela latência da API da OpenAI, em 2027 na melhor das hipóteses. Se o seu produto depende de decode rápido, observe os números de latência por token da OpenAI no ano que vem para o primeiro sinal real.
O tape-out em nove meses é a parte que vale lembrar. Um laboratório de fronteira projetou um chip de inferência competitivo em menos de um ano, com os próprios modelos ajudando. Se isso se confirmar, silício customizado deixa de ser uma aposta de cinco anos que só as maiores empresas podem fazer. A posição defensável da Nvidia passa a ser software e fornecimento, não eficiência bruta.
Fontes
Artigos relacionados
O chip de inferência Groq 3 LPX da Nvidia entra em produção plena
A Nvidia colocou seu acelerador de inferência dedicado em produção plena: as GPUs cuidam do contexto e os chips novos, da geração de tokens.
Fujitsu MONAKA chega com 144 núcleos Armv9 em novembro
O MONAKA de 144 núcleos da Fujitsu entra em venda em novembro, com núcleos de 2nm empilhados sobre cache de 5nm e suporte já presente no GCC 15.
Agents API da OpenAI ganha uso do computador em um navegador hospedado
A Agents API da OpenAI, em beta pública desde 10 de setembro, ganhou uso do computador no DevDay de 29 de setembro de 2026: os agentes operam um navegador hospedado pela OpenAI.