AMD GAIA 0.25 fasst seine lokalen KI-Agenten zu einem zusammen
AMDs Open-Source-App für lokale Agenten führt nur noch einen Agenten aus, verkleinert ihr Windows-Python-Setup von 0,9 GB auf 0,1 GB und stürzt auf 16-GB-Laptops nicht mehr ab.
3 Min. Lesezeit
Die Zahlen
- Windows Python setup, down from about 0.9GB
- 0.1GB
- to the first reply on Qwen3.6, down from about 43s
- 21s
- default limit before a stalled turn stops
- 75 min
AMD hat am 18. Oktober 2026 GAIA 0.25 veröffentlicht, ein Update seiner Open-Source-App, mit der man KI-Agenten auf dem eigenen PC ausführt. Die Version fasst die verschiedenen Agenten der App zu einem zusammen und verkleinert die Windows-Installation deutlich. Außerdem behebt sie Abstürze auf 16-GB-Laptops, die das Ausprobieren der App auf gewöhnlichen Rechnern erschwert hatten.
Was GAIA ist
GAIA ist AMDs kostenlose App, mit der man KI-Agenten lokal erstellt und ausführt, ohne Daten an einen Cloud-Dienst zu senden. Ein Agent ist ein KI-Modell, das Aktionen ausführen kann, etwa Dateien lesen oder Befehle ausführen, statt nur zu chatten. Das Projekt begann als "Generative AI Is Awesome" und nennt sich heute "AMDs Open-Source-Agentenfabrik", berichtet Phoronix.
Die App zielt auf AMDs Ryzen-AI-Hardware. Version 0.25 liefert Installer für Windows, Linux und Macs mit Apple Silicon sowie ein Python-Paket, laut der GitHub-Release-Seite.
Ein Agent statt vieler
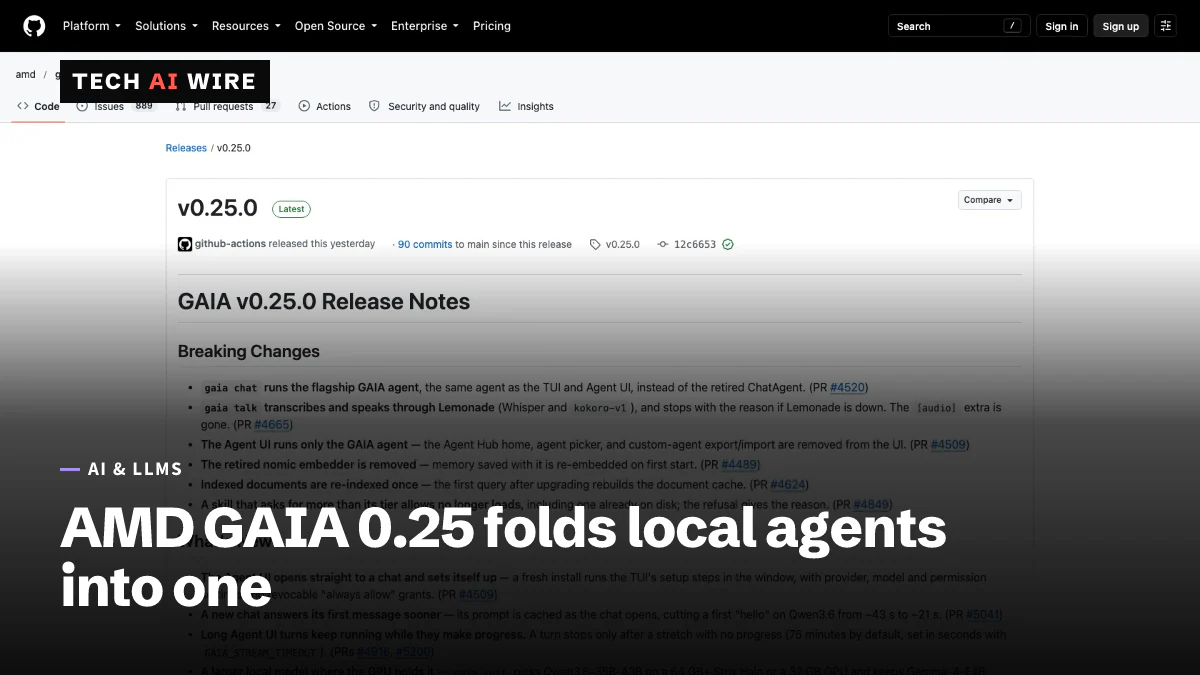
Die größte Änderung bricht mit alten Gewohnheiten. Der Befehl gaia chat startet jetzt den Haupt-Agenten von GAIA, und der ältere ChatAgent wird eingestellt. Auch die Desktop-App führt nur noch diesen einen Agenten aus.
Mehrere Funktionen fielen mit der Änderung weg. Laut Release Notes sind die Startseite Agent Hub, die Agentenauswahl sowie Import und Export eigener Agenten verschwunden. Skills, die mehr Berechtigungen verlangen, als ihre Stufe erlaubt, werden nicht mehr geladen.
Auch die Sprachfunktion ist umgezogen. Der Befehl gaia talk nutzt jetzt für beide Richtungen Lemonade, AMDs lokalen KI-Server. Whisper wandelt Sprache in Text um, und kokoro-v1 liest Antworten vor. Das separate Audio-Zusatzpaket entfällt.
Kleiner, schneller, weniger Abstürze
AMD hat PyTorch, Transformers und Accelerate entfernt, drei große KI-Bibliotheken, die die App nicht mehr brauchte. Dadurch schrumpft die Python-Umgebung der Windows-Desktop-App von etwa 0,9 GB auf etwa 0,1 GB.
Die Korrektur für kleine Rechner ist für neue Nutzer am wichtigsten. Auf PCs mit 16 GB ging der App beim ersten Start der Speicher aus. Laut Phoronix stürzten Linux-Laptops mit 16 GB ab, weil der Kernel den Prozess beendete. GAIA prüft jetzt den freien Speicher, bevor es ein Modell lädt, und verkleinert das Kontextfenster des Modells, also sein Arbeitsgedächtnis, bis es passt.
| Änderung in 0.25 | Vorher | Nachher |
|---|---|---|
| Windows-Python-Umgebung | Etwa 0,9 GB | Etwa 0,1 GB |
| Erste Antwort mit Qwen3.6 | Etwa 43 Sekunden | Etwa 21 Sekunden |
| Agenten in der Desktop-App | Mehrere, mit Auswahl | Ein GAIA-Agent |
Sprache in gaia talk | Separates Audio-Zusatzpaket | Lemonade-Server |
| Limit für hängende Durchgänge | Nicht angegeben | 75 Minuten, einstellbar |
Modellwahl und weitere Korrekturen
Der Einrichtungsbefehl gaia init wählt jetzt ein Modell passend zu Ihrer Hardware. Er nimmt Qwen3.6-35B-A3B auf AMDs Rechnern mit Strix Halo und 64 GB oder mehr oder auf einer Grafikkarte mit 32 GB. Alle anderen Systeme bekommen das kleinere Gemma-4-E4B. Qwen3.8 Flash Next ist auf Strix-Halo-Systemen mit 128 GB optional.
Für die Cloud-Nutzung ist das Standardmodell auf AMDs LLM Gateway und auf Fireworks DeepSeek V4.1 Flash. Die Indexierung von Dokumenten und Gedächtnis läuft jetzt auf dem Grafikchip, was auf Strix Halo etwa 11 CPU-Kerne freimacht.
Weitere Korrekturen zielen auf den Alltag:
- Ein einziger Windows-Installer deckt jetzt sowohl die Desktop-App als auch das Terminal ab.
- Die Einrichtung vertraut dem Zertifikatsspeicher des Betriebssystems und funktioniert daher hinter Firmen-Proxys, die verschlüsselten Datenverkehr prüfen.
- Lehnen Sie eine Aktion ab, versucht der Agent sie nicht mehr über ein anderes Werkzeug erneut.
- Die Terminal-Oberfläche erhält Berechtigungsmodi, die man mit Shift+Tab umschaltet.
- Dokumente werden nach dem Upgrade einmal neu indexiert, weil das Embedding-Modell von Nomic entfernt wurde.
Was das für Entwickler bedeutet
GAIA 0.25 tauscht Flexibilität gegen eine einfachere App, die auf mehr Rechnern läuft. Damit wird es ein besseres Testfeld für lokale Agenten, aber ein schlechteres Zuhause für eigene.
- Passen Sie Skripte an, die ChatAgent aufrufen. Er wird eingestellt. Alles, was auf dem Export oder Import eigener Agenten aufbaut, braucht vor dem Upgrade einen neuen Plan.
- Probieren Sie es auf einem Rechner mit 16 GB aus. Der Speicher war die größte Hürde auf Mittelklasse-Laptops. Rechnen Sie dort mit einem kleineren Kontextfenster, sodass lange Dokumente womöglich nicht hineinpassen.
- Rechnen Sie mit einer einmaligen Neuindexierung. Die erste Frage nach dem Upgrade löst sie aus. Große Dokumentsammlungen brauchen eine Weile.
- Setzen Sie das Timeout für lange Aufgaben. Durchgänge brechen nach 75 Minuten ohne Fortschritt ab. Ändern Sie den Wert in Sekunden über die Einstellung
GAIA_STREAM_TIMEOUT. - Prüfen Sie, was wo läuft. Lokal laufen Qwen3.6 oder Gemma, während in der Cloud standardmäßig DeepSeek V4.1 Flash läuft. Klären Sie, welches Modell Ihre Daten verarbeitet.
Quellen
Ähnliche Artikel
Strands Decider 2B trifft Agenten-Entscheidungen in 115 ms
Strands Decider 2B von AWS ist ein Open-Source-Modell, das aus einer Liste auswählt, statt Text zu schreiben. Auf einer RTX 3090 antwortet es in 115 ms und erreicht 72,3 % bei JevBench.
Microsoft-Decision-1 bewertet Auswahloptionen, statt Text zu schreiben
Microsoft-Decision-1 gibt für jede feste Option eine Wahrscheinlichkeit aus, statt Text zu schreiben. In Microsoft Foundry kostet es 0,042 US-Dollar pro Million Input-Tokens.
Cloudflare Clef: Open-Weight-Modelle, die Entscheidungen liefern
Cloudflares Clef (27B) und Clef-flash (9B) beantworten typisierte Fragen, statt Text zu schreiben, mit 209 ms bzw. 39 ms Median-Latenz und unter Apache 2.0.