AMD GAIA 0.25、ローカルAIエージェントを1つに統合
AMDのオープンソースのローカルエージェントアプリGAIA(ガイア)は、1つのエージェントだけを動かすようになりました。WindowsのPython環境は0.9GBから0.1GBに縮み、16GBのノートPCでもクラッシュしなくなりました。
3 分で読めます
数字で見る
- Windows Python setup, down from about 0.9GB
- 0.1GB
- to the first reply on Qwen3.6, down from about 43s
- 21s
- default limit before a stalled turn stops
- 75 min
AMDは2026年10月18日、GAIA 0.25を公開しました。自分のPCでAIエージェントを動かすためのオープンソースアプリのアップデートです。このリリースでは、アプリにあった複数のエージェントが1つにまとめられ、Windowsでのインストールサイズも大幅に小さくなりました。また、16GBのノートPCでのクラッシュも修正されました。このクラッシュのせいで、普通のマシンではアプリを試しにくくなっていました。
GAIAとは
GAIAは、AIエージェントをローカルで作成・実行するためのAMDの無料アプリです。データをクラウドサービスに送る必要はありません。エージェントとは、チャットするだけでなく、ファイルを読んだりコマンドを実行したりといった行動ができるAIモデルのことです。Phoronixによると、このプロジェクトは「Generative AI Is Awesome」として始まり、今は「AMDのオープンソースのエージェント工場」を名乗っています。
アプリはAMDのRyzen AIハードウェア向けです。GitHubのリリースページによると、バージョン0.25ではWindows、Linux、Apple Silicon搭載Mac向けのインストーラーと、Pythonパッケージが提供されています。
複数ではなく1つのエージェントに
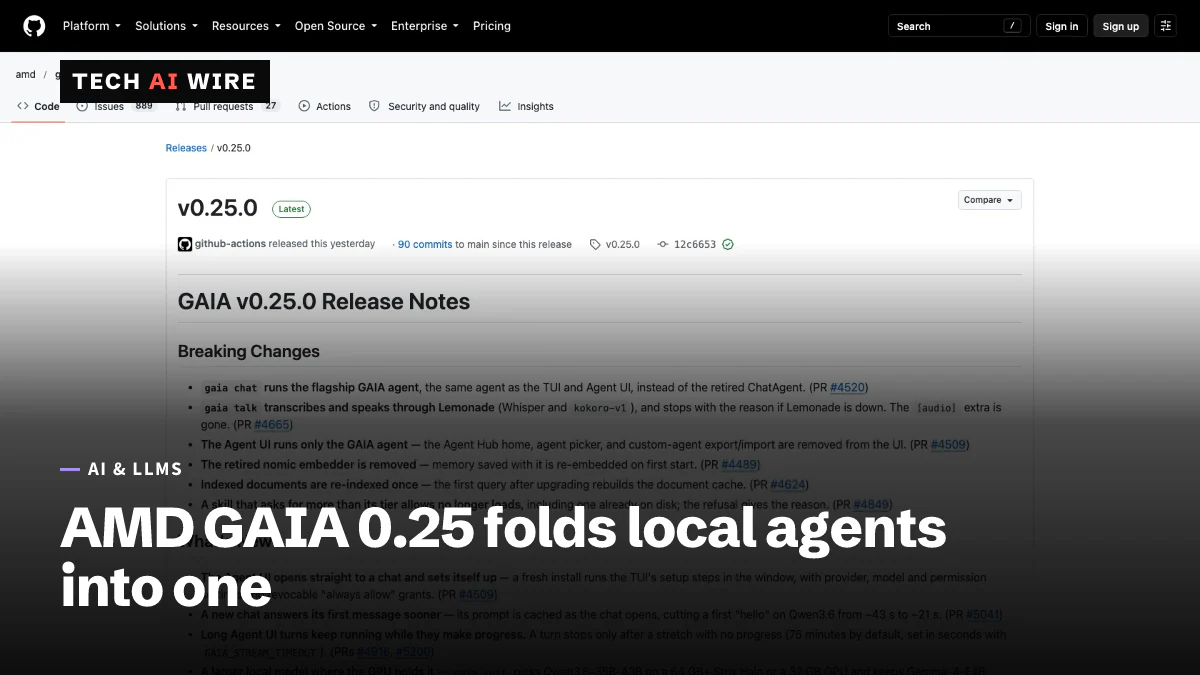
最大の変更は、これまでの使い方を変えるものです。gaia chatコマンドはメインのGAIAエージェントを動かすようになり、以前のChatAgentは廃止されました。デスクトップアプリも、その1つのエージェントだけを動かします。
この変更に伴い、いくつかの機能がなくなりました。リリースノートによると、Agent Hubのホームページ、エージェントの選択画面、カスタムエージェントのインポートとエクスポートが削除されました。自分の階層で許される以上の権限を求めるスキルは、読み込まれなくなりました。
音声機能も移りました。gaia talkコマンドは、入力と出力の両方で、AMDのローカルAIサーバーであるLemonadeを使うようになりました。Whisperが音声をテキストに変換し、kokoro-v1が回答を読み上げます。別になっていた音声アドオンパッケージは削除されました。
より小さく、より速く、クラッシュも減少
AMDはPyTorch、Transformers、Accelerateを削除しました。いずれも、アプリがもう必要としなくなった大きなAIライブラリです。これにより、WindowsデスクトップアプリのPython環境は約0.9GBから約0.1GBに縮みました。
新しいユーザーにとって最も重要なのは、小さなマシン向けの修正です。16GBのPCでは、以前は初回起動時にアプリがメモリ不足になっていました。Phoronixによると、16GBのLinuxノートPCでは、カーネルがプロセスを強制終了してクラッシュしていました。GAIAは今後、モデルを読み込む前に空きメモリを確認し、収まるようにモデルのコンテキストウィンドウ(作業用の記憶)を縮めます。
| 0.25での変更 | 以前 | 以後 |
|---|---|---|
| WindowsのPython環境 | 約0.9GB | 約0.1GB |
| Qwen3.6での最初の応答 | 約43秒 | 約21秒 |
| デスクトップアプリのエージェント | 複数、選択画面あり | GAIAエージェント1つ |
gaia talkの音声 | 別の音声アドオン | Lemonadeサーバー |
| 止まったターンの制限時間 | 記載なし | 75分、調整可能 |
モデルの選択とその他の修正
セットアップコマンドのgaia initは、ハードウェアに合わせてモデルを選ぶようになりました。64GB以上を搭載したAMDのStrix Haloマシン、または32GBのグラフィックスカードでは、Qwen3.6-35B-A3Bを選びます。それ以外のマシンには、より小さいGemma-4-E4Bが使われます。128GBのStrix Haloシステムでは、Qwen3.8 Flash Nextをオプションで選べます。
クラウドで使う場合、AMDのLLM GatewayとFireworksでのデフォルトモデルはDeepSeek V4.1 Flashです。ドキュメントとメモリのインデックス作成はグラフィックスチップで動くようになり、Strix HaloではCPUコアが約11個空きます。
その他の修正は、日常の使い勝手に関わるものです。
- 1つのWindowsインストーラーで、デスクトップアプリとターミナルの両方をカバーするようになりました。
- セットアップがOSの証明書ストアを信頼するようになりました。そのため、暗号化された通信を検査する企業のプロキシの内側でも動きます。
- ユーザーがある操作を拒否すると、エージェントが別のツールを使ってそれを再び試みることはなくなりました。
- ターミナルのインターフェースに権限モードが加わり、Shift+Tabで切り替えます。
- Nomicの埋め込みモデルが削除されたため、アップグレード後にドキュメントが一度だけ再インデックスされます。
開発者にとっての意味
GAIA 0.25は柔軟性と引き換えに、より多くのマシンで動くシンプルなアプリになりました。ローカルエージェントの試験の場としては良くなりましたが、カスタムエージェントの置き場所としては不向きになりました。
- ChatAgentを呼び出すスクリプトを更新してください。 ChatAgentは廃止されました。カスタムエージェントのエクスポートやインポートに頼っているものは、アップグレードの前に新しい計画が必要です。
- 16GBのマシンで試してください。 ミドルレンジのノートPCでは、メモリが主な障壁でした。そうしたマシンではコンテキストウィンドウが小さくなるため、長いドキュメントは収まらないかもしれません。
- 1回限りの再インデックスを想定してください。 アップグレード後の最初の質問で始まります。大量のドキュメントでは時間がかかります。
- 長いジョブにはタイムアウトを設定してください。 ターンは、進展がないまま75分たつと止まります。
GAIA_STREAM_TIMEOUTの設定で、秒単位で変更できます。 - 何がどこで動くかを確認してください。 ローカルではQwen3.6またはGemmaが動き、クラウドのデフォルトはDeepSeek V4.1 Flashです。どのモデルがデータを処理するのかを確かめてください。
出典
関連記事
Strands Decider 2Bはエージェントの判断を115ミリ秒で下す
AWSのStrands Decider 2Bは、テキストを書かずに選択肢から選ぶオープンソースのデシジョンモデルだ。RTX 3090で115ミリ秒で答え、JevBenchで72.3%を記録した。
Microsoft-Decision-1、テキストを書かずに選択肢を採点するモデル
Microsoft(マイクロソフト)のMicrosoft-Decision-1は、テキストを書く代わりに、決められた選択肢ごとに確率を返します。Microsoft Foundryでの料金は、入力100万トークン当たり0.042ドルです。
Cloudflare Clef:文章ではなく判断を返すオープンウェイトモデル
CloudflareのClef(クレフ、27B)とClef-flash(9B)は、文章を書く代わりに型付きの質問に答えます。レイテンシの中央値は209ミリ秒と39ミリ秒で、ライセンスはApache 2.0です。