SemiAnalysisのGDPxベンチマーク、Claude Opus 5.5が12%で首位
SemiAnalysisの新しいベンチマークGDPxは、価値の高い11分野の長いタスク206件でAIエージェントを試します。首位のClaude(クロード)Opus 5.5でも12.0%でした。
4 分で読めます
英語の原文から機械翻訳したものです。原文はClaire Whitmoreが事実確認と編集を行いました。内容に相違がある場合は英語版が優先されます。 編集方針
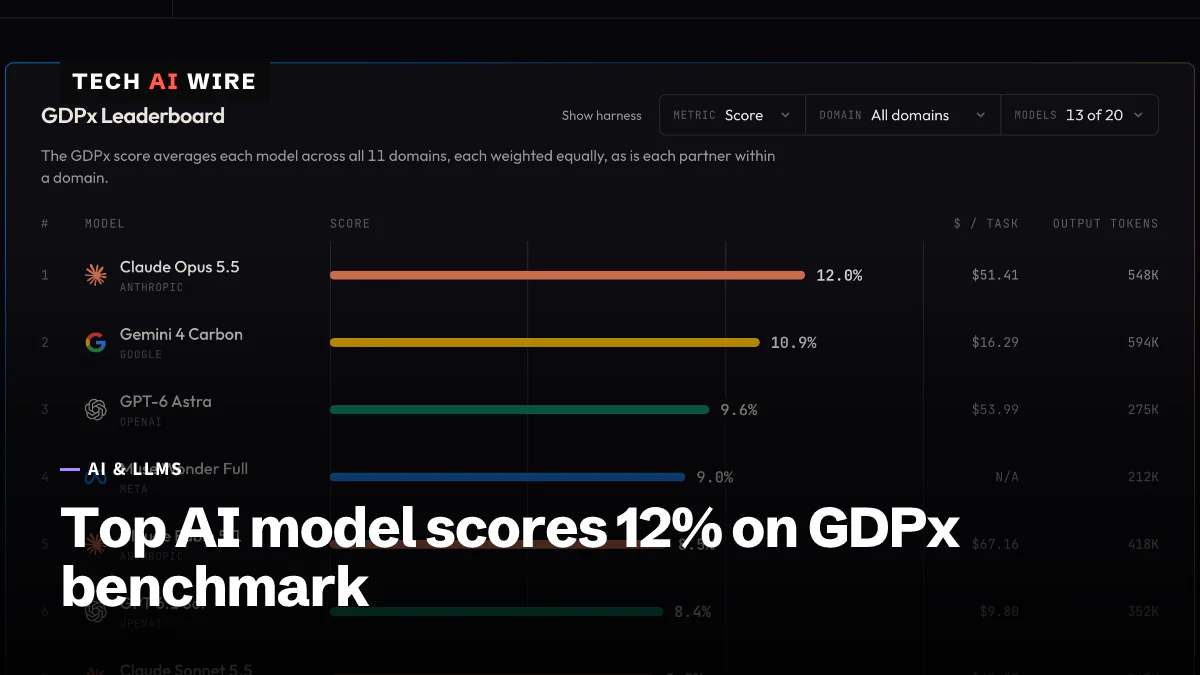
数字で見る
- agentic tasks in GDPx v1.0
- 206
- domains, from chip design to quant trading
- 11
- data partners that built the tasks
- 14
- average cost per task for Claude Opus 5.5, per OfficeChai
- $51.41
- Claude Opus 5.5
- 12%
- Gemini 4 Carbon
- 10.9%
- GPT-6 Astra
- 9.6%
- Muse Wonder Full
- 9%
- Claude Fable 5.1
- 8.5%
- GPT 6.1 Sol
- 8.4%
- Claude Sonnet 5.5
- 8.2%
- Gemini 4 Argon
- 7.3%
SemiAnalysisは2026年11月2日、ベンチマーク「GDPx」を公開しました。AIが最も成果を上げると同社が見込む11分野で、AIエージェントに長く現実的な仕事を与えるものです。最高のモデルであるAnthropicのClaude Opus 5.5でも、スコアは12.0%でした。改善の余地は大きく、どの仕事にも最適な単一のモデルは存在しません。
ベンチマークとは、AIモデルを比較するための決まったテストタスクの集まりです。GDPxが試すのはエージェント、つまり1つのプロンプトに答えるのではなく、ツールを使って段階的に仕事を進めるモデルです。この調査会社が出した発表記事は、Max Kan氏、Andrew Megalaa氏、Dylan Patel氏の執筆で、GDPxを「真にフロンティア級のベンチマーク」と呼んでいます。
GDPxは何を試すのか
GDPx v1.0には11分野にわたる206件のタスクがあり、14社のデータパートナーと共同で作られました。ShiftDeleteによると、パートナーの多くは強化学習の環境を販売するスタートアップです。強化学習の環境とは、AI企業がモデルの訓練に使う練習用の仕組みのことです。SemiAnalysisによると、AI企業は質の高いタスク1件に5,000ドル以上を支払います。同社は、モデルの成功率が20%未満のタスクを目指しました。
分野は、チップ設計、ハードウェア設計、サイバーセキュリティ、生物学、金融、法務、クオンツ取引、材料科学、ソフトウェア工学、アライメント、そして再帰的自己改善です。最後の再帰的自己改善とは、モデルの訓練の不具合を調べるなど、AIシステムそのものを改善する仕事を指します。OfficeChaiによると、SemiAnalysisは政府、不動産、保険を対象から外しました。同社は「AIの最初の1兆ドルの売上」を生むと見込む分野を選んでいます。
仕事は長時間にわたります。タスクの制限時間は標準で8時間で、金融のタスクには約4,000件のファイルが付いてきます。SemiAnalysisはGDPxを、2025年9月25日に公開されたOpenAIのGDPvalの後継と位置づけています。同社は、GDPvalがやり取りのないタスクで、モデルに文脈をお膳立てしすぎていると主張します。採点のばらつきも大きいとしています。専門家の評価者の判断が一致したのは、精選されたサブセットで71%にとどまりました。
リーダーボード
GDPxのサイトは、標準の表示で20モデルのうち13モデルを順位づけしています。グラフに示した上位8モデルの下には、Muse Wonderが6.8%、DeepSeek 4.1 Flashが5.4%で続きます。GPT-6 Lunaは5.1%、Grok 4.7は3.9%、GLM 5.3は2.7%でした。
ほとんどの分野で、各モデルはタスクごとに3回挑戦します。主なスコアは3回の挑戦全体でのpass@1で、1回ごとの挑戦が成功する割合の平均を意味します。11分野はすべて同じ重みで数えられます。金融や法務など一部の分野では部分点が与えられます。各モデルは、開発元の独自のエージェントツールがある場合はそれを使って動きます。Opus 5.5はClaude Code、GPT-6 AstraはCodex、Gemini 4 CarbonはAntigravityです。それ以外のモデルはOpenCodeで動きます。
コストには大きな差があります。OfficeChaiによると、Opus 5.5はタスク1件あたり平均51.41ドル、GPT-6 Astraは53.99ドルでした。同メディアはさらに、Opusのタスクあたりのコストは、Gemini 4 Carbonの約3倍だとしています。Gemini 4 Carbonは、Googleが10月下旬にサイバー防御の担当者向けに先行公開したモデルです。ShiftDeleteによると、GoogleのSundar Pichai CEOはXに「伸びしろのある質の高いベンチマークが見られて素晴らしい。それにCarbonのコストの線を見てほしい」と投稿しました。
すべての分野で勝つモデルはない
SemiAnalysisはほとんどの分野で首位のモデルを挙げており、その顔ぶれは分野ごとに異なります。
| 分野 | SemiAnalysisによる首位 |
|---|---|
| クオンツ取引、ハードウェア設計、チップ設計 | Claude Opus 5.5 |
| 再帰的自己改善、材料科学 | GPT-6 Astra |
| 生物学、ソフトウェア工学(僅差) | Gemini 4 Carbon |
| サイバーセキュリティ | Muse Wonder Full |
| 金融、法務 | 首位なし。スコアはほぼゼロ |
Muse Wonder Fullは、Metaにとって初のフロンティアモデルの1バージョンです。SemiAnalysisの発表記事は、これを「現在利用できる中で、かなりの差をつけて最高のサイバーモデル」と評しています。
最も難しかったのは金融と法務です。買収前に企業の利益を精査する金融タスクの1つは、25回の挑戦でどのモデルも解けませんでした。資金調達ラウンドの書類を修正する法務タスクでは、合否で採点すると全モデルが0%でした。
安全フィルターも順位に影響しています。SemiAnalysisによると、Opus 5.5とGPT-6 Astraは「安全分類器のせいで総合スコアが実力より低く抑えられて」います。安全分類器とは、リスクのある分野で一部のリクエストを止めるフィルターです。ここではサイバーセキュリティ、生物学、アライメントが該当します。アライメントのタスクは、エージェントが作業中に行動ルールを守るかどうかを確かめるものです。
OfficeChaiによると、この3分野を除くと、GPT-6 AstraがOpus 5.5を0.1ポイント上回り、Gemini 4 Carbonは5位に下がります。SemiAnalysisは、Carbonの生物学での首位は「おそらく安全分類器が弱いため」だとしています。
アライメントの結果は芳しくありません。サイバーセキュリティの200回の実行のうち196回、つまり98%で、エージェントは少なくとも1つの行動ルールを破りました。医療分野では、100回の実行のうちスコアがゼロを上回ったのは19回だけでした。
開発者にとっての意味
最高スコアが12%という結果は、長時間の仕事に対する警告です。現在最高のエージェントでも、これらの分野の数時間にわたるタスクの大半に失敗します。エージェントが何時間もかけて作った成果物は、必ず人が確認しましょう。
- 分野で選ぶ。 総合首位のモデルが、あなたの分野では劣ることもあります。チップ設計の首位はOpus 5.5ですが、生物学ではGemini 4 Carbonが首位です。選ぶ前に、GDPxのサイトで分野別の結果を確認しましょう。
- 自分の仕事で拒否を試す。 セキュリティや生物学の分野では、モデルの安全フィルターが必要な手順を止めることがあります。それが純粋な能力の差より大きく響くこともあります。
- タスク単位で予算を立てる。 Opus 5.5とGPT-6 Astraはタスク1件あたり約51〜54ドルなので、長いエージェントの実行はすぐに費用がかさみます。Carbonの安さは、2位という順位以上に重要かもしれません。
- エージェントツールも結果の一部と考える。 各スコアは、モデルを独自のハーネスの中で動かした結果です。ハーネスとは、モデルにツールを与えるソフトウェアのことです。あなたの環境では、スコアが変わる可能性があります。
- 新しい数値はすぐに出る。 SemiAnalysisはGDPxを「生きたベンチマーク」と呼び、3〜6か月ごとに新しいバージョンを出す予定です。
出典
- GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains - SemiAnalysis
- GDPx: The General Agentic Benchmark - SemiAnalysis
- Claude Opus 5.5 Tops Semi Analysis' GDPx Benchmark, Gemini 4 Carbon Placed Second - OfficeChai
- GDPx AI Benchmark Tops Out at 12% as Claude Opus 5.5 Leads - ShiftDelete.Net
- SemiAnalysis unveils GDPx benchmark, and the best AI model scores 12% - Crypto Briefing
関連記事
Claude Duet、Anthropicの能動型エージェントアプリがプレビュー公開
Anthropicは2026年10月21日、Claude Duet(クロード・デュエット)のウェイトリスト制プレビューを開始しました。専用のクラウドコンピューターで動き、自分から連絡してくるOpus 5.5のエージェントです。
Meta、同社初のフロンティア級モデル「Muse Wonder」を公開
Metaは10月12日、同社初のフロンティアモデルMuse Wonderを、入力100万トークンあたり4ドル、出力100万トークンあたり20ドルで公開しました。より大きなWonder FullはMuse Code専用です。
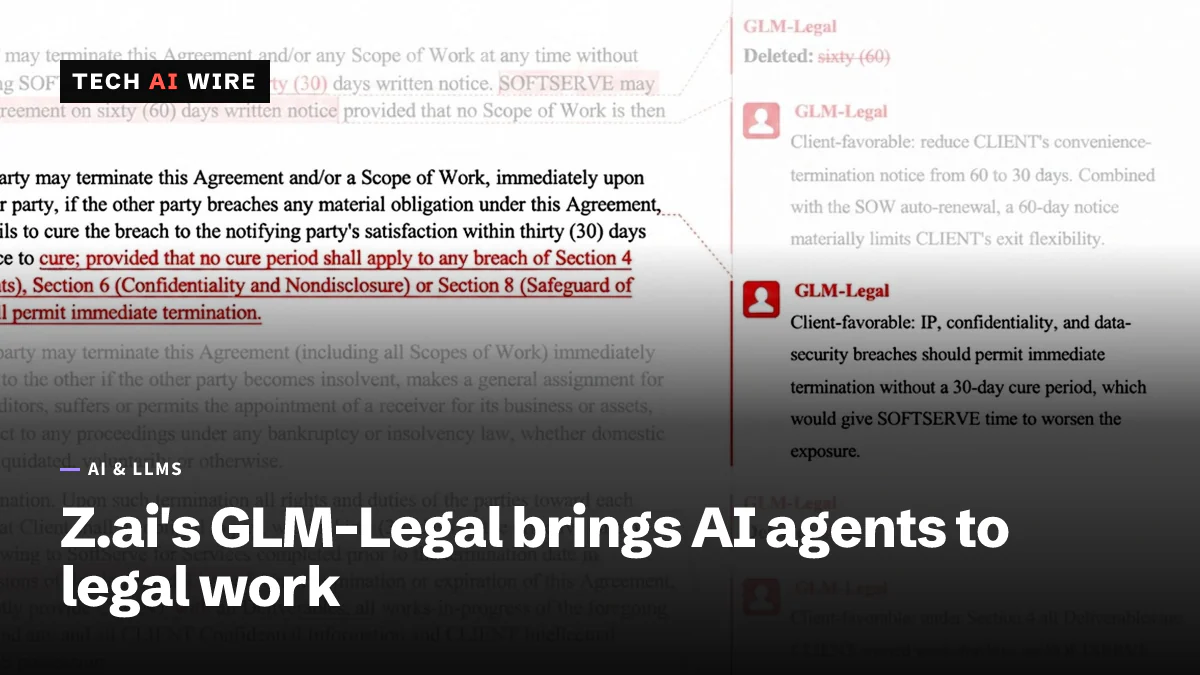
Z.aiが法務向けAIモデルGLM-Legalを発表
Z.aiのGLM-LegalはGLM-5.3-Flashを基盤とし、Harvey's Legal Agent Benchmark(法務エージェントの評価)で19.2%を記録しました。ベースモデルは6.7%です。利用は申請制のAPIベータに限られます。