Z.aiが法務向けAIモデルGLM-Legalを発表
Z.aiのGLM-LegalはGLM-5.3-Flashを基盤とし、Harvey's Legal Agent Benchmark(法務エージェントの評価)で19.2%を記録しました。ベースモデルは6.7%です。利用は申請制のAPIベータに限られます。
4 分で読めます
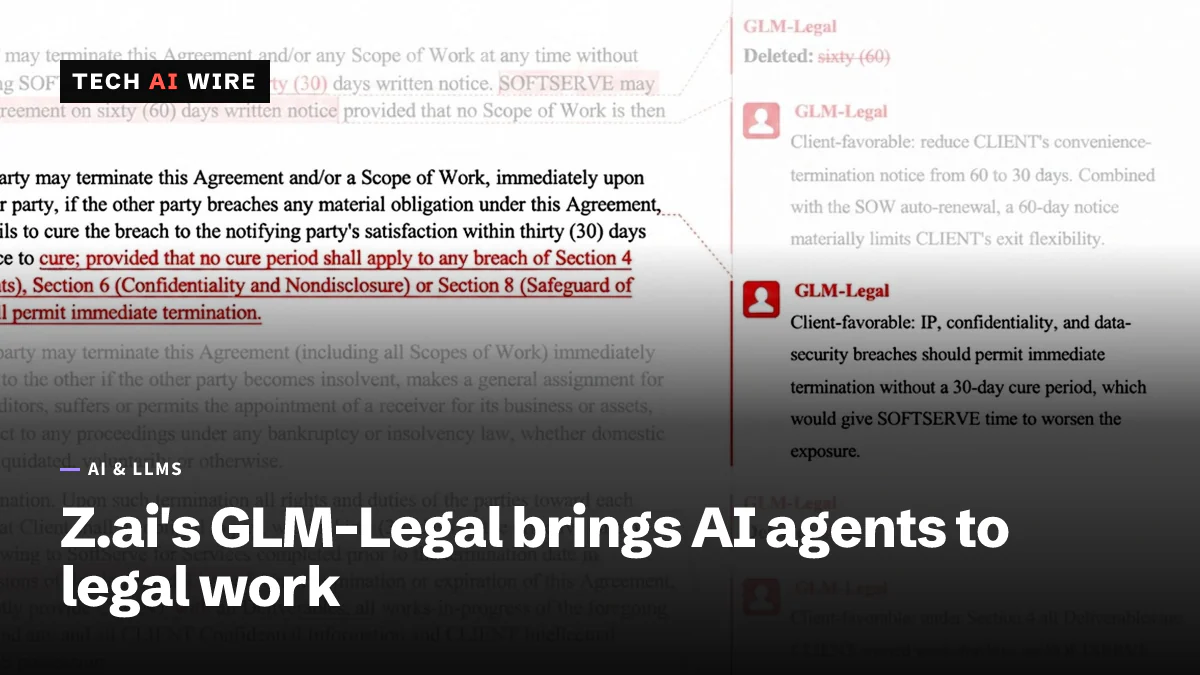
GLMシリーズのAIモデルを手がけるZ.aiは、2026年10月12日にGLM-Legalを発表しました。これは同社のGLM-5.3-Flashモデルを、契約書レビュー、証拠分析、コンプライアンス調査などの法務作業向けに訓練したバージョンです。Z.aiによると、Harvey's Legal Agent Benchmarkでのスコアは19.2%で、ベースモデルの6.7%から向上しました。現時点では、利用は企業が申し込む必要のあるベータ版に限られています。
GLM-Legalとは
Z.aiの発表によると、GLM-Legalは「軽量なGLM-5.3-Flashを基盤に構築」されています。Z.aiは8月にGLM-5.3-Flashをオープンウェイトで公開しました。AlphaSignalは、このベースモデルをmixture-of-experts(専門家混合)型の設計としています。これは処理する単語ごとに、モデルの一部だけを使う方式です。総パラメータ数は3200億で、一度に動くのは180億です。公称のコンテキストウィンドウは100万トークンです。
Z.aiのページには、GLM-Legal自体のサイズは書かれていません。クローズドなフロンティアモデルより「大幅に少ないパラメータ規模」で動くとだけ述べています。
学習は2段階で行われました。まずZ.aiは、より大きな法務テキストの集合でモデルを追加学習させました。次に、良い結果に報酬を与える手法である強化学習を、「数万件の現実的な法務環境」で用いました。Z.aiは、エージェントとそのツールを動かすソフトウェアである「Harness」と一緒にモデルを構築しました。「Harnessのアーキテクチャとモデルの学習は、歩調を合わせて改良を重ねる」と投稿は述べています。Unite.AIは、ある段階で法律の専門家からのフィードバックを学習シグナルに変えていると付け加えています。
Z.aiは法務を選んだ理由をこう説明しています。「法務の仕事にはこうした課題が集中しており、リスクの高い専門的な環境で動くようモデルを訓練するための理想的なストレステストになります。」
GLM-Legalのベンチマークスコア
Z.aiは、GLM-Legalをベースモデルおよび競合する3つのモデルと比べたグラフを公開しました。以下の数値はすべてそのグラフによるものです。
| ベンチマーク | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey's Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
AlphaSignalによると、Harveyのベンチマークは、計画とツールの使用が必要な複数ステップの法務ワークフローをテストします。Z.aiは、24の業務分野を扱っていると述べています。スコアは全項目合格率です。タスクは、回答がすべての採点基準を満たした場合にのみカウントされます。LegalBenchは、単一の法的推論タスクをテストします。Z.aiによると、PLawBenchは中国の法務実務を対象とし、相談、事案分析、文書作成を扱います。
GLM-Legalは、Harveyのベンチマークでグラフの首位に立っています。LegalBenchではKimi K3と並び、Claude Fable 5とGPT-6 Astraには及びません。PLawBenchでは、Claude Fable 5に0.4ポイント届きません。Z.aiはこれらの結果を「最先端のクローズドソースモデルに匹敵する」としています。
ベースモデルの数値は、外部のテストと一致しています。AlphaSignalは、評価会社Vals AIによるGLM-5.3-Flashのスコアを公開しました。LegalBenchで83.93%、Harveyのベンチマークで6.7%です。
利用方法
GLM-Legalはベータ版です。APIを利用するには、Z.aiのサイトで申請フォームを提出する必要があります。Z.aiは、法律事務所、リーガルテック企業、社内法務チーム、独立した実務家に参加を呼びかけています。Z.aiとUnite.AIはどちらも、このモデルが「近く」Z.aiのデスクトップ向けエージェントアプリAutoClawに搭載されると述べています。AlphaSignalによると、AutoClawの新規ユーザーには2億のプロモーション用トークンが付与され、Z.aiはその価値を24ドルとしています。
いくつかの点は公開されていません。価格、GLM-Legalのライセンス、重みが公開されるかどうか、提供地域、レート制限、データの保持期間などです。AlphaSignalによると、ベースモデルはMITライセンスを採用しています。
デモが示すもの
Z.aiの投稿では、GLM-Legalとベースモデルを比べる3つのデモが紹介されています。
- 契約書レビュー: モデルが、ソフトウェアサービス契約の解除条項と引き継ぎ条項を修正します。AutoClawは、その修正を「変更履歴とコメント付きで」Wordに書き込みます。
- 証拠分析: 紛争に関する40件の文書を通して、ある事業者の進捗報告書にある矛盾を見つけます。各指摘には文書のBates番号が引用されます。これは、訴訟で共有されるファイルに弁護士が押すIDです。
- コンプライアンス調査: シンガポール、マレーシア、インドネシアで公開されるWebサイトのプライバシー計画を作成し、各国のデータ保護法の条項を引用します。
開発者にとっての意味
- スコアはベンダーの主張として扱うこと。 ベンチマークを選び、比較を行ったのはZ.aiです。GLM-Legalを基盤に開発する前に、自社の文書で試してください。
- 人によるレビューを前提にすること。 全項目合格率19.2%とは、複数ステップのタスクの約5件に4件が、少なくとも1つのチェックで不合格だったことを意味します。これを使って作る法務ツールには、引き続き弁護士の関与が必要です。
- 顧客のファイルを送る前にデータについて確認すること。 データの保持期間と提供地域は公開されていません。ベータ期間中に、どちらも書面で確認してください。
- 法域を確認すること。 PLawBenchは中国の実務を、デモは東南アジアを対象としています。ユーザーが従う法律には、結果が当てはまらない可能性があります。
- セルフホスティングはベースモデルから。 GLM-5.3-FlashはMITライセンスのオープンウェイトです。GLM-Legalは今のところ申請制のAPIでしか提供されていないため、モデルを社内で運用しなければならないチームはまだ使えません。
出典
関連記事
Claude Haiku 5.5、Haiku 4.5より価格を90%引き下げ
Claude(クロード)Haiku 5.5の価格は100万トークンあたり入力0.10ドル、出力0.50ドルで、Haiku 4.5より90%安くなりました。Terminal-Bench 4.0では0%から39.2%に伸びました。
Microsoft ThinkingBox、AIエージェントをデータベースで採点
MicrosoftのThinkingBox(シンキングボックス)は、AIエージェントがデータベースに書き込んだ内容を確認します。失敗した79,853回の実行のうち67.24%は、有効なツール呼び出しで正常に終わり、データは誤っていました。
Claude Sonnet 5.5、半額でOpus 5.5に迫る性能
Claude(クロード)Sonnet 5.5は、Terminal-Bench 4.0で70.6%を記録しました。価格は100万トークンあたり2ドル/10ドルで、Opus 5.5の半額です。Sonnet 4.5は2026年11月30日に提供終了します。